AWS Glue आणि Athena: S3 Data Lakes वर ETL आणि SQL सोप्या भाषेत
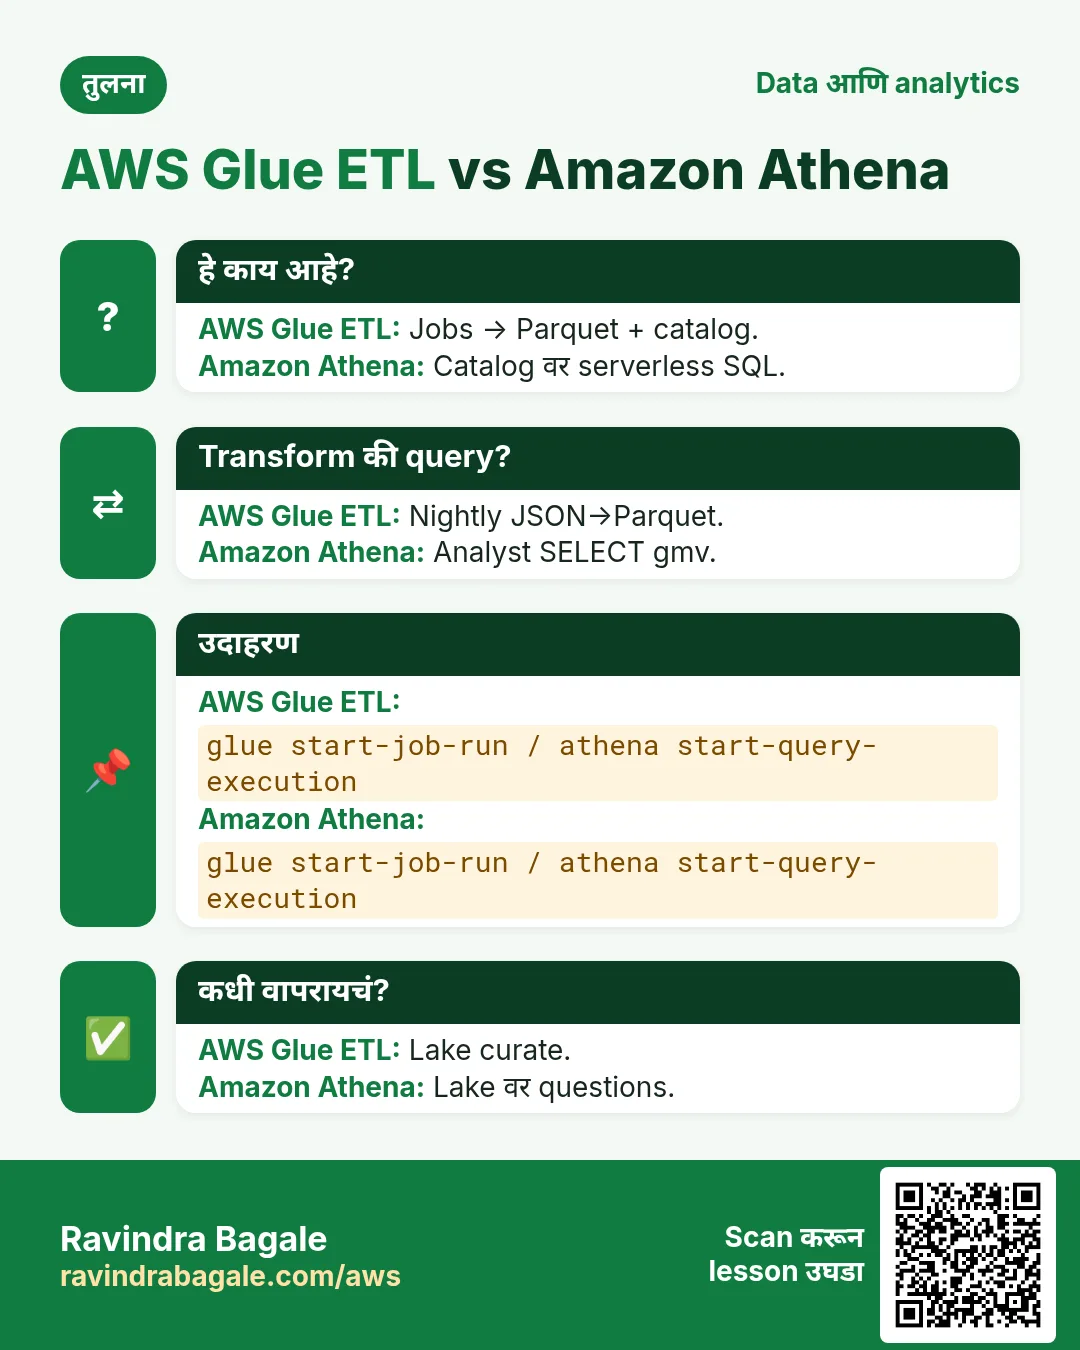
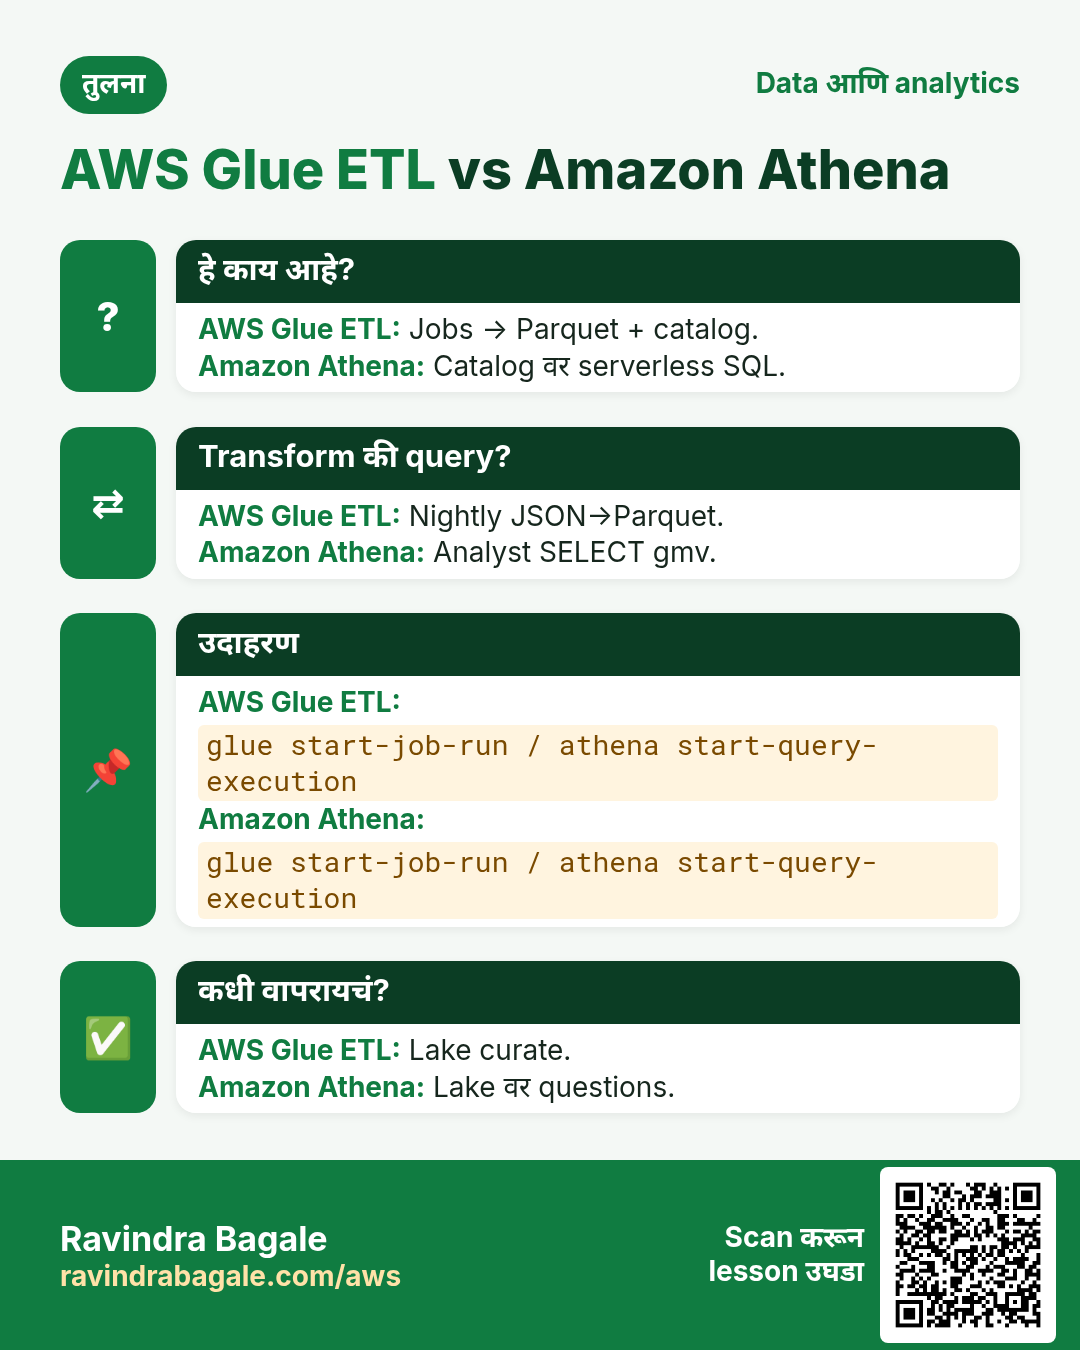
S3 lake = CSV/Parquet. Glue = catalog + transform; Athena = SQL on S3. Broom + notebook.
या chapter मध्ये तुम्ही काय शिकाल
- Catalog का
- Crawler/job/catalog
- Athena SQL + cost
- Partitions + formats
- Lab, errors, FAQ, interview
1. आधी रोजचं उदाहरण
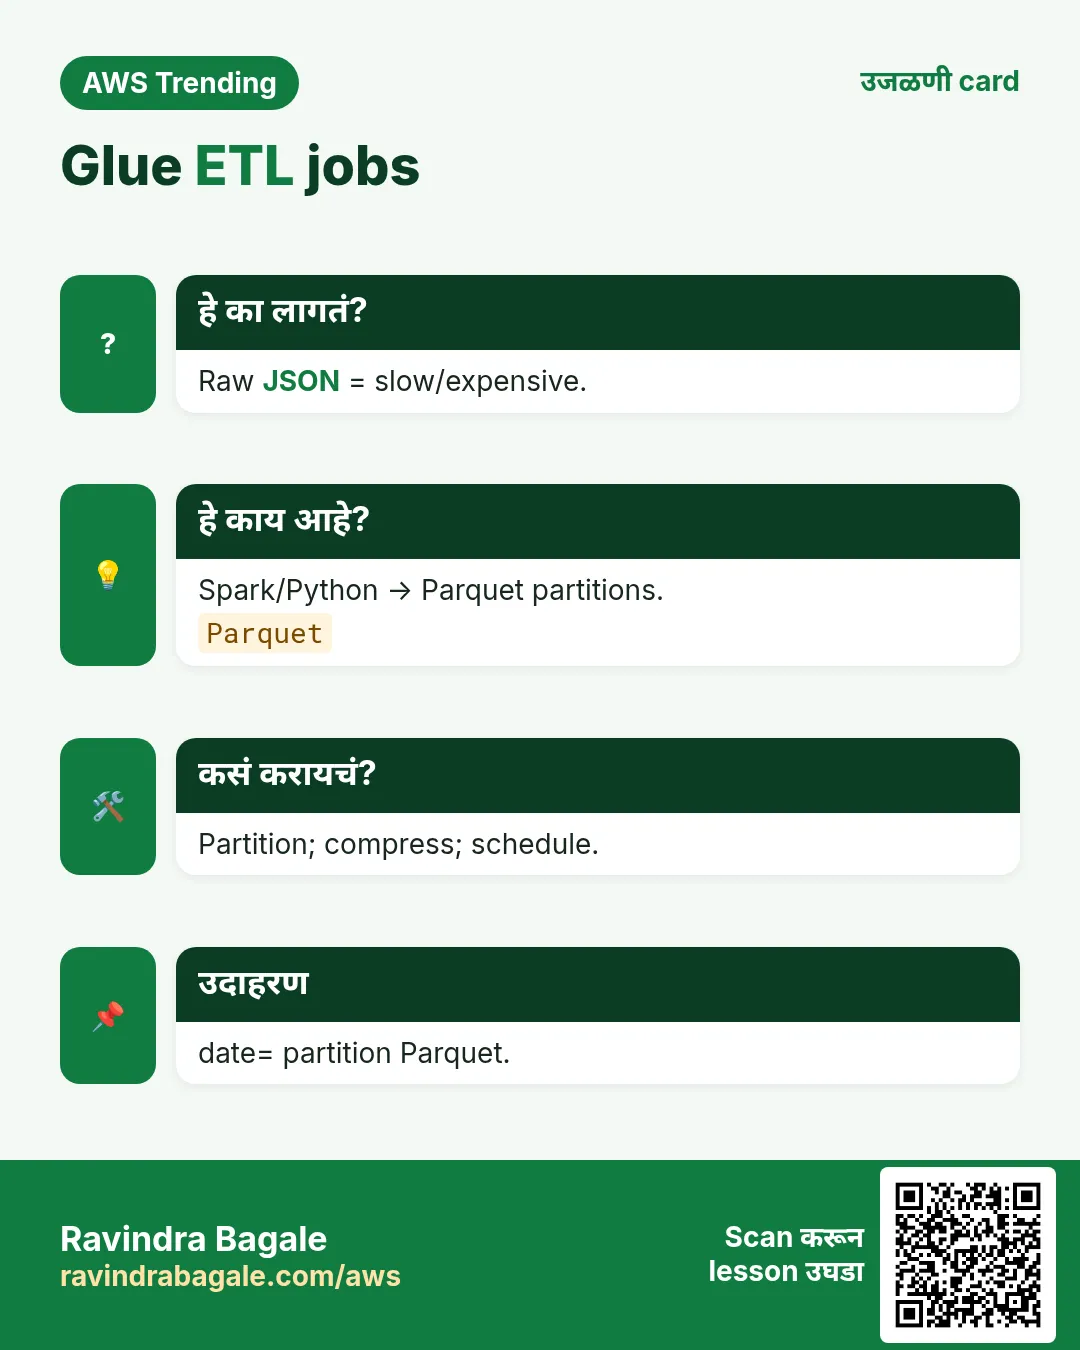
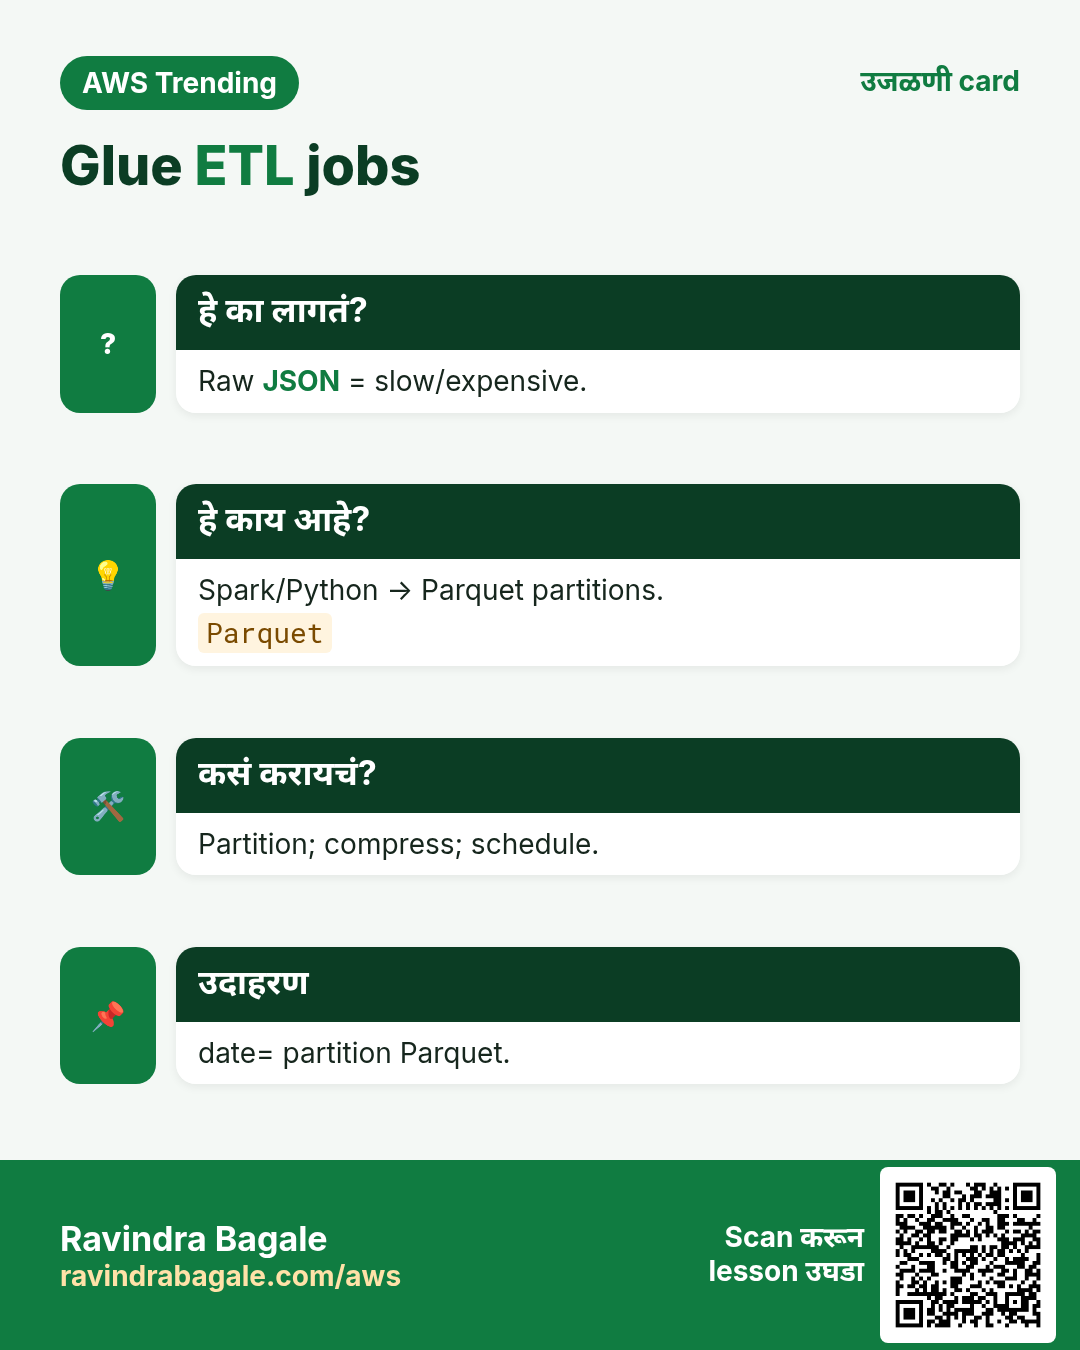
Retail: daily Parquet → S3. Glue crawler table update. Analyst Athena SQL; pay per scan — partitions महत्त्वाच्या.
2. Glue + Athena का?
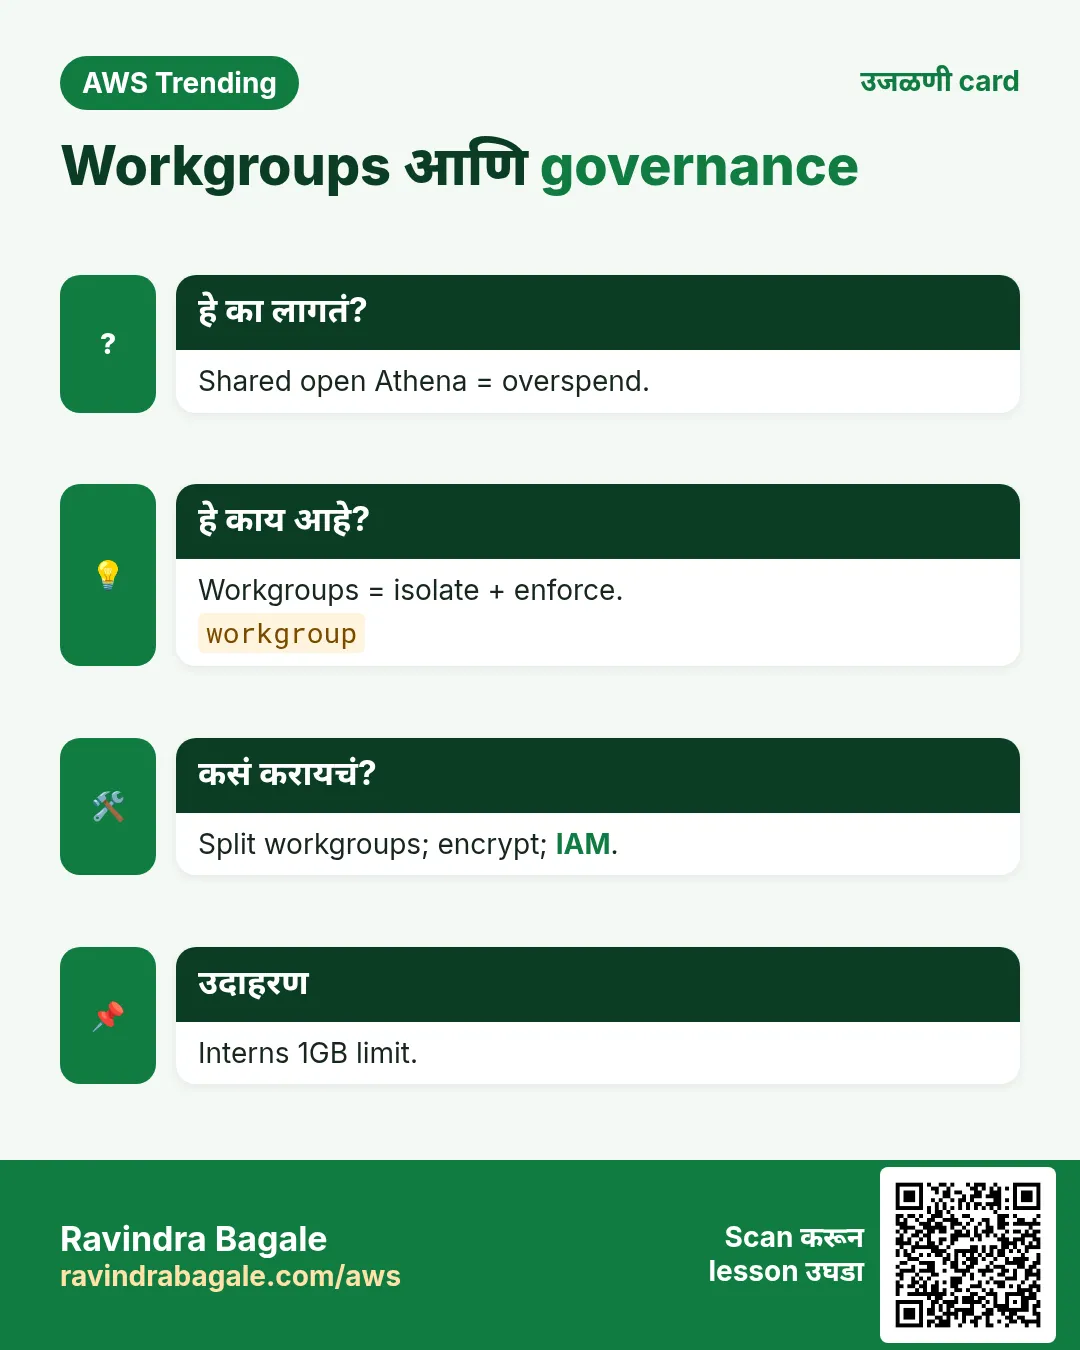
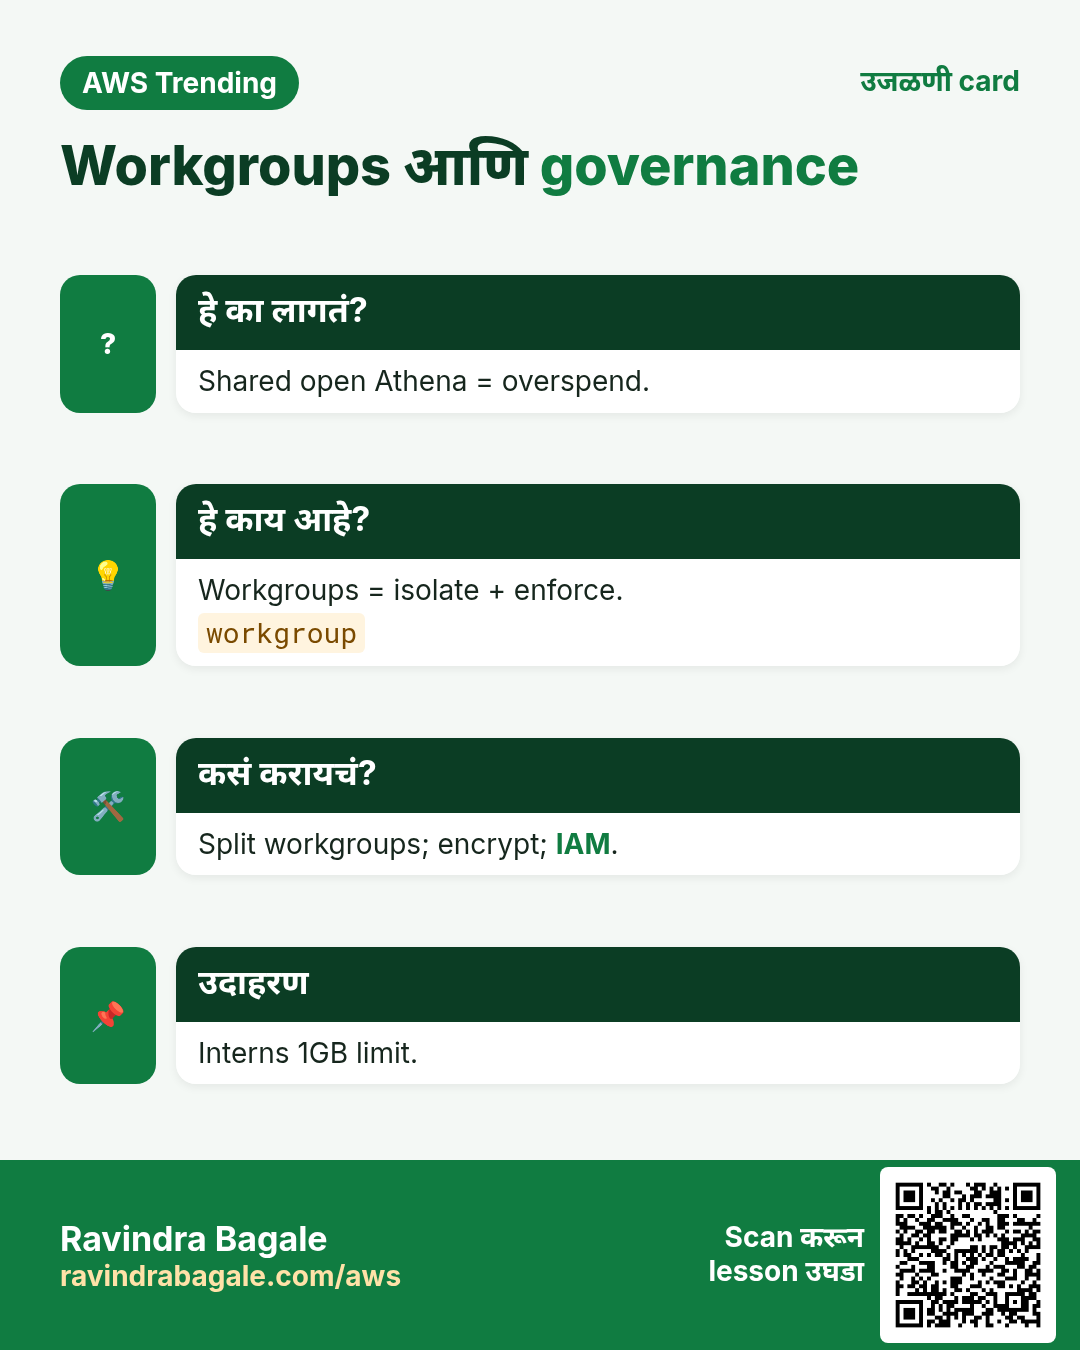
हे का लागतं?
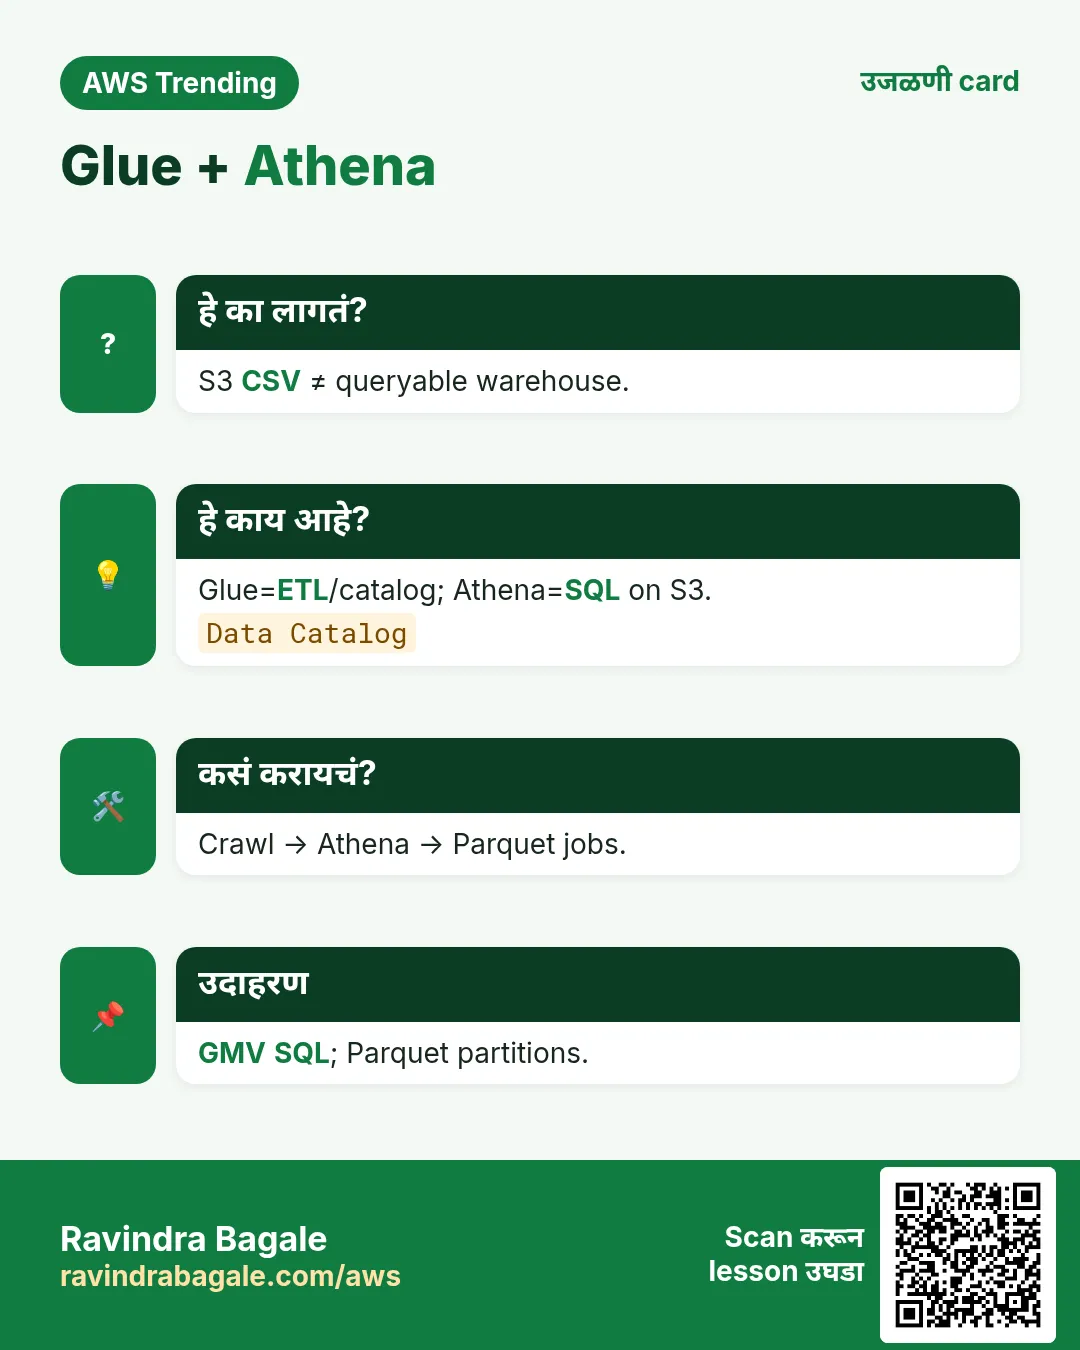
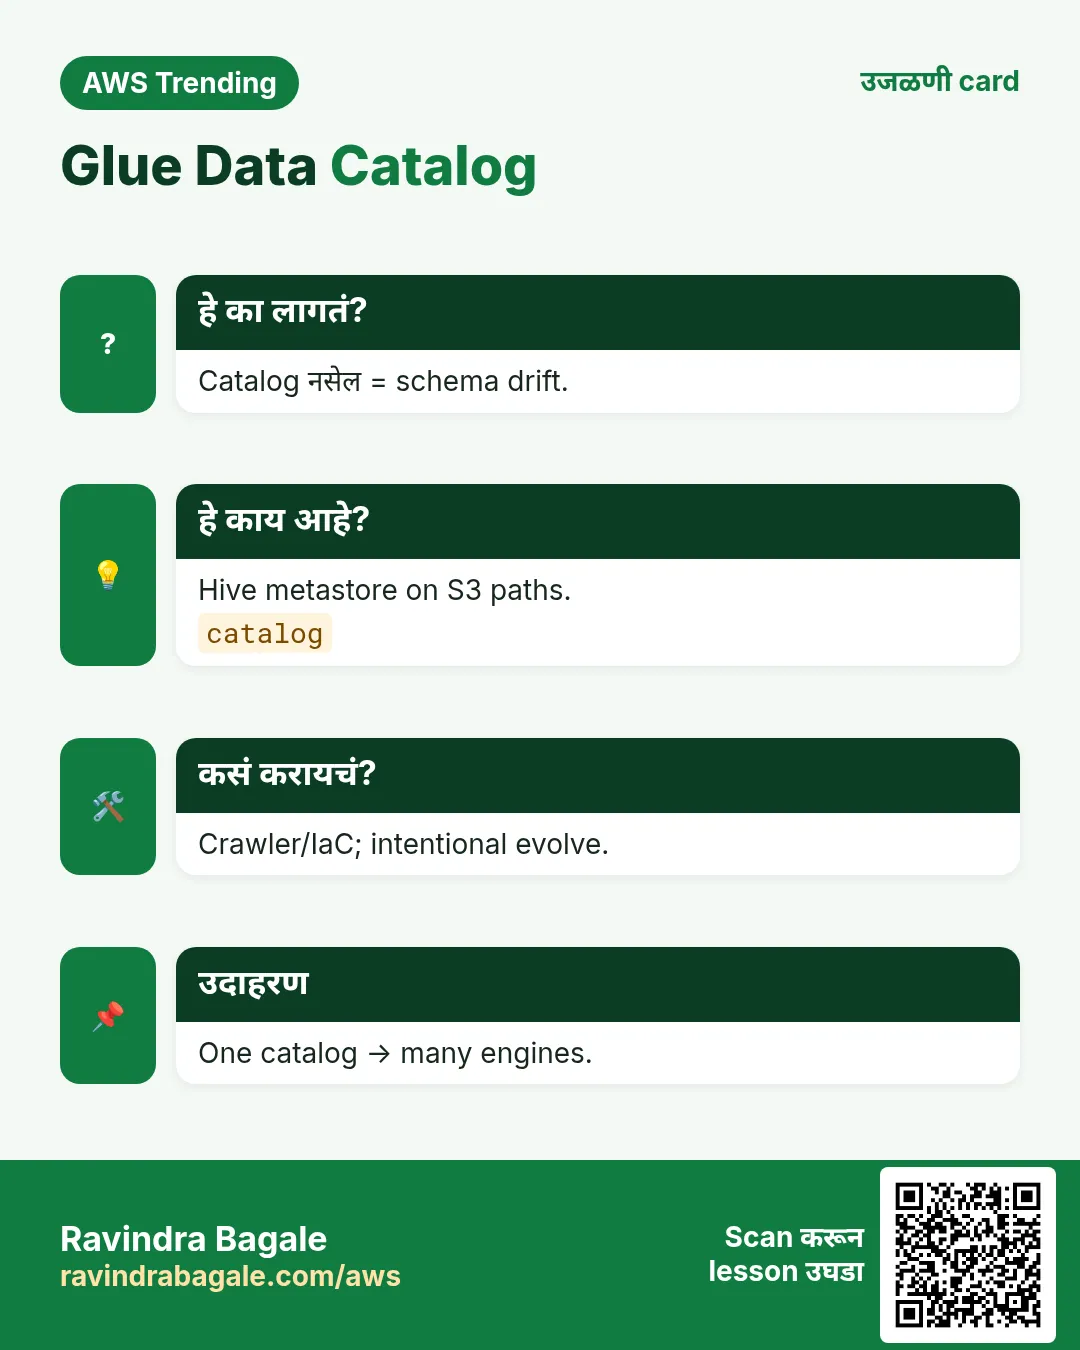
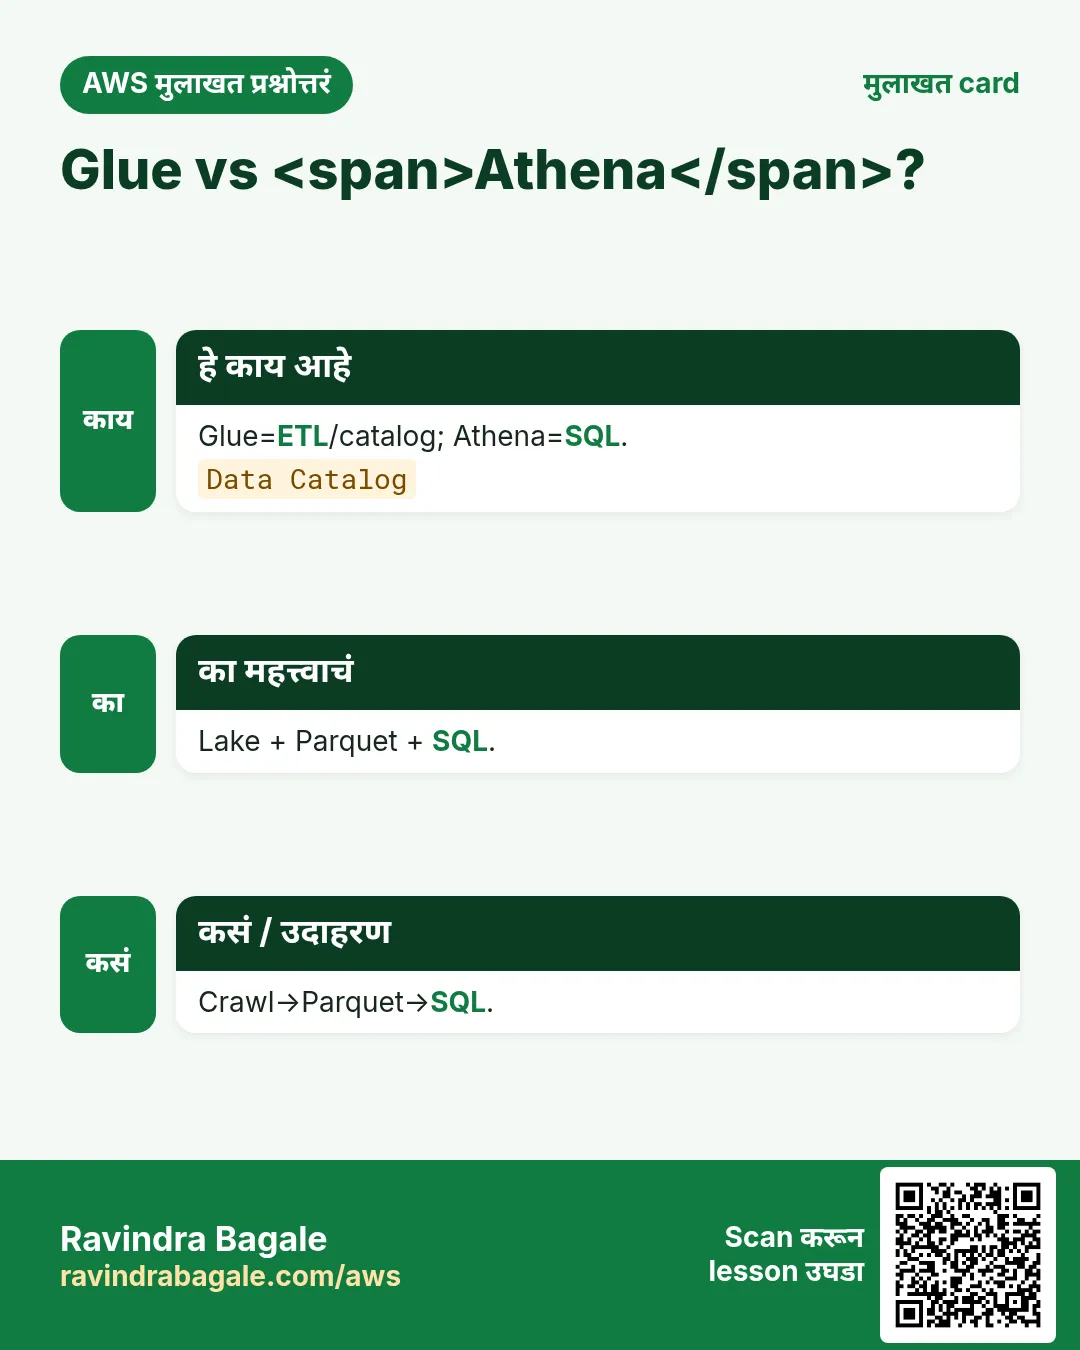
Catalog नसेल तर hard-coded paths. Serverless SQL नसेल तर warehouse वाट. Glue Catalog = metastore; Athena query; Glue ETL = heavy clean.
3. प्रत्येक piece काय करते
हे काय आहे?
| Piece | काम |
|---|---|
| Catalog | S3 वर schema |
| Crawler | Files पासून schema |
| Glue Job | ETL Spark/Ray |
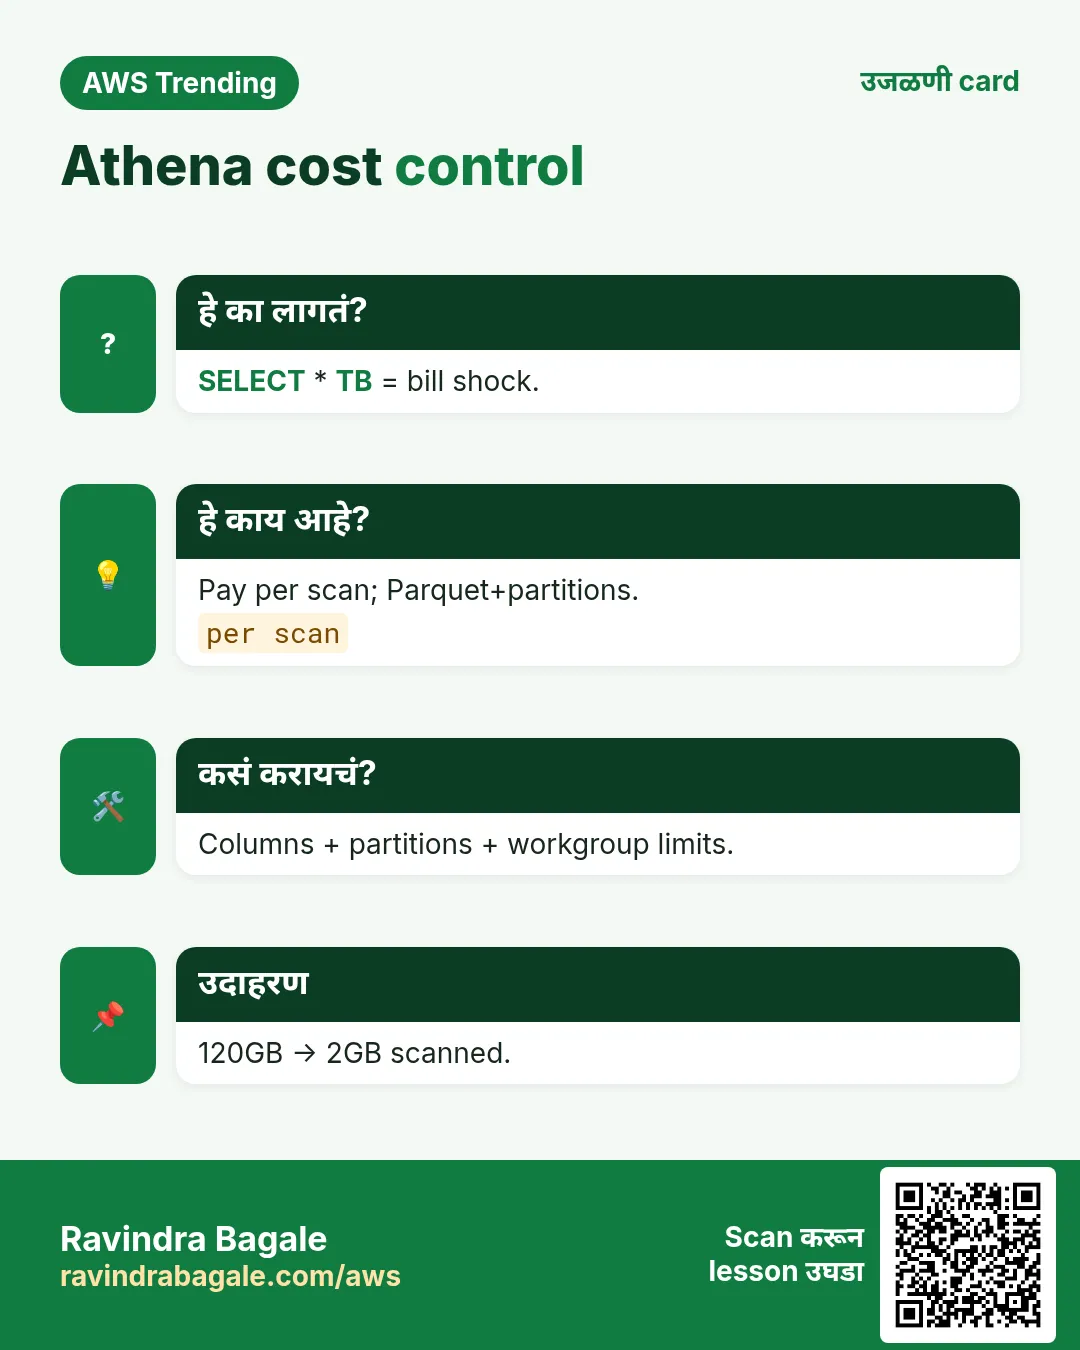
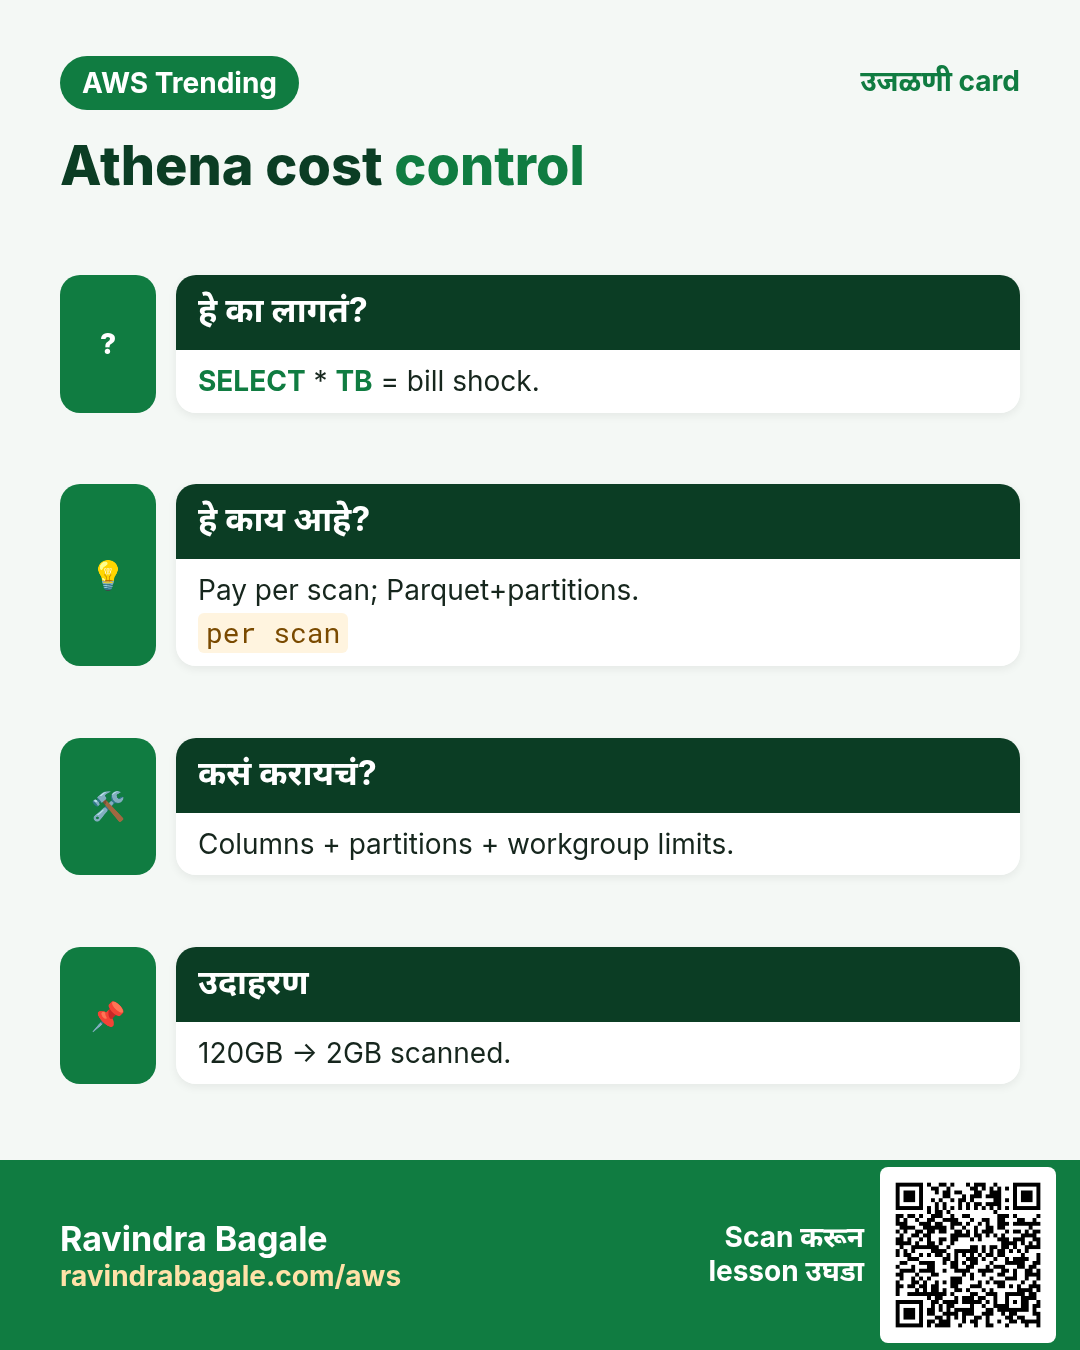
| Athena | SQL; pay per scan |
4. Cost कसा आटोक्यात
कसं करायचं (step by step)
- Parquet/ORC.
- Partition by date.
- Workgroup limits.
- Needed columns.
- Compress; avoid tiny files.
- Lifecycle junk.
-- Athena mental model
-- SELECT store_id, SUM(amount) AS sales
-- FROM sales
-- WHERE date = '2026-10-27'
-- GROUP BY 1;
-- Partition column in WHERE → less data scanned
5. Industries
- Retail sales lakes
- Adtech clicks
- Healthcare analytics
- Finance reconcile
6. Lab: Athena sample / paper SQL
Org block नसेल तर ap-south-1 (Mumbai). आधी budget alert.
कसं करायचं (step by step)
- Tiny sample prefix.
- Crawler/manual table.
- COUNT(*).
- Partition filter compare.
- IAM note.
Cleanup (billing थांबवा)
- Drop lab tables/prefixes.
- Crawler schedule off.
7. सामान्य errors आणि fixes
प्रत्येक row = खरी चूक. Panic करण्याआधी fix वाचा.
| Error / लक्षण | Fix |
|---|---|
| CSV bills | Parquet. |
| No partition filter | Filter. |
| Schema overwrite | Lock schema. |
| Small files | Compact. |
| No limits | Scan caps. |
| Public lake | Block public. |
| IAM star | Scope buckets. |
| JSON chaos | Flatten. |
| Open results | Private. |
| TZ partitions | UTC. |
8. Troubleshooting checklist
- Path/partition.
- IAM glue+s3.
- Bad files.
- Classify/exclude.
- DPU/workers.
- Workgroup metrics.
9. FAQ
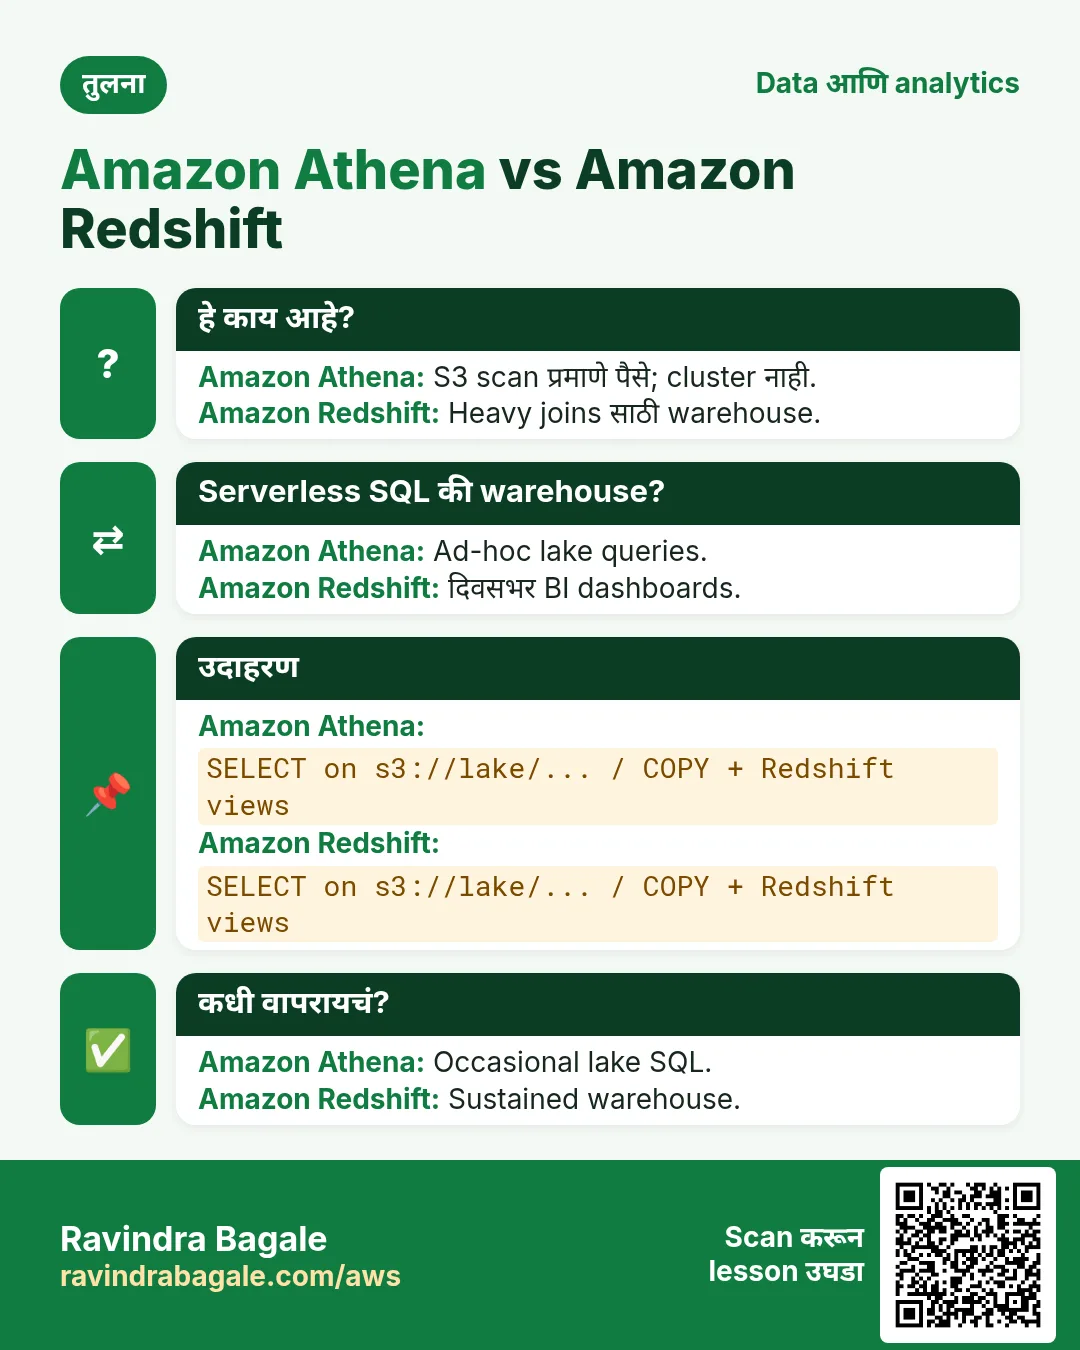
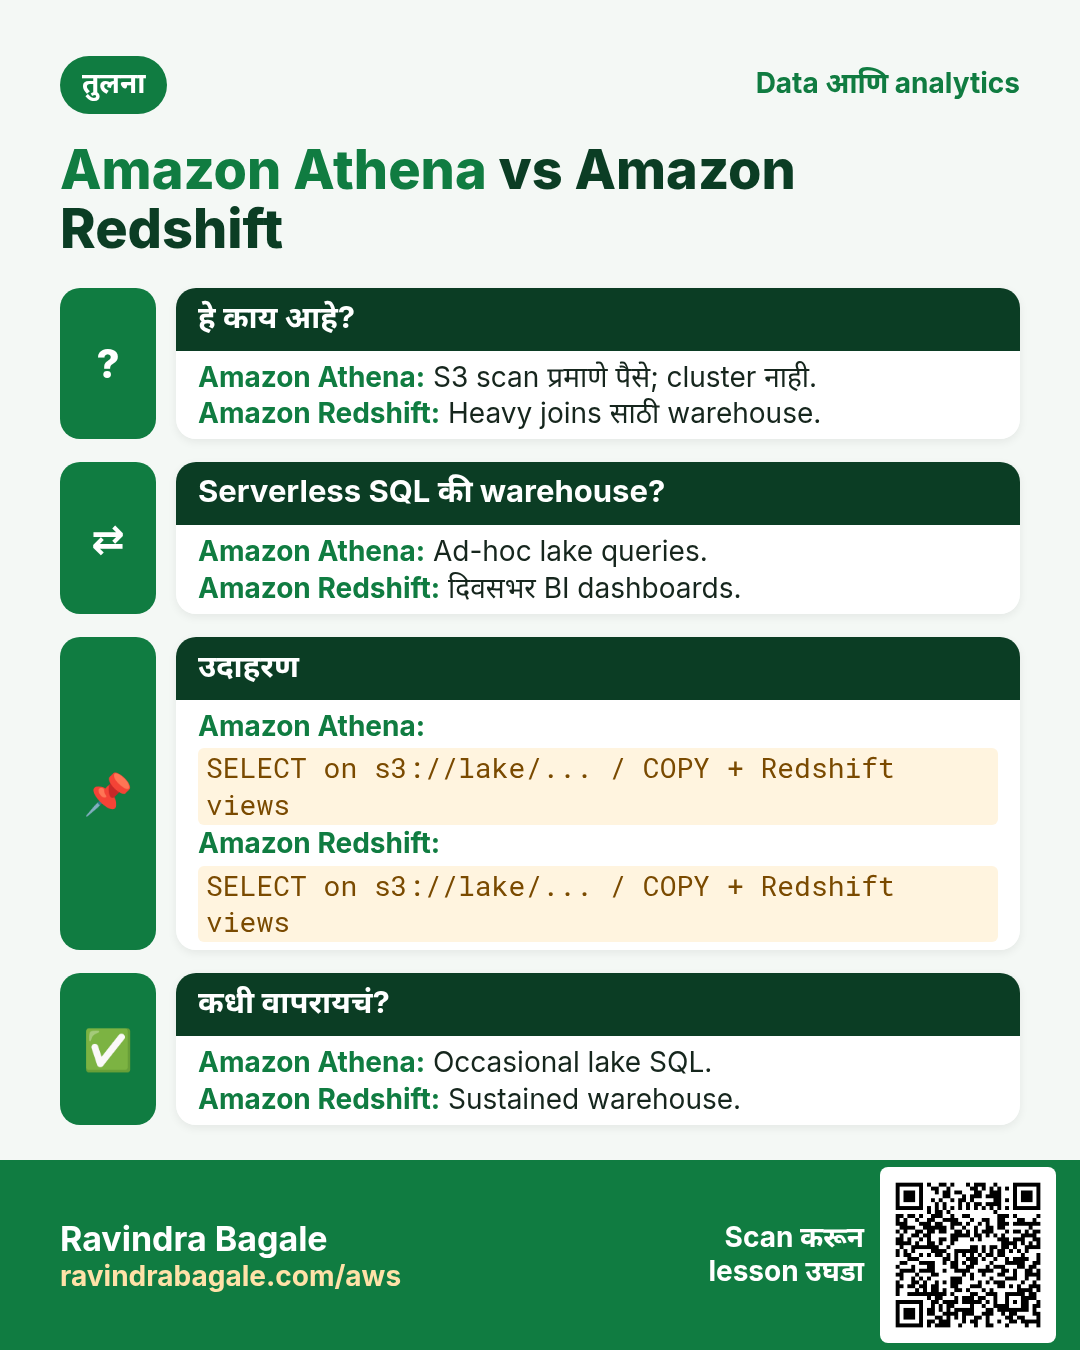
प्र. Redshift vs?
SQL-on-S3 vs warehouse.
प्र. Only Spark?
Spark common; check current.
प्र. Crawlers always?
No; manual/IaC OK.
प्र. Iceberg?
Verify current support.
प्र. Fail cost?
May scan; use limits.
10. Interview Q&A
प्र. Glue Catalog?
Central metastore.
प्र. Athena price?
Bytes scanned.
प्र. Parquet का?
Columnar less scan.
प्र. Crawler?
Infer schema.
प्र. Partition projection?
Advanced partition trick.
प्र. Lake vs WH?
Files vs curated.
11. Tips — English, मराठी आणि हिंदी
Ravindra Bagale's Tip (EN)
Partitions are a cost feature, not decoration. Put date filters in every habit query.
Ravindra Bagale's Tip (MR)
Partitions = cost feature. प्रत्येक query मध्ये date filter सवय.
Tip (HI)
Partitions सजावट नहीं — cost feature है; हर query में date filter डालो।
घरी करून बघा
- Bad vs good SQL.
- CSV→Parquet idea.
- IAM list.
थोडक्यात सांगायचं तर
- Glue catalog/ETL; Athena SQL.
- Parquet + partitions.
- Workgroups.
- No public lakes.
उजळणी, मुलाखत आणि तुलना cards
हा lesson काही मिनिटांत revise करा. Cards phone वर save करा किंवा PNG download करा. प्रत्येक card वरचा QR हा lesson उघडतो.
अजून cards: Ravi Sir's Cards.
सराव Tasks
Shivneri Schools हा जुन्नर मधला शिक्षण व्यवसाय आहे. Kavita Shinde त्यांचं IT व cloud काम पाहतात. त्यांचे पैसे INR मध्ये मोजले जातात आणि AWS resources ap-south-1 Region मध्ये चालतात. खालच्या tasks मध्ये तुम्ही या lesson मध्ये शिकलेलं वापरून त्यांची खरी कामं करता. सगळी नावं, account IDs, IP addresses व numbers सरावासाठी काल्पनिक आहेत.
0 / 16
सोपं Glue DBs
का: Catalog.
काय करायचं: Glue databases.
- Task वाचा आणि ते कोणत्या AWS service बद्दल आहे ते ठरवा.
- aws लिहा, मग service चं नाव, मग operation (action शब्द).
- प्रत्येक आवश्यक flag (--name) व त्यापुढे task मधली value लिहा.
- Flags कोणत्याही क्रमाने चालतात. Check answer दाबा.
सोपं Tables
का: Tables.
काय करायचं: shivnerischool_lake tables.
- Task वाचा आणि ते कोणत्या AWS service बद्दल आहे ते ठरवा.
- aws लिहा, मग service चं नाव, मग operation (action शब्द).
- प्रत्येक आवश्यक flag (--name) व त्यापुढे task मधली value लिहा.
- Flags कोणत्याही क्रमाने चालतात. Check answer दाबा.
सोपं Workgroups
का: Cost.
काय करायचं: Athena workgroups.
- Task वाचा आणि ते कोणत्या AWS service बद्दल आहे ते ठरवा.
- aws लिहा, मग service चं नाव, मग operation (action शब्द).
- प्रत्येक आवश्यक flag (--name) व त्यापुढे task मधली value लिहा.
- Flags कोणत्याही क्रमाने चालतात. Check answer दाबा.
सोपं Scan billing
का: Bytes.
काय करायचं: Athena scan billing तर 1.
- Task मधले numbers लिहून घ्या.
- कागदावर step by step काढा.
- Box मध्ये फक्त final उत्तर लिहा.
- Check answer दाबा.
सोपं Parquet
का: Columnar.
काय करायचं: Parquet > CSV तर 1.
- Task मधले numbers लिहून घ्या.
- कागदावर step by step काढा.
- Box मध्ये फक्त final उत्तर लिहा.
- Check answer दाबा.
सोपं Public lake
का: Public नको.
काय करायचं: Public lake OK? 0.
- Task मधले numbers लिहून घ्या.
- कागदावर step by step काढा.
- Box मध्ये फक्त final उत्तर लिहा.
- Check answer दाबा.
मध्यम Table get
का: Schema.
काय करायचं: shivnerischool_lake sales.
- Task वाचा आणि ते कोणत्या AWS service बद्दल आहे ते ठरवा.
- aws लिहा, मग service चं नाव, मग operation (action शब्द).
- प्रत्येक आवश्यक flag (--name) व त्यापुढे task मधली value लिहा.
- Flags कोणत्याही क्रमाने चालतात. Check answer दाबा.
मध्यम Crawler
का: Infer.
काय करायचं: shivnerischool-sales crawler.
- Task वाचा आणि ते कोणत्या AWS service बद्दल आहे ते ठरवा.
- aws लिहा, मग service चं नाव, मग operation (action शब्द).
- प्रत्येक आवश्यक flag (--name) व त्यापुढे task मधली value लिहा.
- Flags कोणत्याही क्रमाने चालतात. Check answer दाबा.
मध्यम Query status
का: State/scanned.
काय करायचं: qid-123 get.
- Task वाचा आणि ते कोणत्या AWS service बद्दल आहे ते ठरवा.
- aws लिहा, मग service चं नाव, मग operation (action शब्द).
- प्रत्येक आवश्यक flag (--name) व त्यापुढे task मधली value लिहा.
- Flags कोणत्याही क्रमाने चालतात. Check answer दाबा.
मध्यम Results put
का: Results write.
काय करायचं: arn:aws:s3:::shivnerischool-ath-results/* PutObject.
- { "Version": "2012-10-17", "Statement": [ ... ] } ने सुरू करा.
- प्रत्येक statement मध्ये Effect, Action व Resource लिहा.
- Task ला लागेल तेवढंच द्या (least privilege).
- Double quotes व commas नीट वापरा. Check answer दाबा.
मध्यम Partition
का: Cost.
काय करायचं: date 2026-10-27.
- Task मधल्या top-level keys पासून सुरू करा.
- Child keys 2 spaces ने indent करा (tabs नकोत).
- प्रत्येक property मध्ये task मधली value भरा.
- Check answer दाबा. Keys चा क्रम महत्त्वाचा नाही.
मध्यम WG limit
का: Bill cap.
काय करायचं: WG limit GB?
- Task मधले numbers लिहून घ्या.
- कागदावर step by step काढा.
- Box मध्ये फक्त final उत्तर लिहा.
- Check answer दाबा.
अवघड Start crawler
का: Catalog refresh.
काय करायचं: shivnerischool-sales start.
- Task वाचा आणि ते कोणत्या AWS service बद्दल आहे ते ठरवा.
- aws लिहा, मग service चं नाव, मग operation (action शब्द).
- प्रत्येक आवश्यक flag (--name) व त्यापुढे task मधली value लिहा.
- Flags कोणत्याही क्रमाने चालतात. Check answer दाबा.
अवघड Start query
का: SQL on S3.
काय करायचं: SELECT 1 workgroup primary.
- Task वाचा आणि ते कोणत्या AWS service बद्दल आहे ते ठरवा.
- aws लिहा, मग service चं नाव, मग operation (action शब्द).
- प्रत्येक आवश्यक flag (--name) व त्यापुढे task मधली value लिहा.
- Flags कोणत्याही क्रमाने चालतात. Check answer दाबा.
अवघड Glue S3 read
का: GetObject.
काय करायचं: arn:aws:s3:::shivnerischool-lake/* GetObject.
- { "Version": "2012-10-17", "Statement": [ ... ] } ने सुरू करा.
- प्रत्येक statement मध्ये Effect, Action व Resource लिहा.
- Task ला लागेल तेवढंच द्या (least privilege).
- Double quotes व commas नीट वापरा. Check answer दाबा.
अवघड Query meta
का: Partition filter.
काय करायचं: sql with date filter.
- Task मधल्या top-level keys पासून सुरू करा.
- Child keys 2 spaces ने indent करा (tabs नकोत).
- प्रत्येक property मध्ये task मधली value भरा.
- Check answer दाबा. Keys चा क्रम महत्त्वाचा नाही.