CloudWatch मध्ये EC2 आणि EBS Health Check Alarms (Status Checks, BurstBalance, Queue Length)
CloudWatch Alarm ने EC2 Instance Stop, Start, Reboot किंवा Recover कसा करायचा मध्ये alarm actions बघितले. आता ते योग्य health signals वर लावूया: EC2 status checks आणि EBS volume signals. हे alarms प्रत्येक production server वर पहिल्या दिवसापासून हवेत.
या chapter मध्ये तुम्ही काय शिकाल
- System, instance आणि attached EBS status checks, आणि प्रत्येक कोण fix करतं
- Lab: StatusCheckFailed_System वर auto-recover, StatusCheckFailed_Instance वर reboot
- EBS volume status checks (ok, warning, impaired)
- BurstBalance आणि VolumeQueueLength alarms, प्रत्येक value च्या कारणासह
1. गोष्ट: site बंद, पण CPU ठीक दिसतो
रात्री 2 वाजता एका Node.js shop site चा response बंद होतो. CPU graph सपाट 0% दाखवतो. Team ला वाटतं "traffic कमी आहे". खरं तर server अडकलाय: OS ची memory संपली. CPU alarms ला हे दिसत नाही. Status checks ना दिसतं.
दुसऱ्या रात्री छोट्या gp2 disk वरचा MySQL server खूप slow होतो. CPU परत कमी. Disk चे burst credits संपले. हे फक्त EBS metrics दाखवतात.
2. EC2 status checks
हे का लागतं?
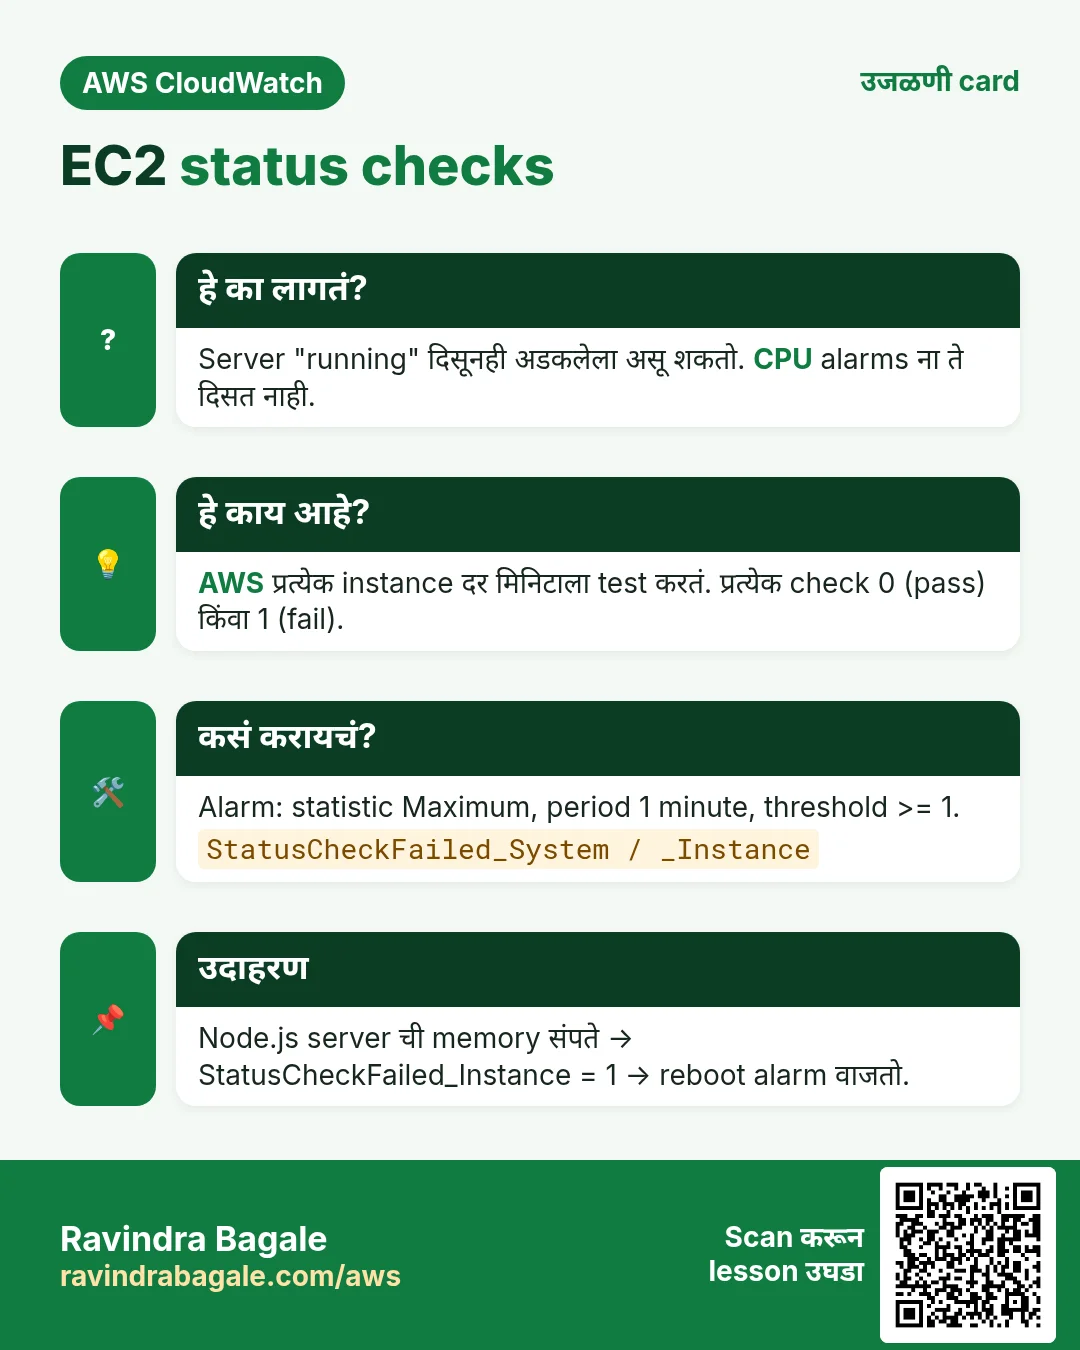
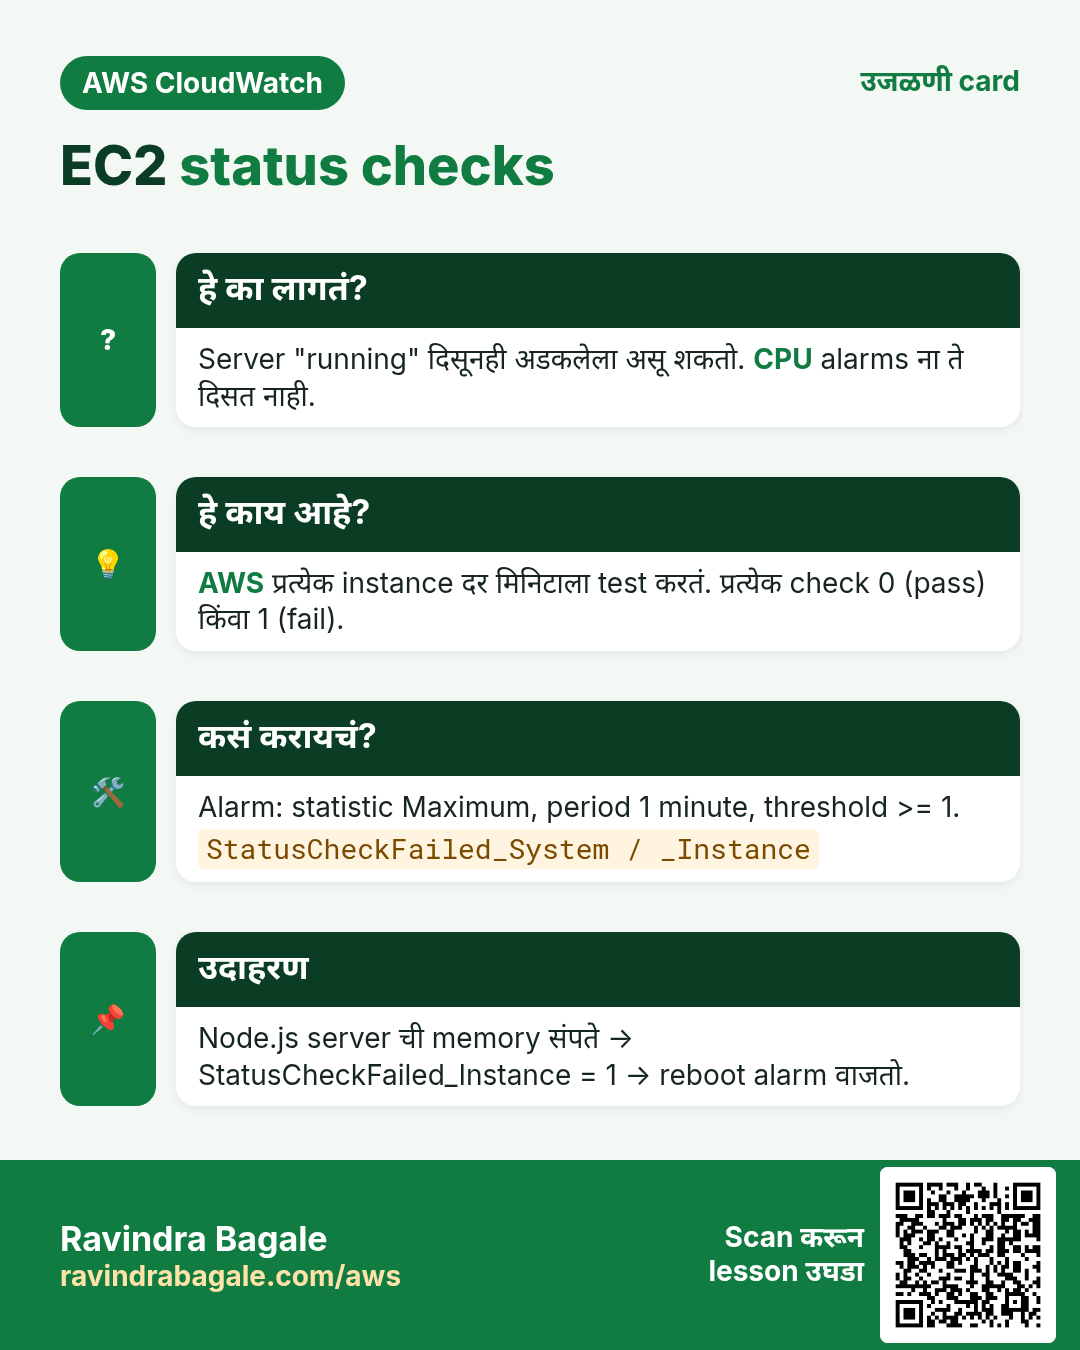
Console मध्ये server "running" दिसूनही निरुपयोगी असू शकतो. AWS प्रत्येक instance दर मिनिटाला test करतं, म्हणजे तो खरंच चालतोय का ते कळतं.
हे काय आहे?
| Check / metric | काय test करतं | नेहमीचं कारण | कोण fix करतं | Alarm action |
|---|---|---|---|---|
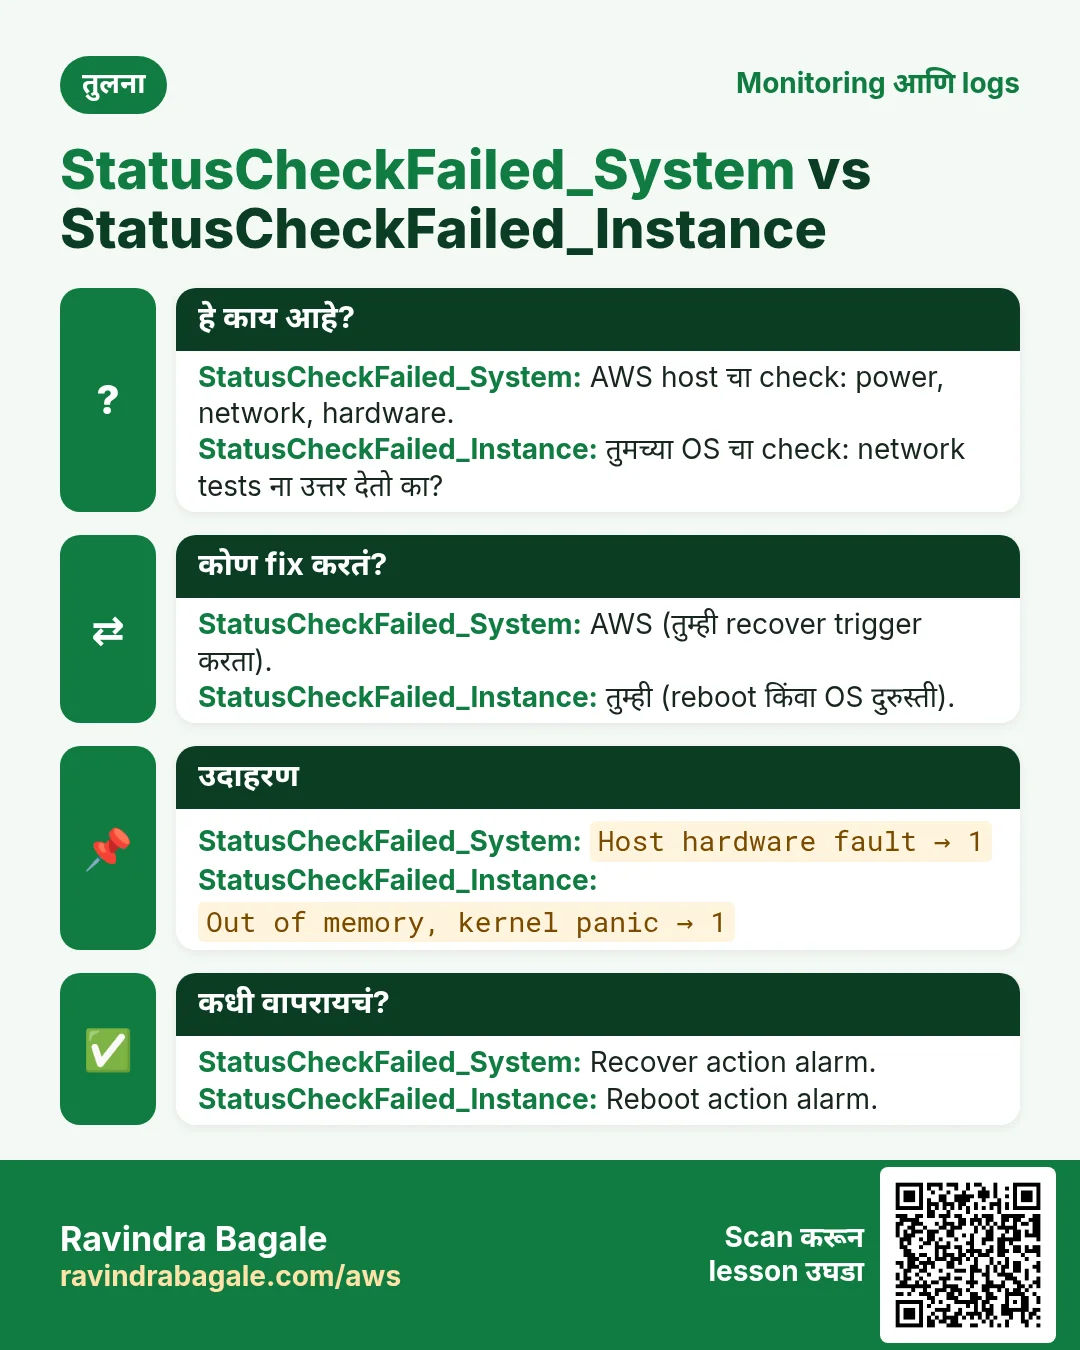
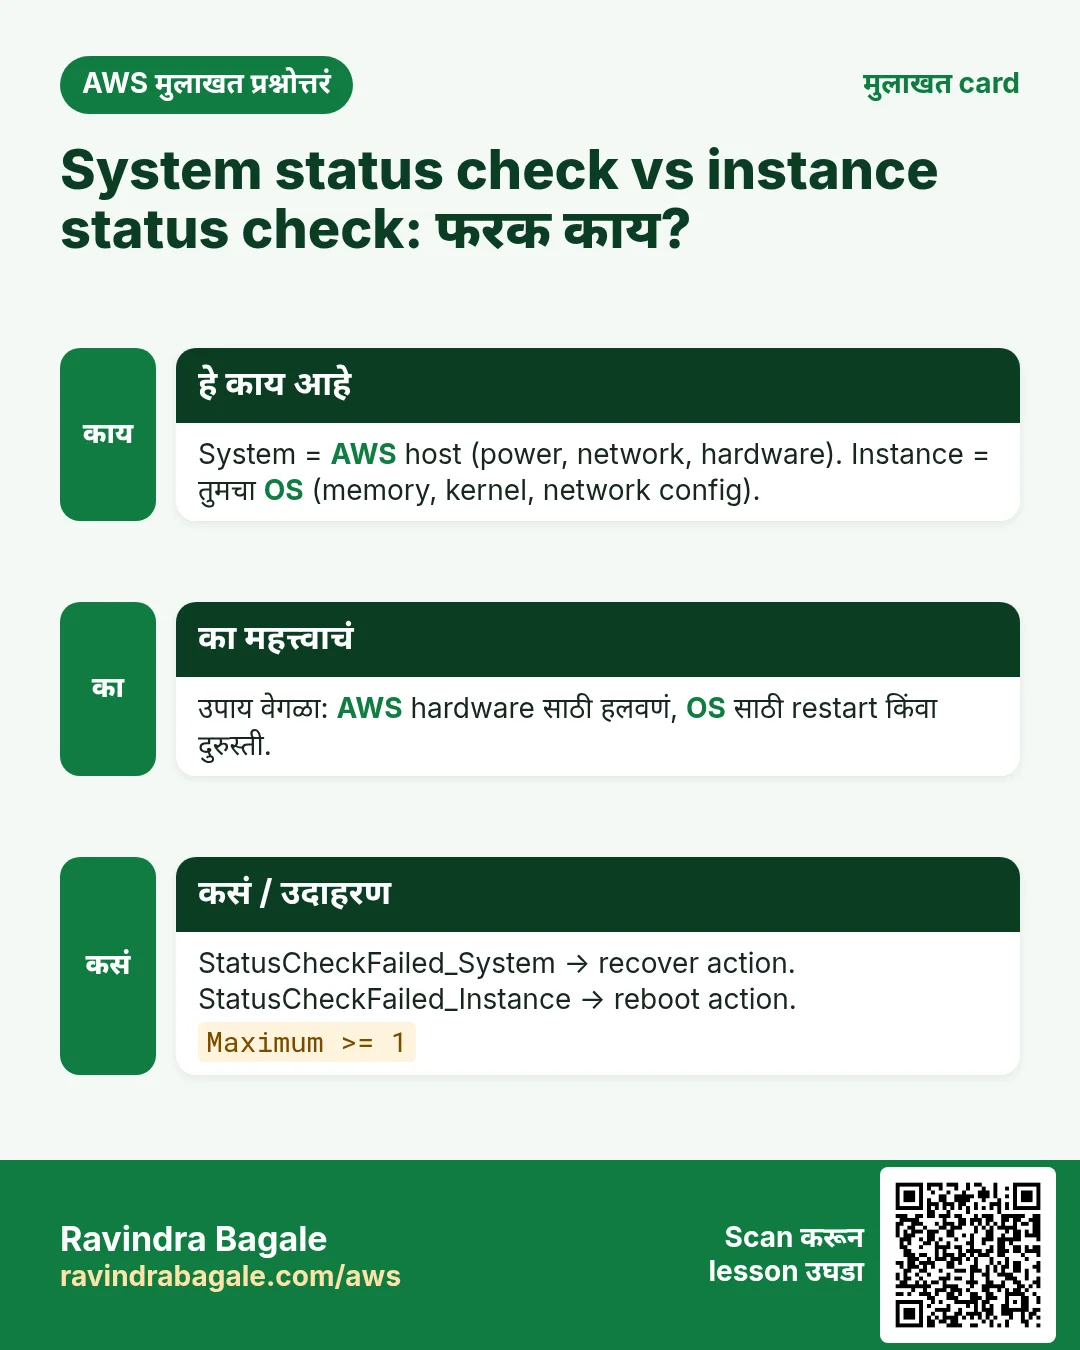
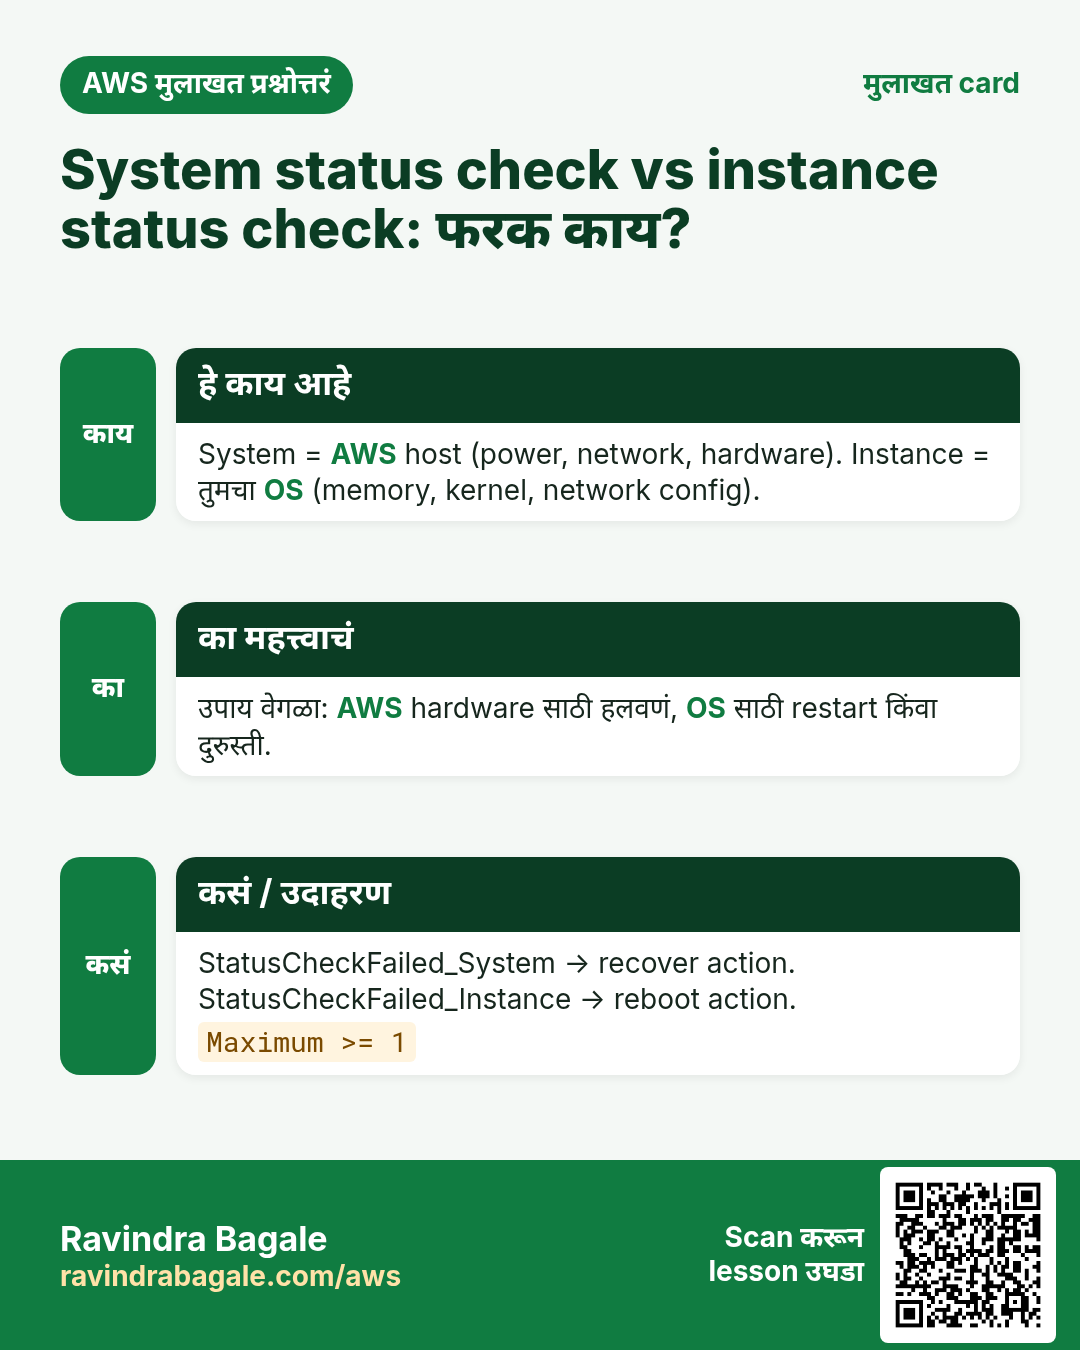
System status checkStatusCheckFailed_System | AWS host: power, network, hardware | Host hardware failure | AWS | Recover |
Instance status checkStatusCheckFailed_Instance | तुमचा OS network tests ला उत्तर देतो | Memory संपली, kernel panic, चुकीचा network config, boot ला full disk | तुम्ही | Reboot |
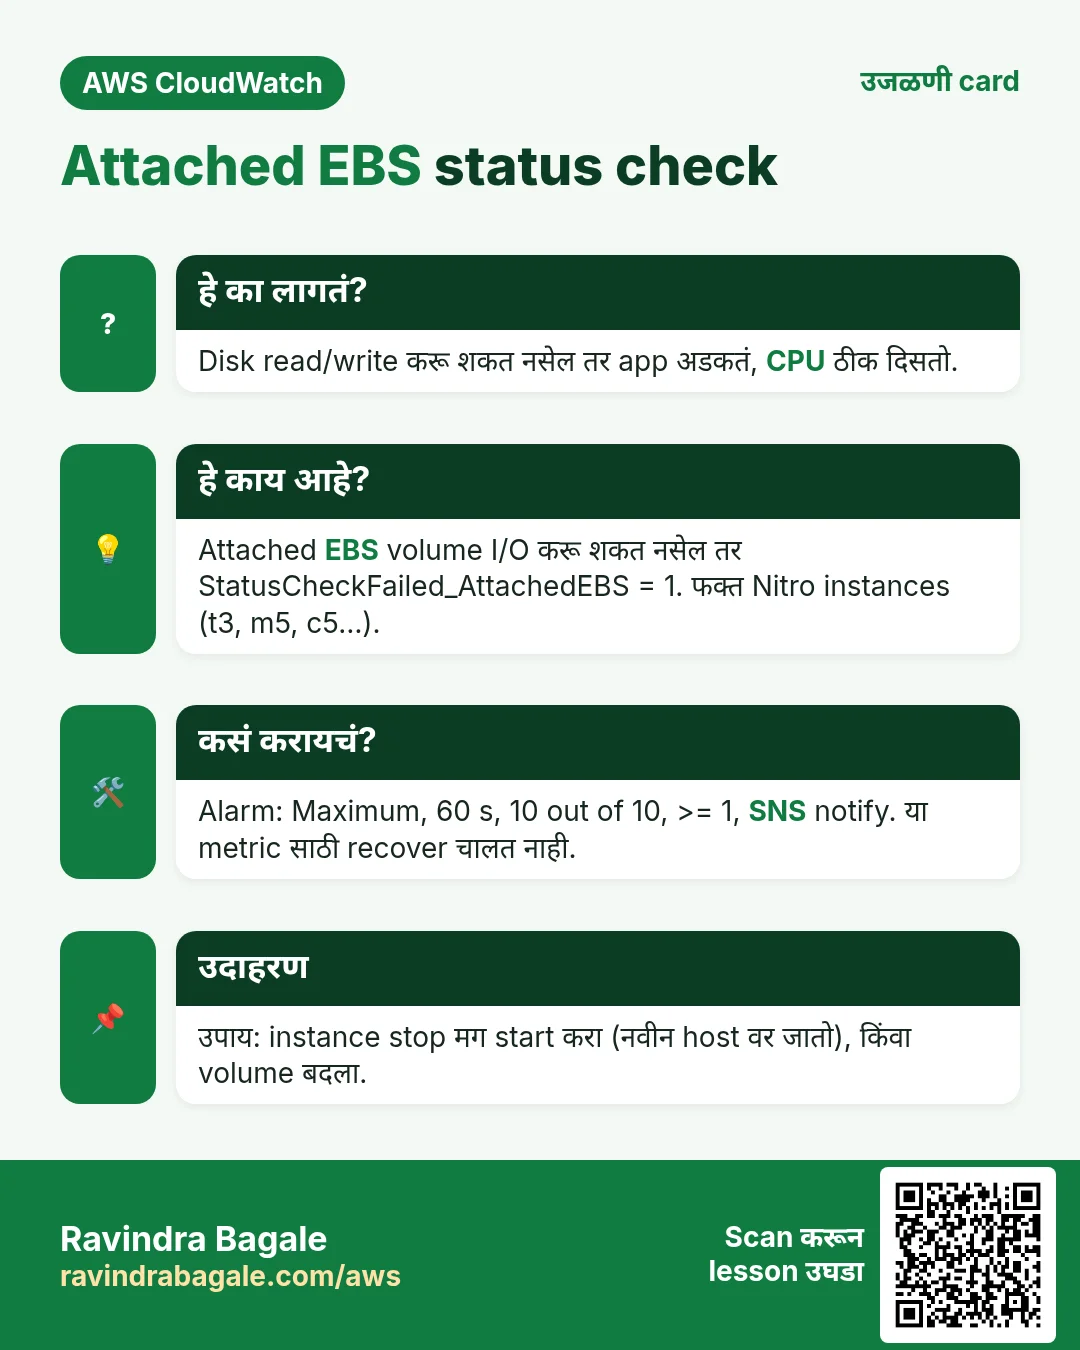
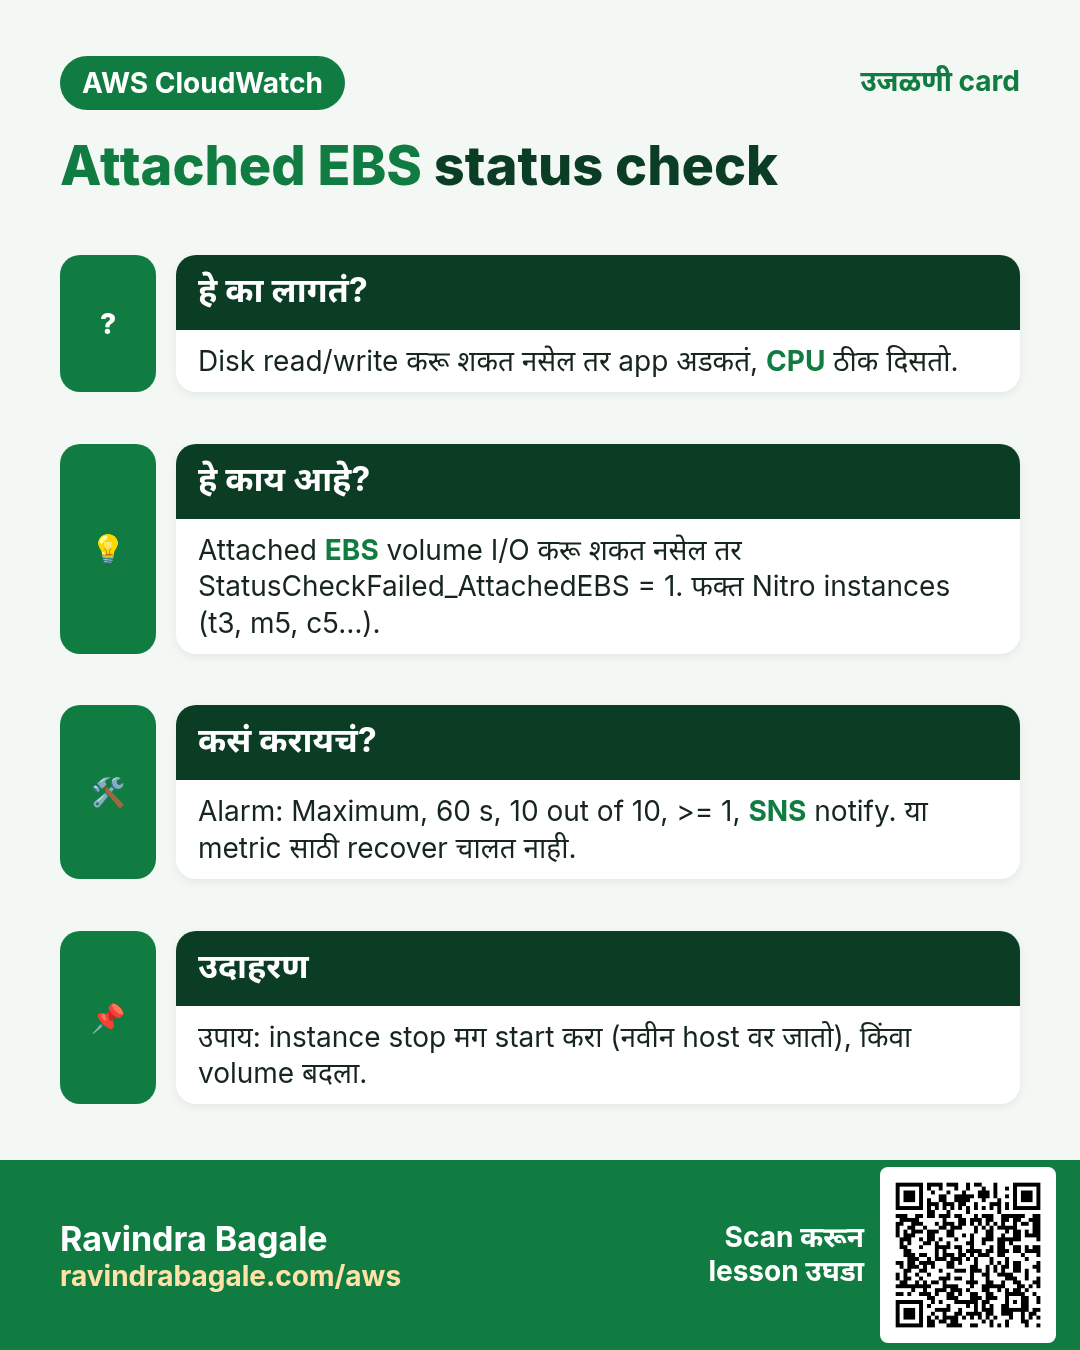
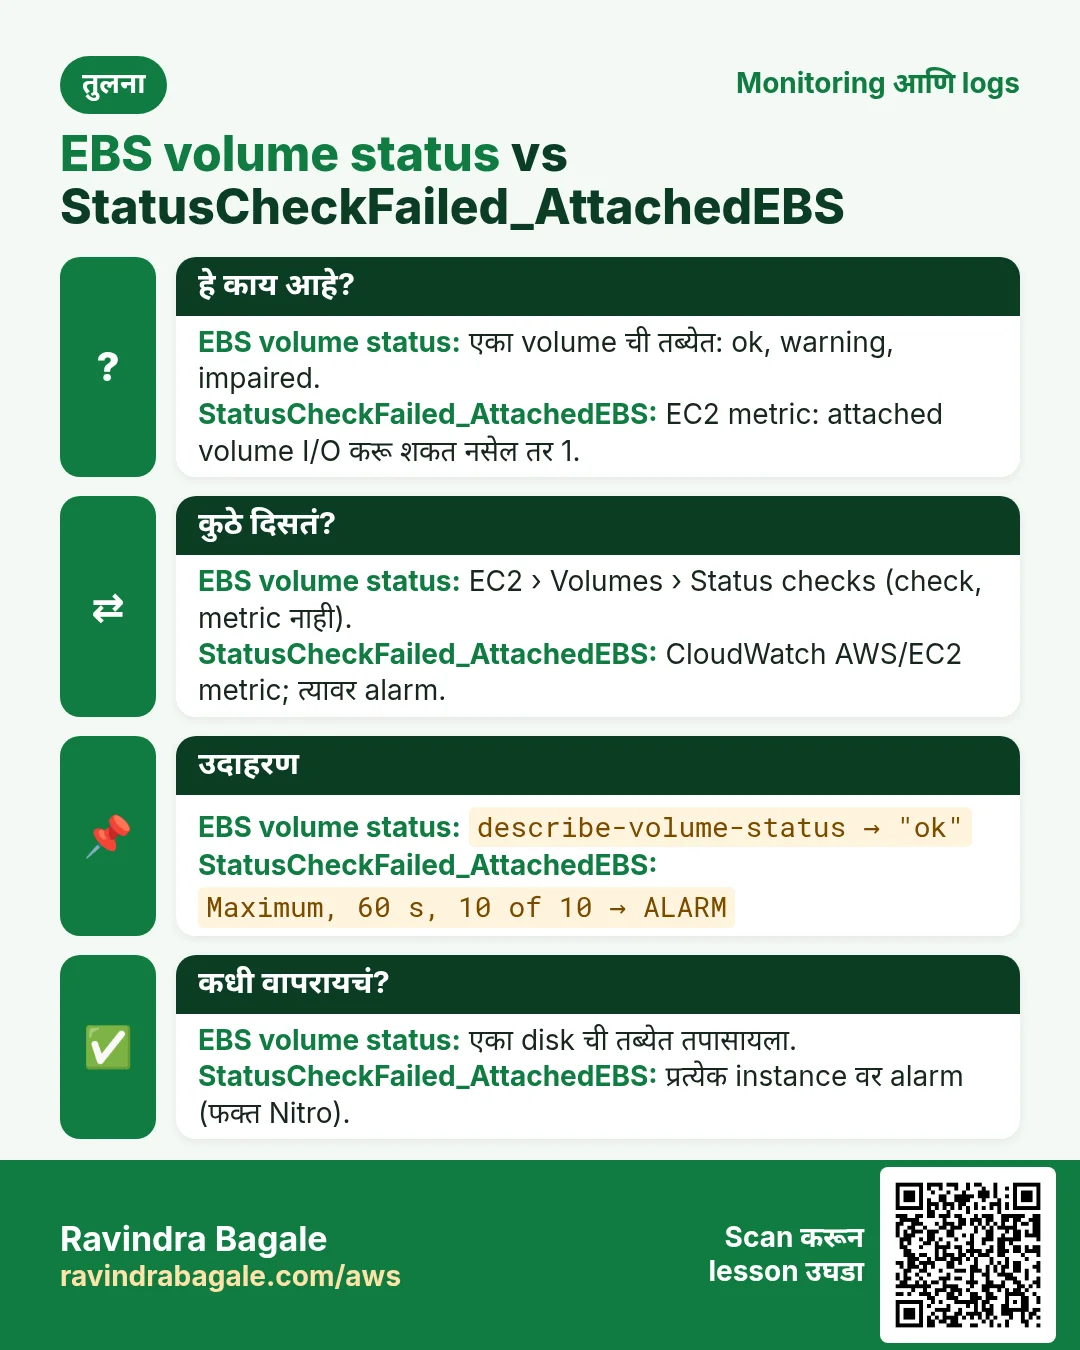
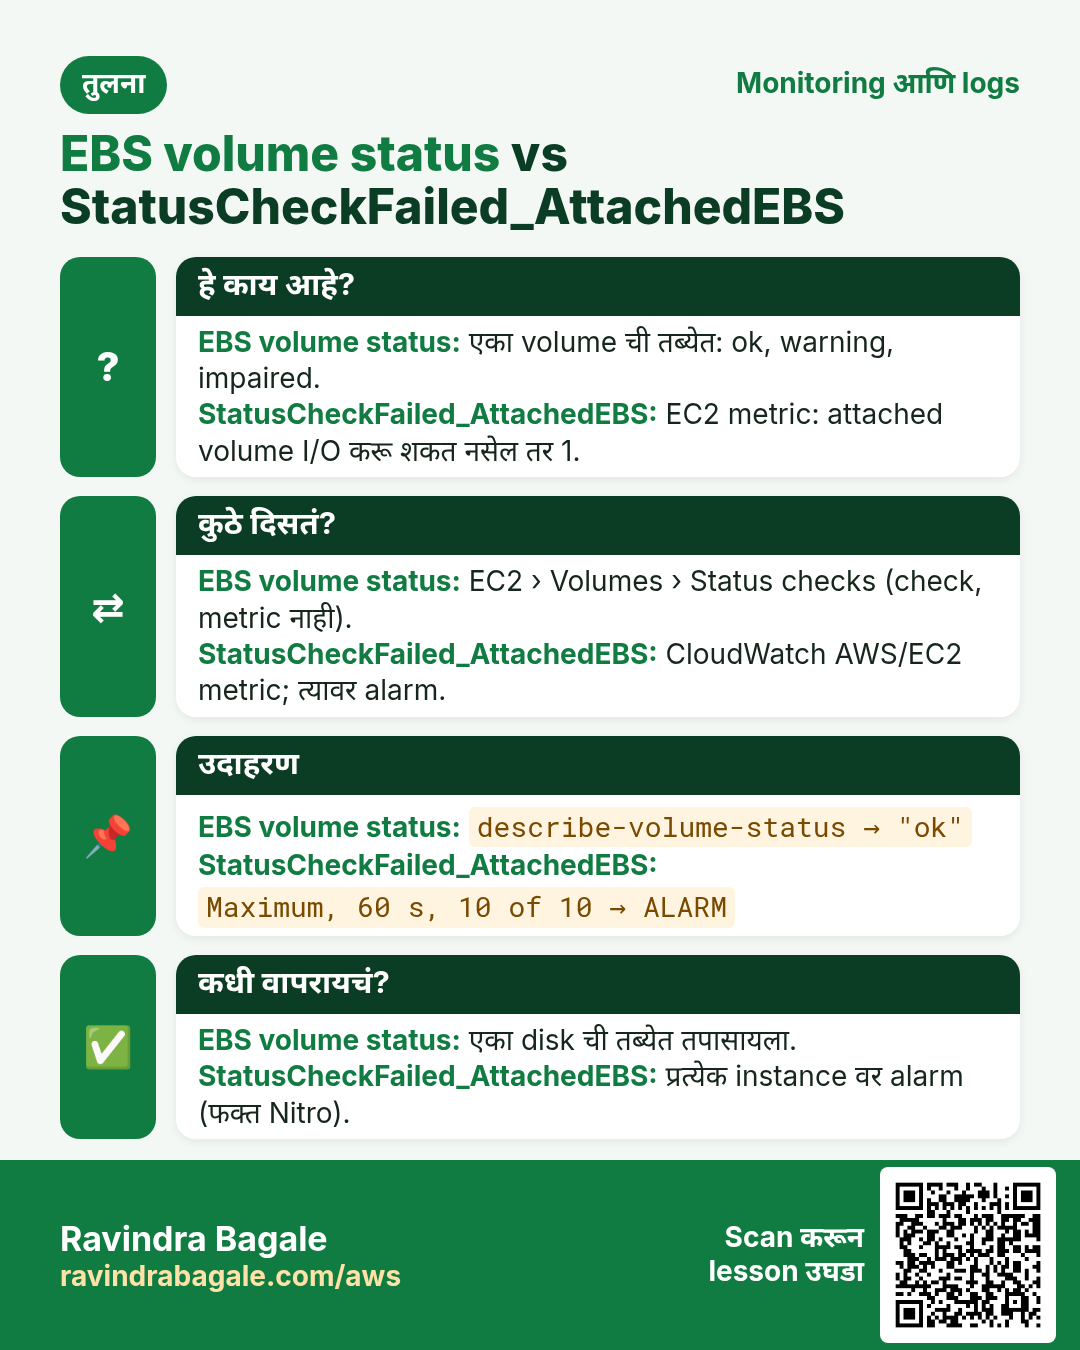
Attached EBS checkStatusCheckFailed_AttachedEBS | Attached EBS volumes I/O करू शकतात | Storage किंवा host problem | AWS / तुम्ही (stop-start) | Notify, किंवा stop मग start; recover चालत नाही |
दोन्हीStatusCheckFailed | कोणताही check fail झाला तर 1 | - | - | Notify |
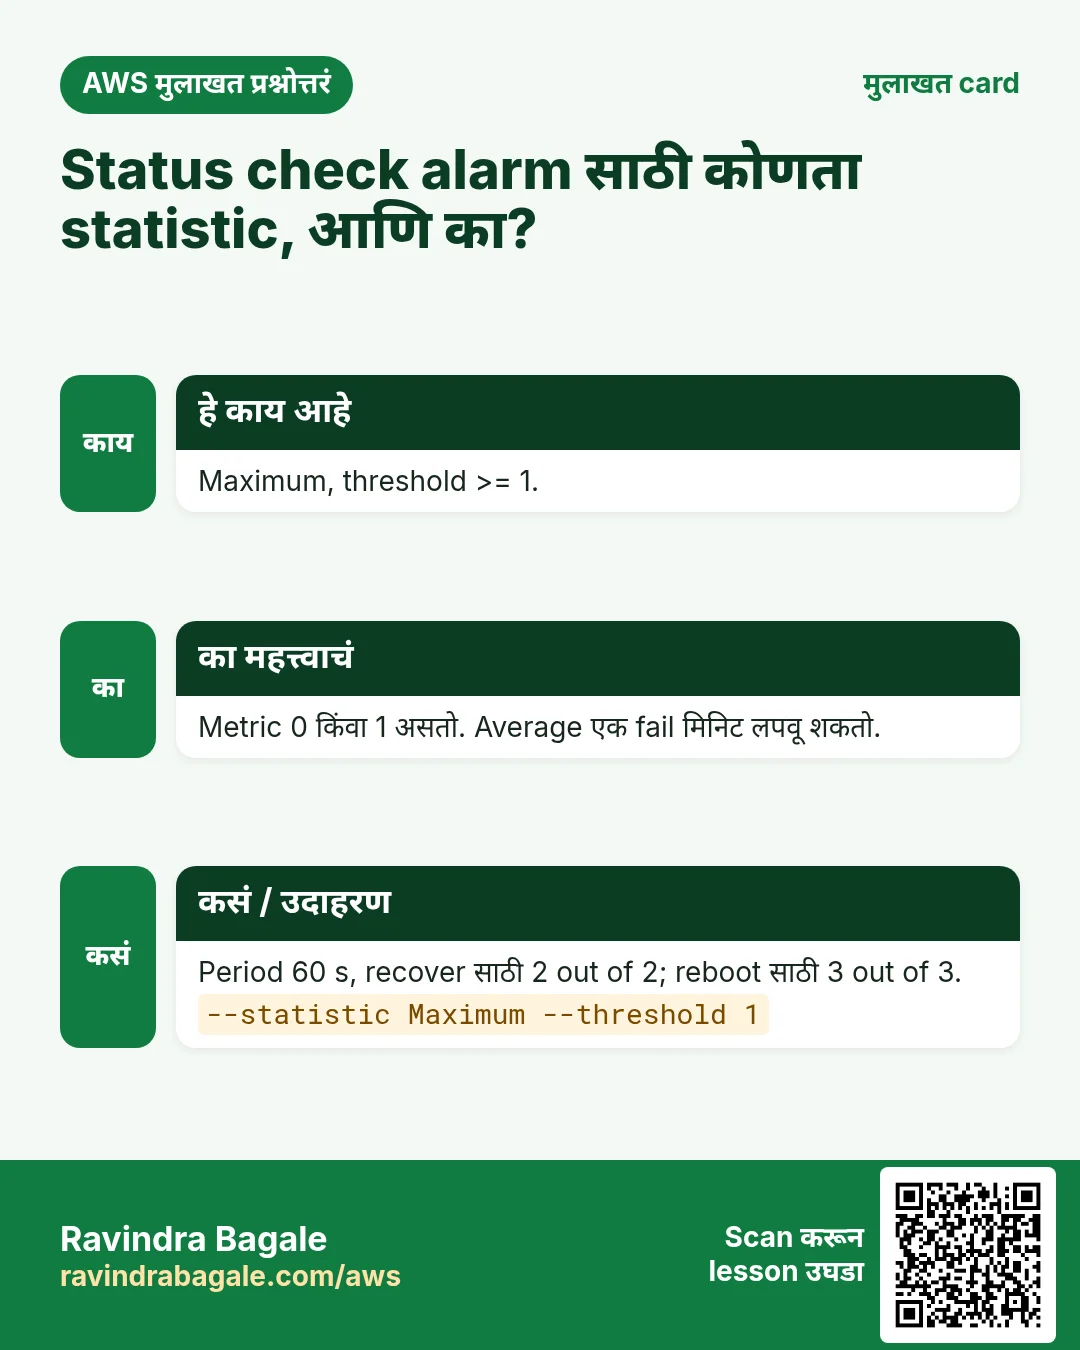
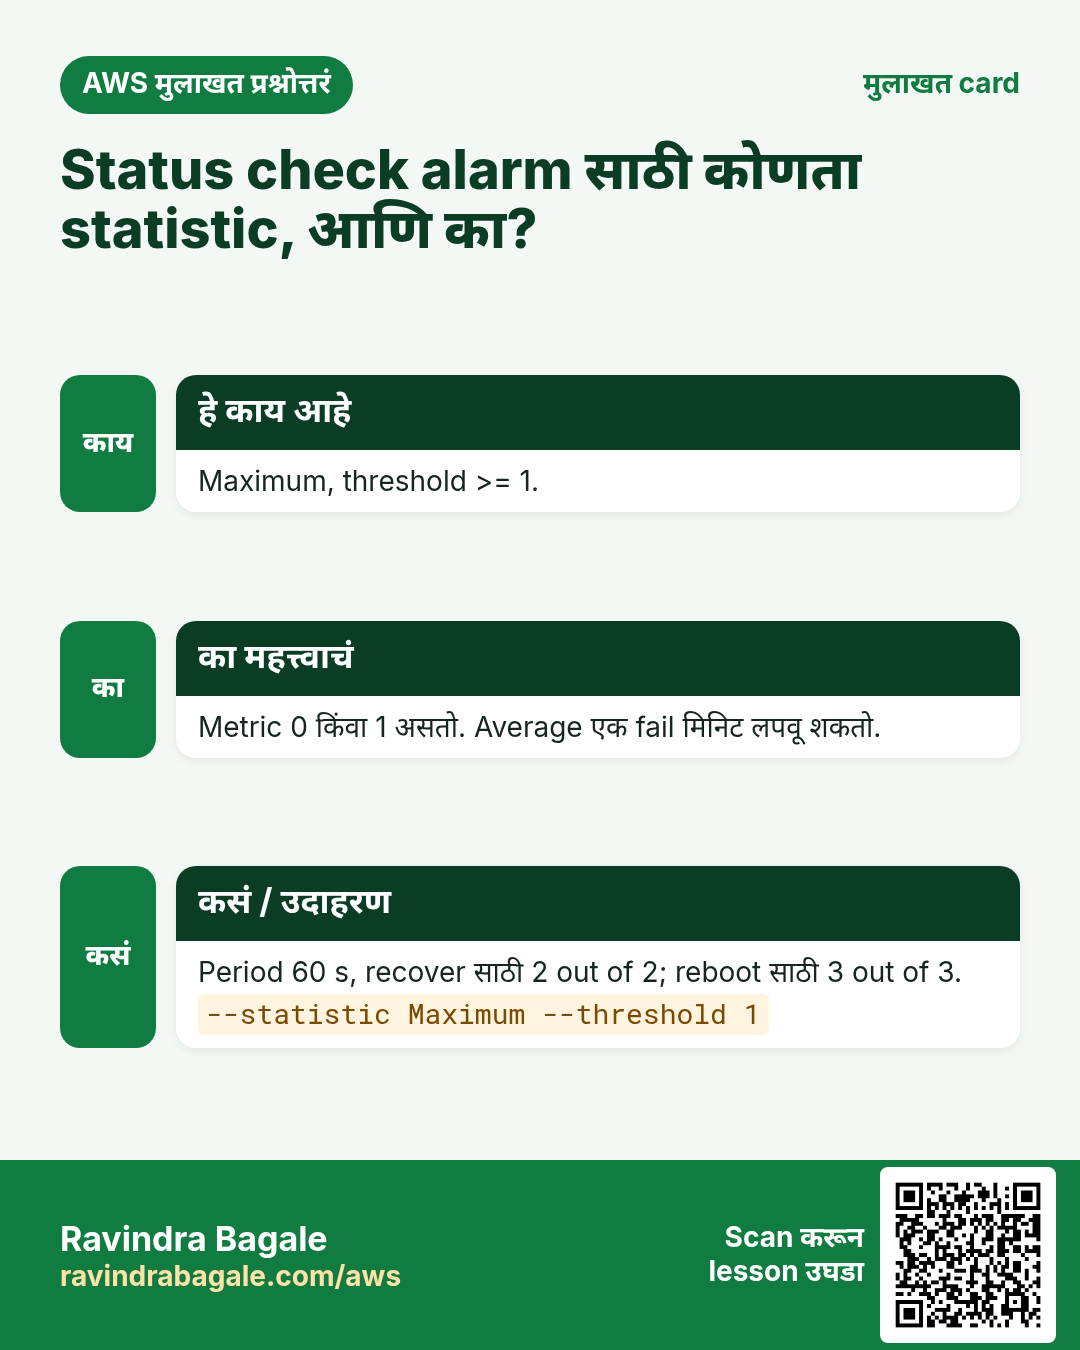
प्रत्येक metric 0 (pass) किंवा 1 (fail) असतो. म्हणून statistic Maximum आणि threshold >= 1. Attached EBS check फक्त Nitro instances (t3, m5, c5 आणि नवीन) वर चालतो.
Ravindra Bagale's Tip
अनेक सध्याच्या instance types वर system check failures साठी simplified automatic recovery default ने चालू असतं. तरी recover alarm उपयोगी आहे: तो email पण पाठवतो आणि recovery support करणाऱ्या सगळ्या instance types वर सारखाच चालतो.
3. Lab 1: auto-recover आणि auto-reboot alarms
एक t3.micro (Amazon Linux 2023) फक्त EBS storage सह वापरा. फक्त EBS का: instance-store volumes असलेल्या instances वर recover चालत नाही.
Part A: system check वर recover
- CloudWatch → Alarms → Create alarm → Select metric → EC2 → Per-Instance Metrics → तुमचा ID → StatusCheckFailed_System.
- Statistic Maximum. Period 1 minute. का: basic monitoring असूनही status checks दर मिनिटाला येतात.
- Condition Greater/Equal
1. Datapoints2out of2. 2 का: एका विचित्र मिनिटावर react होत नाही. - Next → Add EC2 action → In alarm → Recover this instance. SNS topic
ops-alertsपण जोडा. - Name
web1-system-recover→ Create.
Part B: instance check वर reboot
- Create alarm → metric StatusCheckFailed_Instance, Maximum, 1 minute.
- Condition >=
1, datapoints3out of3. 3 का: recover alarm पेक्षा वेगळी evaluation length ठेवावी असं AWS सांगतं, म्हणजे दोन्ही एकाच क्षणी वाजत नाहीत. - EC2 action: Reboot this instance. SNS जोडा. Name
web1-instance-reboot.
aws cloudwatch put-metric-alarm --alarm-name web1-system-recover \
  --namespace AWS/EC2 --metric-name StatusCheckFailed_System \
  --dimensions Name=InstanceId,Value=i-0abc1234567890def \
  --statistic Maximum --period 60 --evaluation-periods 2 --datapoints-to-alarm 2 \
  --threshold 1 --comparison-operator GreaterThanOrEqualToThreshold \
  --alarm-actions arn:aws:automate:ap-south-1:ec2:recover arn:aws:sns:ap-south-1:111122223333:ops-alerts

aws cloudwatch put-metric-alarm --alarm-name web1-instance-reboot \
  --namespace AWS/EC2 --metric-name StatusCheckFailed_Instance \
  --dimensions Name=InstanceId,Value=i-0abc1234567890def \
  --statistic Maximum --period 60 --evaluation-periods 3 --datapoints-to-alarm 3 \
  --threshold 1 --comparison-operator GreaterThanOrEqualToThreshold \
  --alarm-actions arn:aws:automate:ap-south-1:ec2:reboot arn:aws:sns:ap-south-1:111122223333:ops-alerts
Part C: safely test करा
- AWS hardware तोडू शकत नाही, म्हणून forced state ने action test करा:
aws cloudwatch set-alarm-state --alarm-name web1-instance-reboot --state-value ALARM --state-reason "lab test"- Verify: ALARM email येतो, आणि server वर
uptimeनवीन boot (काही minutes) दाखवतो. पुढचा खरा check alarm परत OK करतो. - खरा instance-check failure बघायचा असेल तर टाकाऊ instance वर
sudo systemctl stop sshd; sudo ip link set ens5 downचालवा. काही minutes मध्ये instance check fail होतो आणि reboot alarm तो परत आणतो (बदल save नव्हता, त्यामुळे boot नंतर network येतं).
4. EBS volume status checks
हे का लागतं?
Disk वापरायला unsafe होऊ शकतो: AWS ला data inconsistent असू शकतो असं दिसतं. मग त्यावर लिहिलं तर data खराब होऊ शकतो.
हे काय आहे?
प्रत्येक EBS volume ला volume status असतो: ok, warning, impaired किंवा insufficient-data. हा EC2 → Volumes → Status checks मध्ये दिसणारा status check आहे, नेहमीचा CloudWatch metric नाही. AWS ला inconsistency दिसली तर ते I/O बंद करू शकतं ("auto-enable I/O" setting ठरवतं की I/O आपोआप परत चालू होईल का).
aws ec2 describe-volume-status --volume-ids vol-0abc1234567890def \
  --query 'VolumeStatuses[0].VolumeStatus'
# expected: {"Status": "ok", "Details": [{"Name": "io-enabled","Status":"passed"}, ...]}
Instance च्या बाजूने disk वर alarm लावायला StatusCheckFailed_AttachedEBS (AWS/EC2) वापरा. AWS सांगतं: Maximum, period 60 s, 10 out of 10. Volume-status events कळायला EBS Volume Notification events वर EventBridge rule बनवा आणि SNS ला पाठवा.
5. BurstBalance आणि VolumeQueueLength
हे का लागतं?
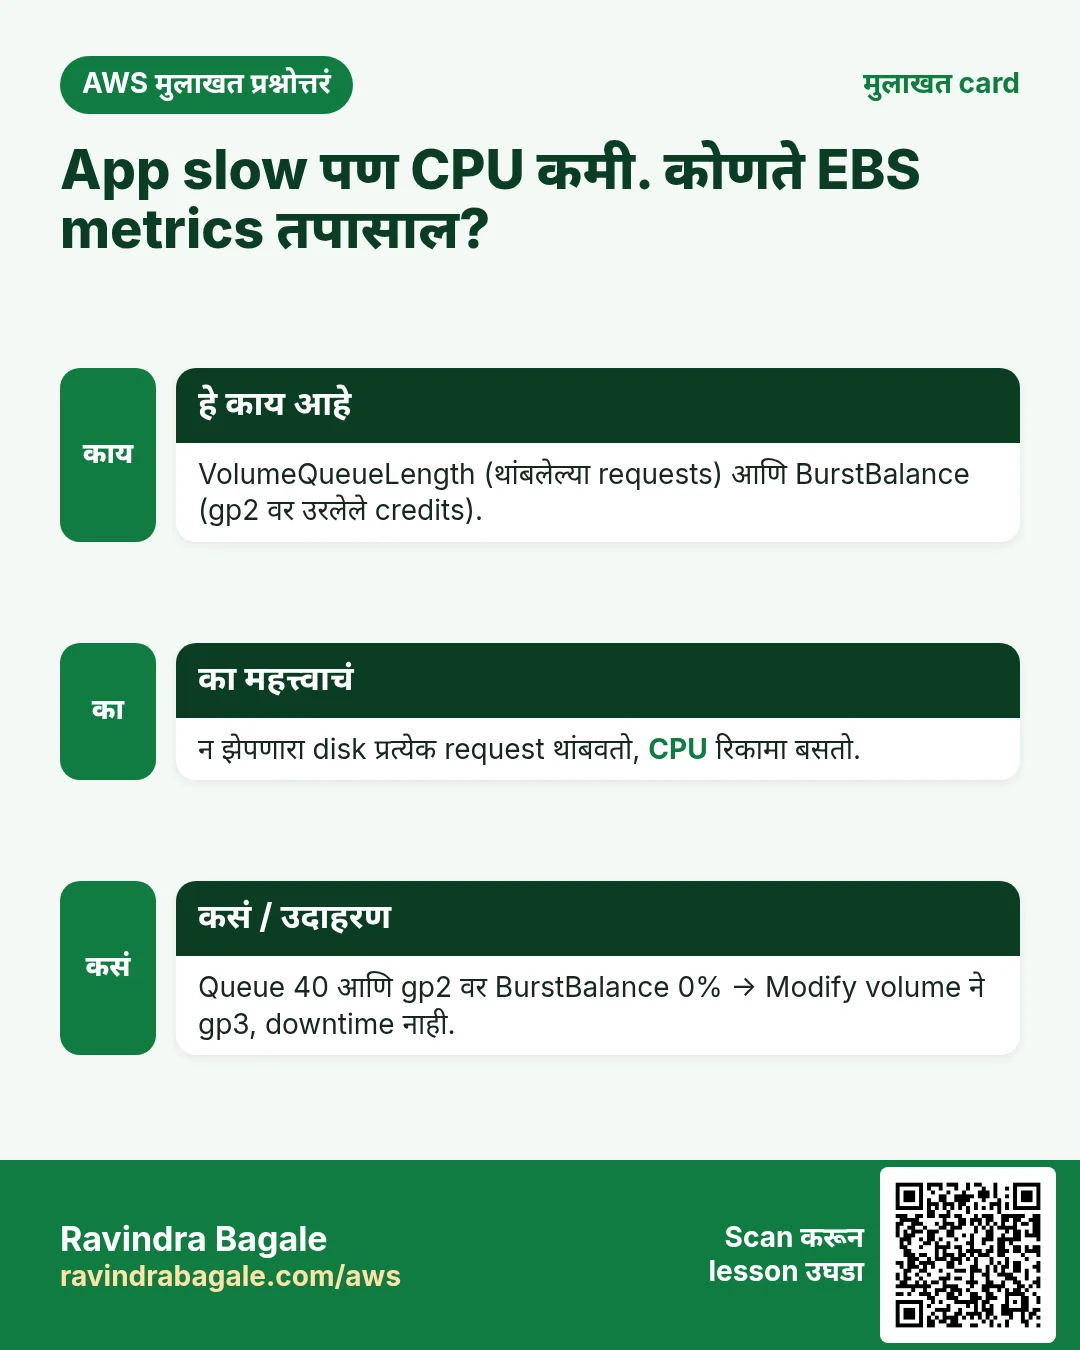
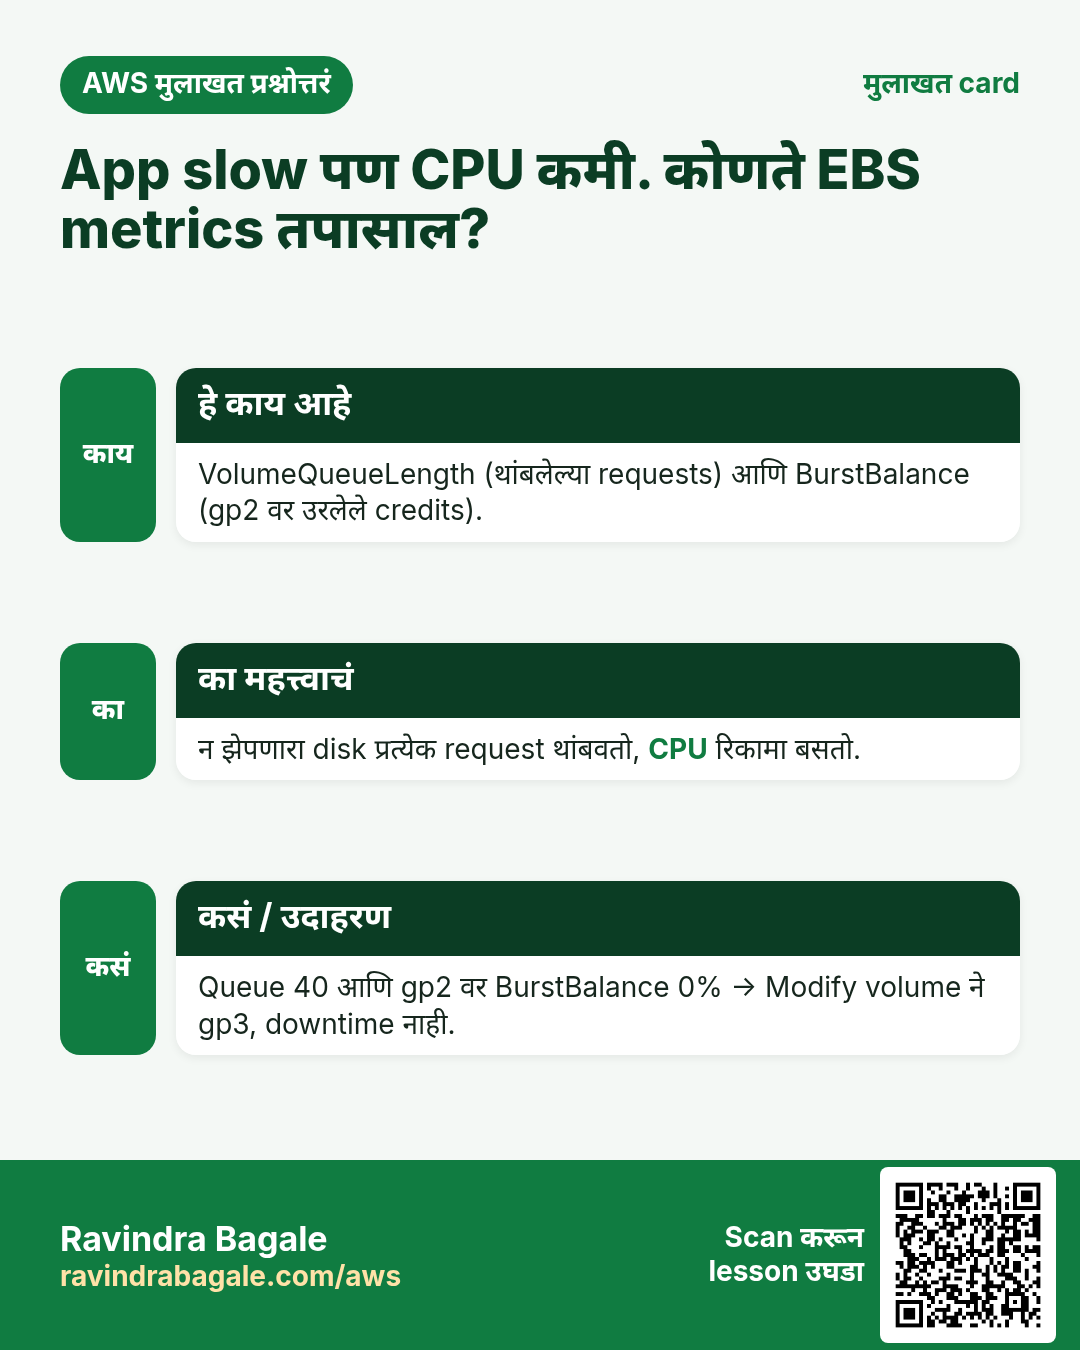
Slow disk मुळे प्रत्येक app slow होतं, पण CPU कमी राहतो, म्हणून CPU alarms शांत राहतात. हे दोन metrics disk चा त्रास थेट दाखवतात.
हे काय आहे?
| Metric (AWS/EBS) | सोपा अर्थ | कोणाला लागू | Alarm कल्पना |
|---|---|---|---|
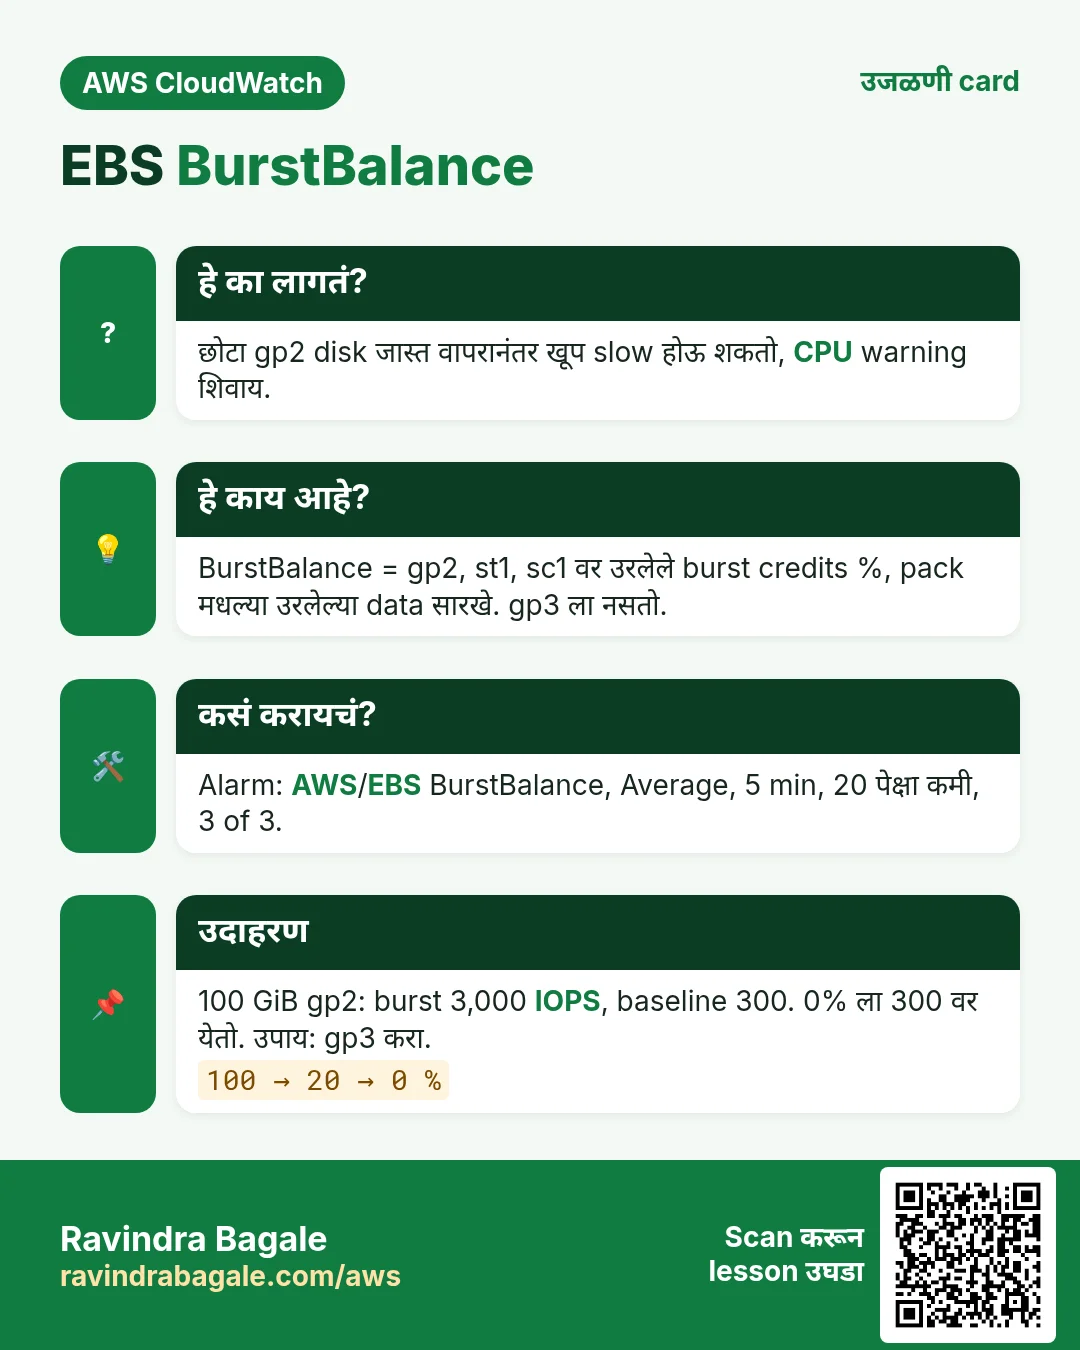
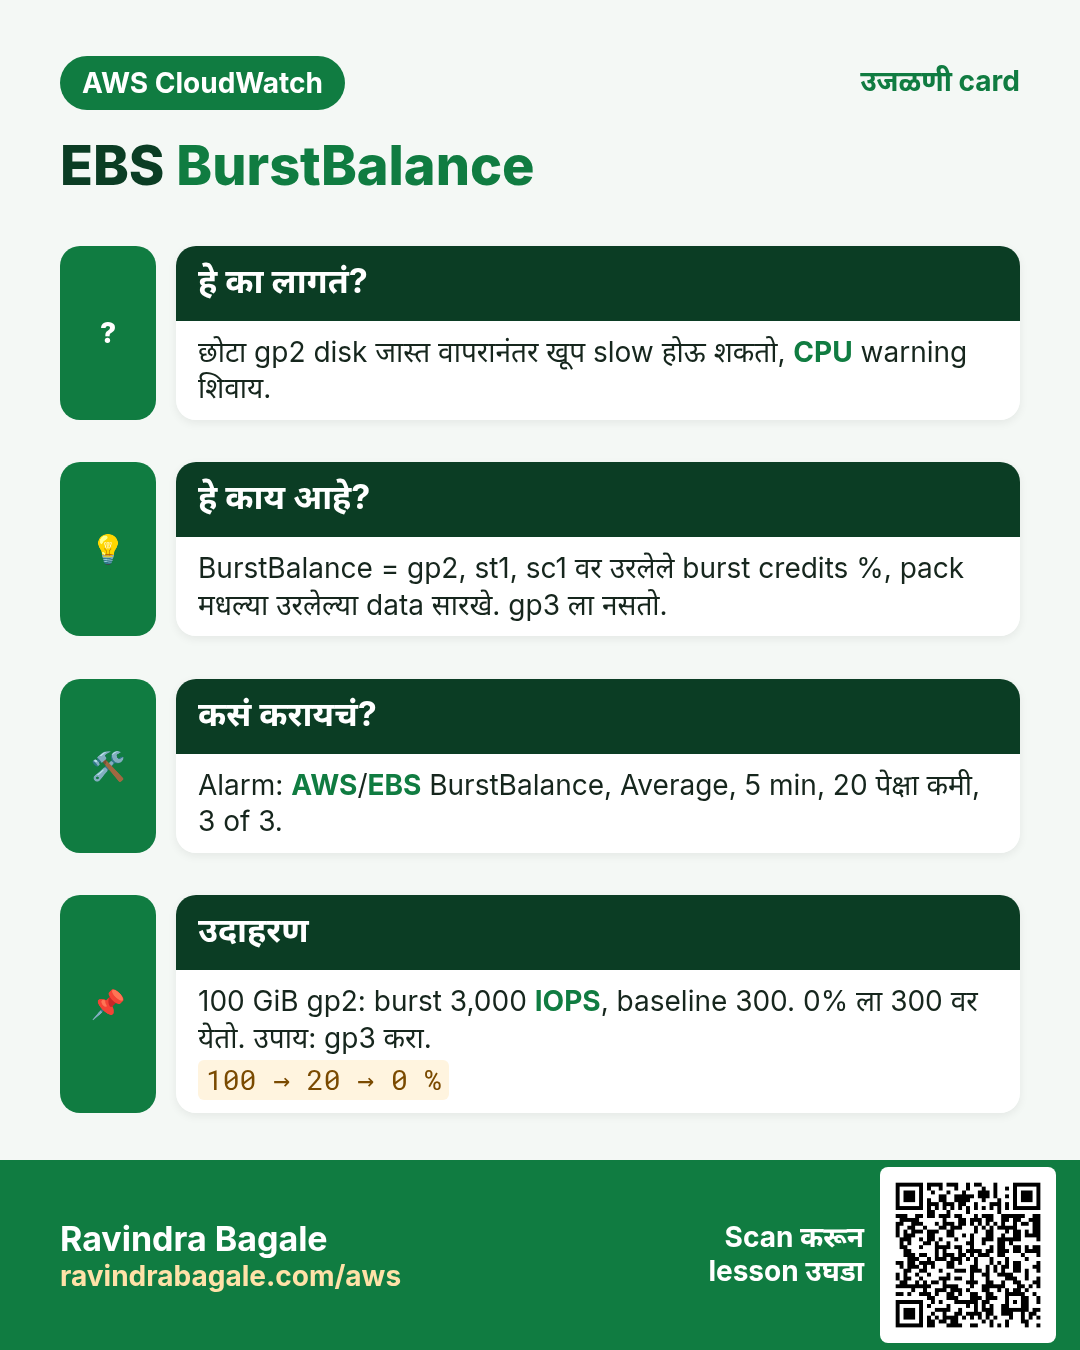
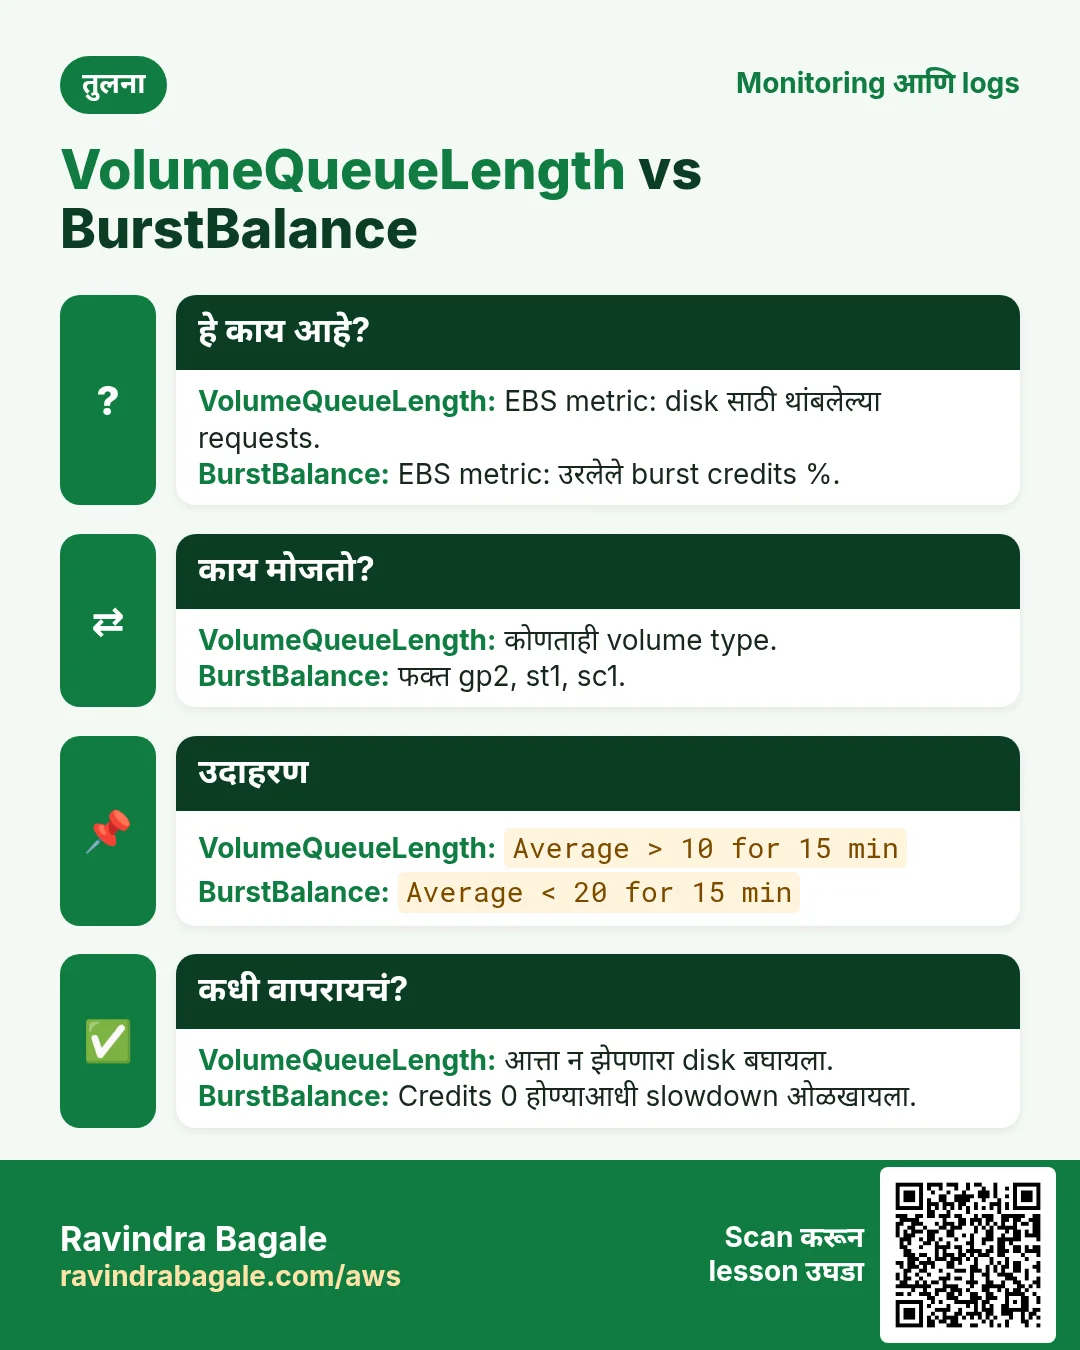
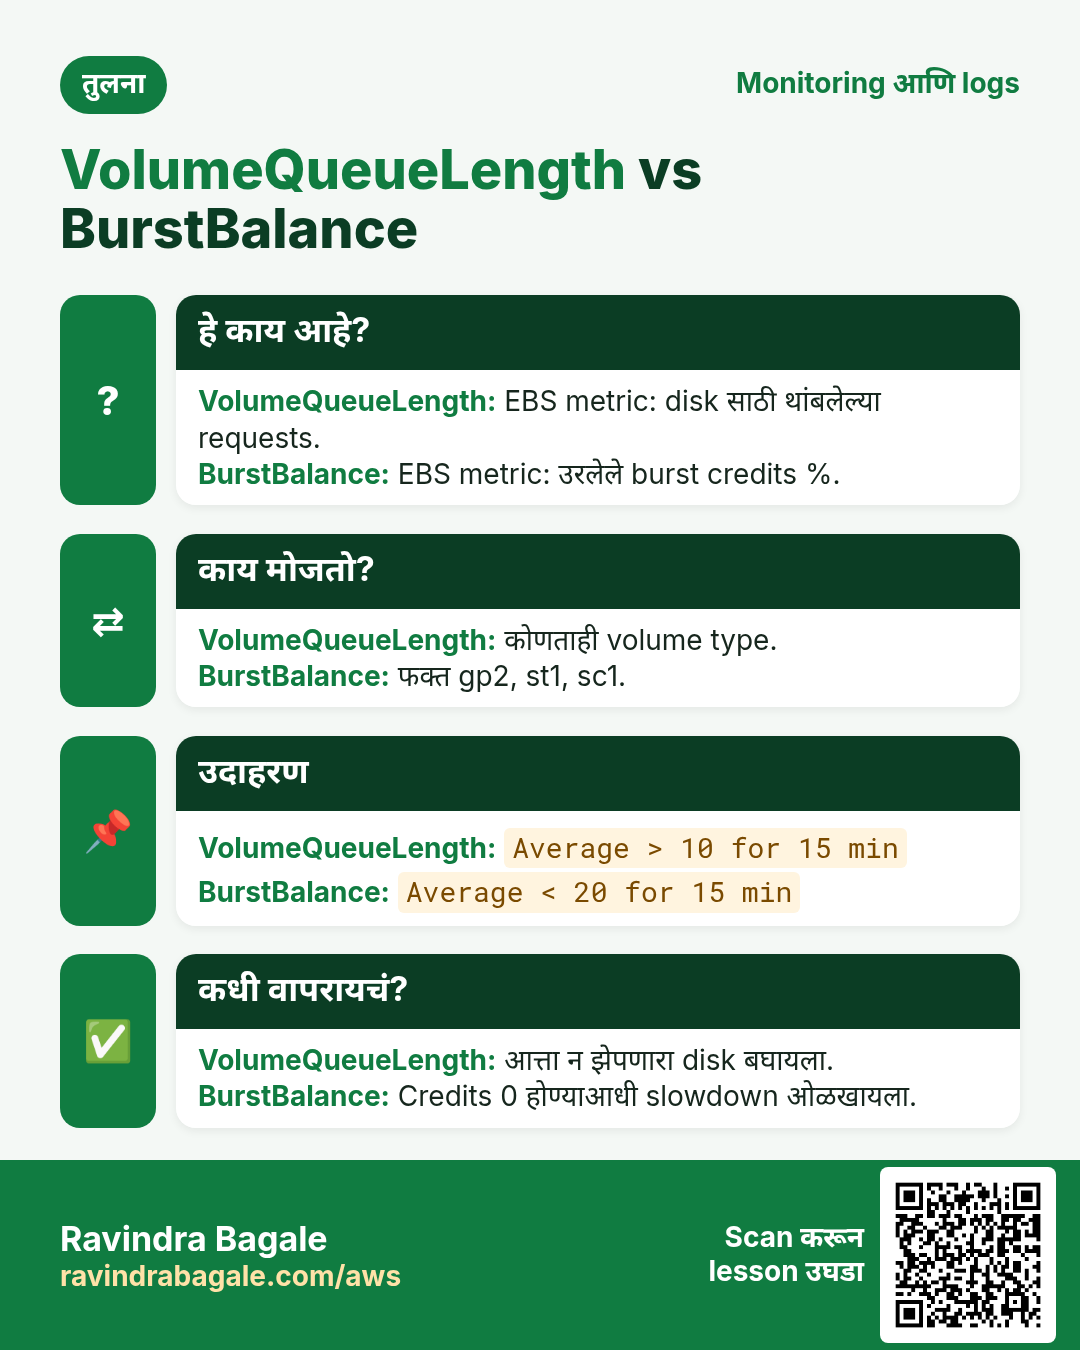
| BurstBalance | उरलेले burst credits %. Mobile pack मध्ये उरलेल्या data सारखं | gp2, st1, sc1 (gp3 नाही, त्याला burst bucket नाही) | 15 min Average < 20 |
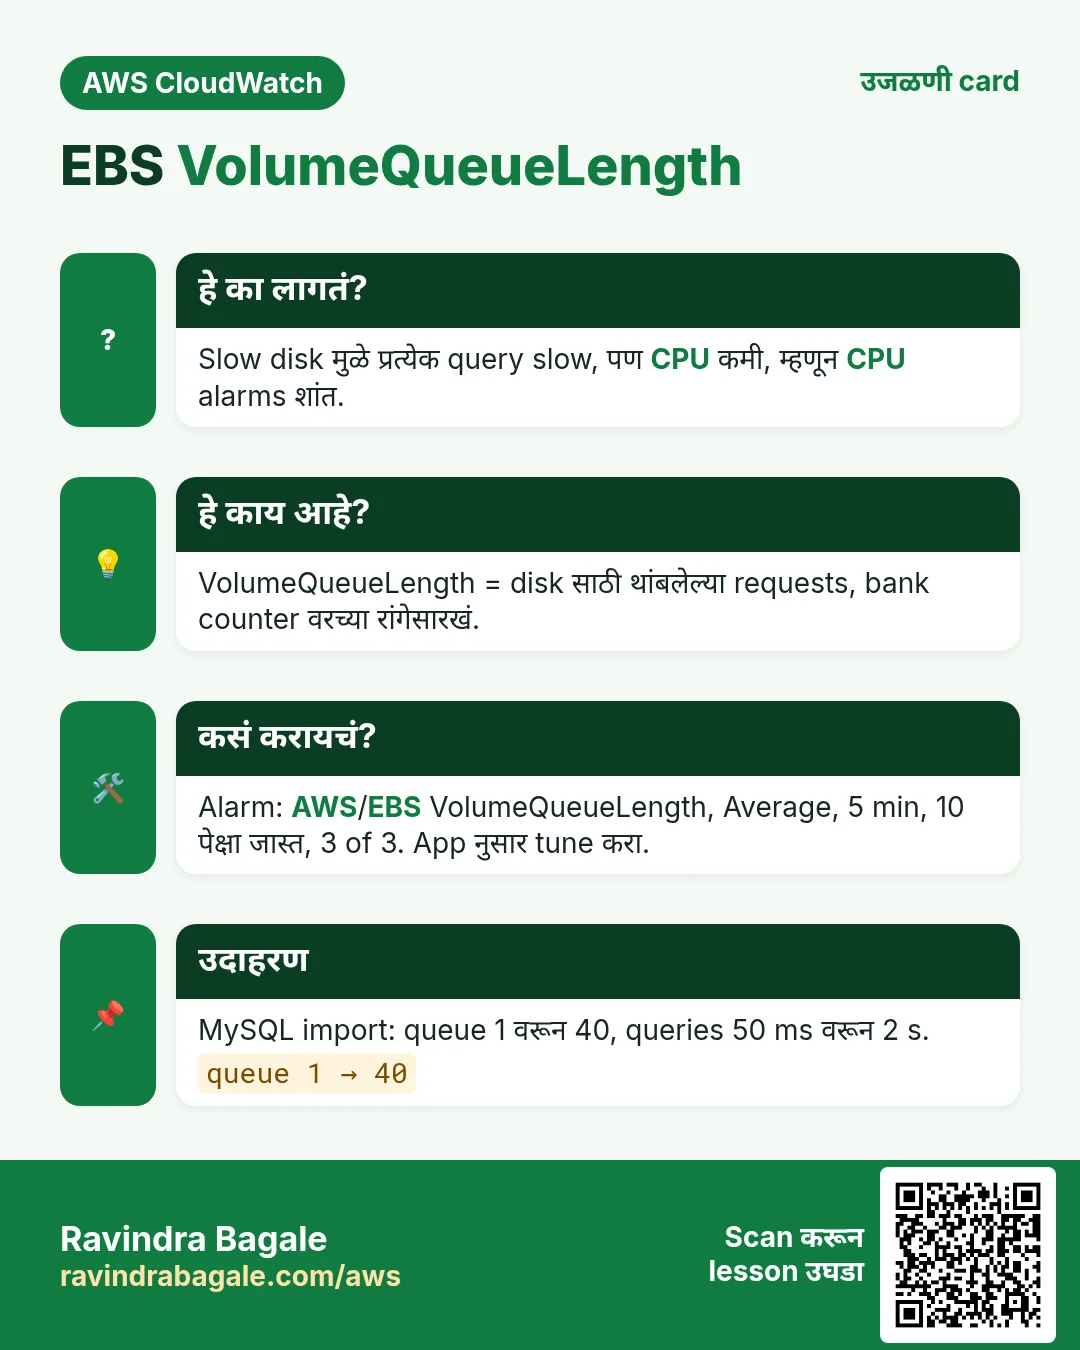
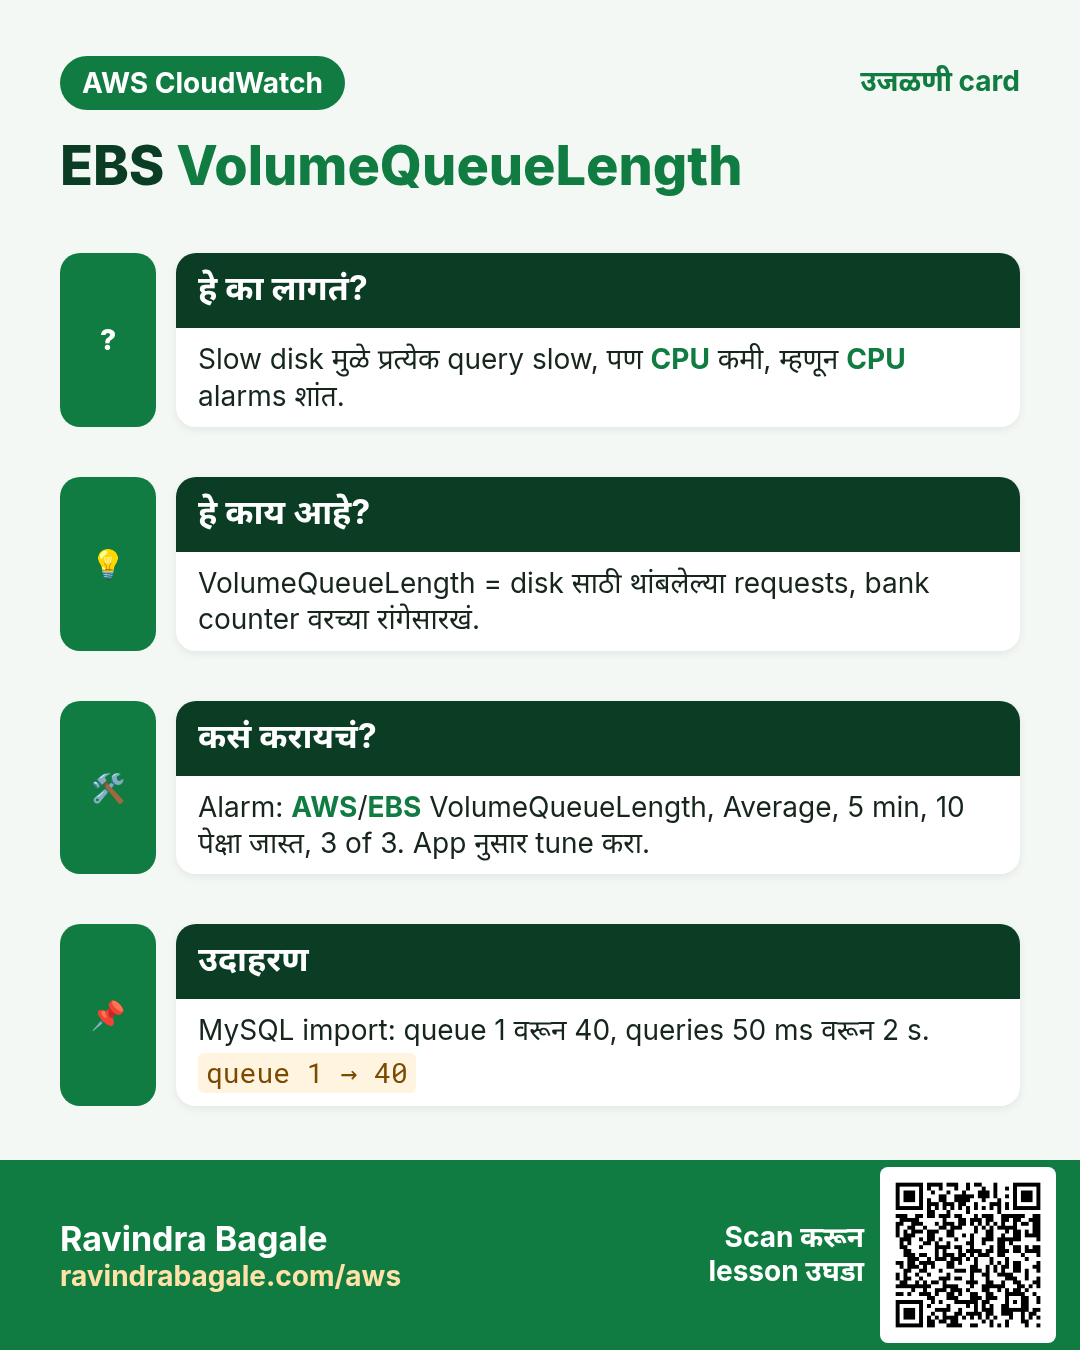
| VolumeQueueLength | Disk साठी थांबलेल्या requests. Bank counter वरच्या रांगेसारखं | सगळे types | 15 min Average > 10 (app नुसार tune करा) |
| VolumeIdleTime | I/O नसलेले seconds | सगळे | न वापरलेले disks शोधायला |
| VolumeReadOps / VolumeWriteOps | Read आणि write operations | सगळे | Period seconds ने भागल्यावर IOPS |
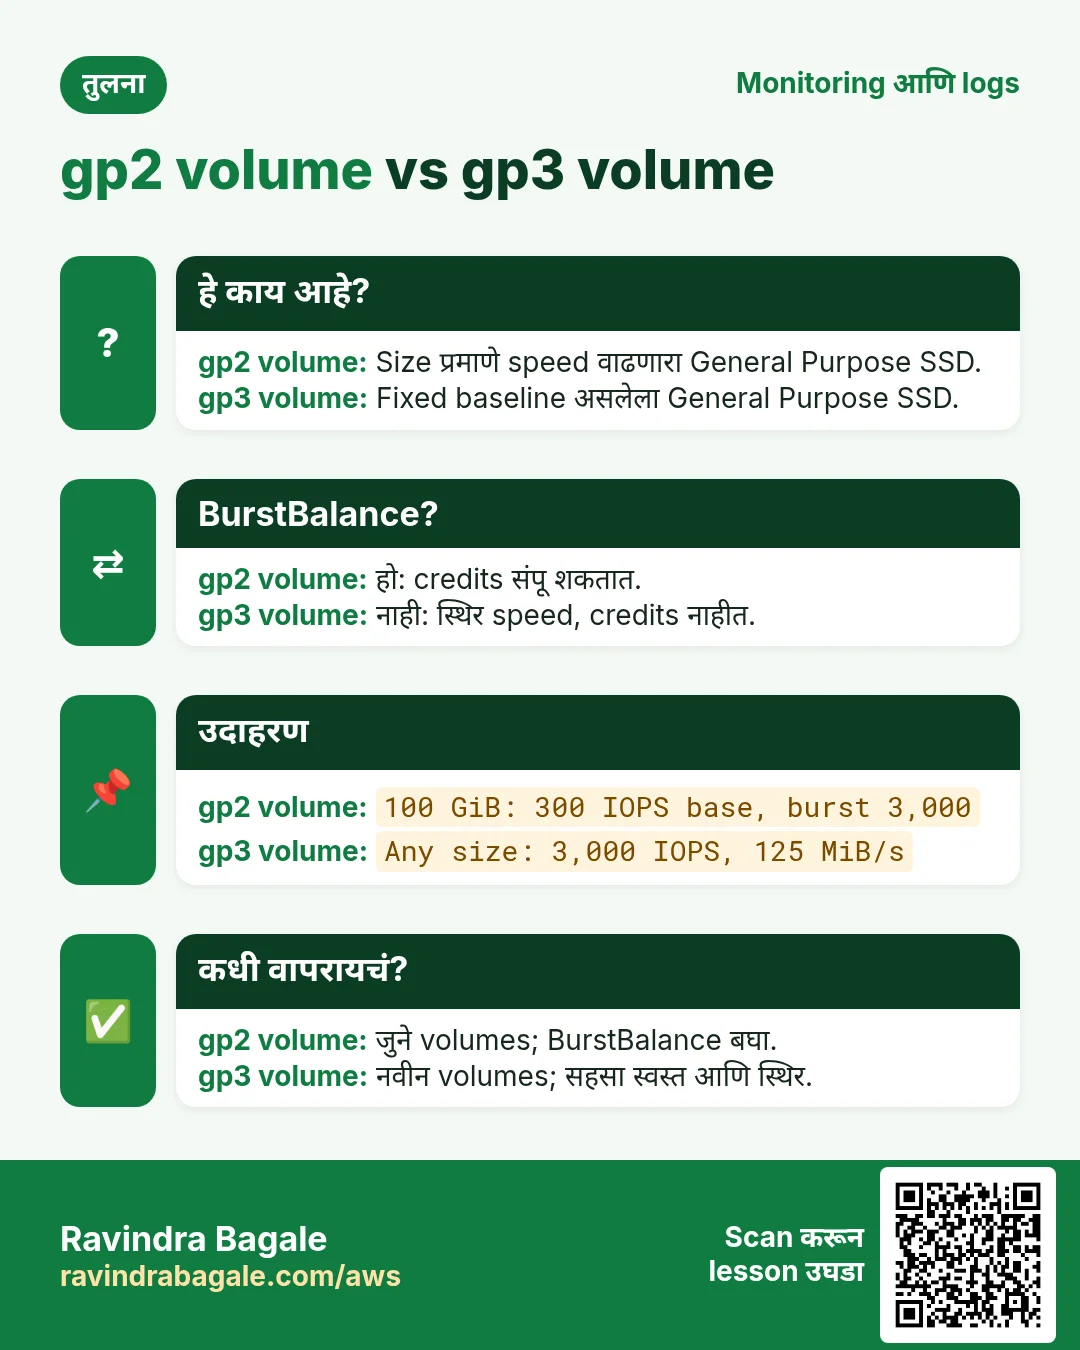
उदाहरण: 100 GiB gp2 volume चा baseline 300 IOPS आणि burst 3,000 पर्यंत. MySQL import 3,000 IOPS ने चालतो. BurstBalance 100 → 60 → 20 → 0. 0 झाल्यावर disk 300 IOPS वर येतो, queue 40 पर्यंत वाढते, आणि 50 ms लागणाऱ्या queries ना 2 s लागतात. 20% वरचा alarm वेळ देतो. उपाय: Modify volume ने volume gp3 करा (कोणत्याही size ला 3,000 IOPS baseline), downtime नाही.
Lab 2: EBS alarms
- EC2 → Volumes → instance चा root volume select करा → Volume ID copy करा आणि type (gp2 की gp3) बघा.
- CloudWatch → Create alarm → EBS → Per-Volume Metrics → तुमचा volume → VolumeQueueLength.
- Average, 5 minutes,
10पेक्षा Greater, 3 out of 3. SNSops-alerts. Nameweb1-disk-queue. - Volume gp2 असेल तर: BurstBalance वर दुसरा alarm, Average, 5 minutes,
20पेक्षा Lower, 3 out of 3. Nameweb1-burst-low. - Attached-EBS alarm CLI ने:
aws cloudwatch put-metric-alarm --alarm-name web1-attached-ebs \
  --namespace AWS/EC2 --metric-name StatusCheckFailed_AttachedEBS \
  --dimensions Name=InstanceId,Value=i-0abc1234567890def \
  --statistic Maximum --period 60 --evaluation-periods 10 --datapoints-to-alarm 10 \
  --threshold 1 --comparison-operator GreaterThanOrEqualToThreshold \
--alarm-actions arn:aws:sns:ap-south-1:111122223333:ops-alerts- Queue बघण्यासाठी disk busy करा:
sudo dnf install -y fio
sudo fio --name=q --filename=/tmp/fio.bin --size=1G --rw=randwrite --bs=4k --iodepth=64 --ioengine=libaio --direct=1 --runtime=600 --time_based
rm -f /tmp/fio.bin- Verify: volume च्या Monitoring tab मध्ये Average queue length वाढते; gp2 असेल तर burst balance कमी होतो. Queue alarm ALARM मध्ये जातो.
- Cleanup:
web1-system-recover,web1-instance-reboot,web1-disk-queue,web1-burst-low,web1-attached-ebsdelete करा; instance stop किंवा terminate करा.
6. Stack नुसार health alarms
| Server | हवेच असे health alarms |
|---|---|
| nginx / Apache web | System recover, instance reboot |
| EC2 वर MySQL / PostgreSQL | Recover, attached EBS, VolumeQueueLength, BurstBalance (gp2) |
| Java Spring / .NET app server | Instance reboot (memory hang), आणि agent memory alarm |
| Auto Scaling मधली Node.js / Python / Go API | Reboot alarm नको; group खराब instances बदलतो (EC2 किंवा ELB health checks) |
7. Interview questions
प्र. System vs instance status check?
System = AWS host problem, recover ने fix. Instance = तुमच्या OS चा problem, reboot ने किंवा OS दुरुस्त करून fix.
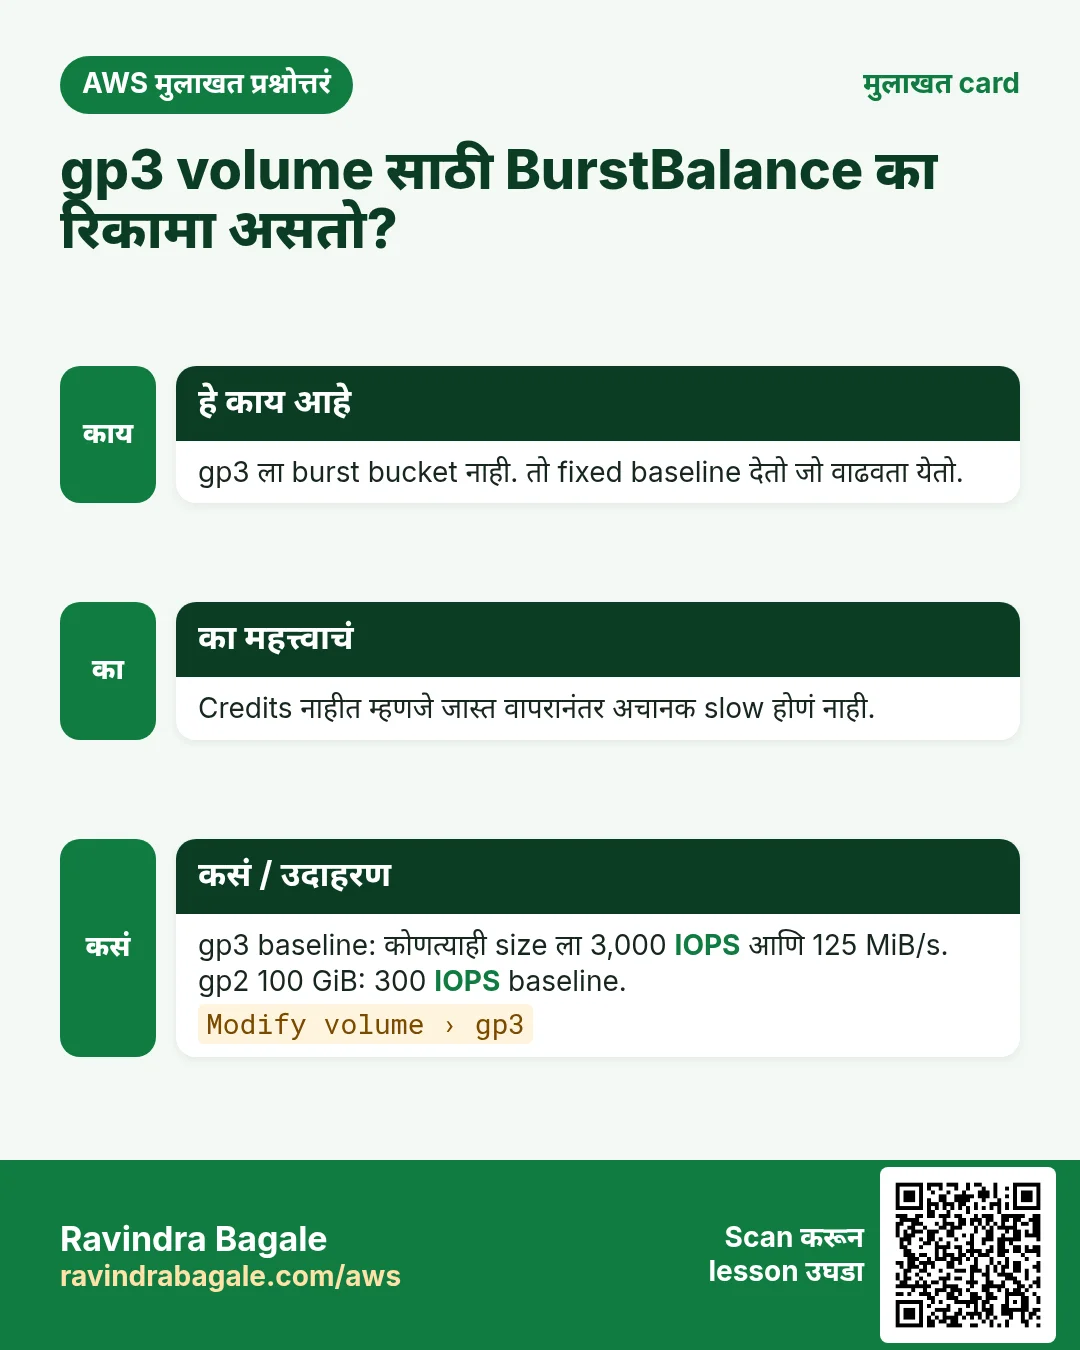
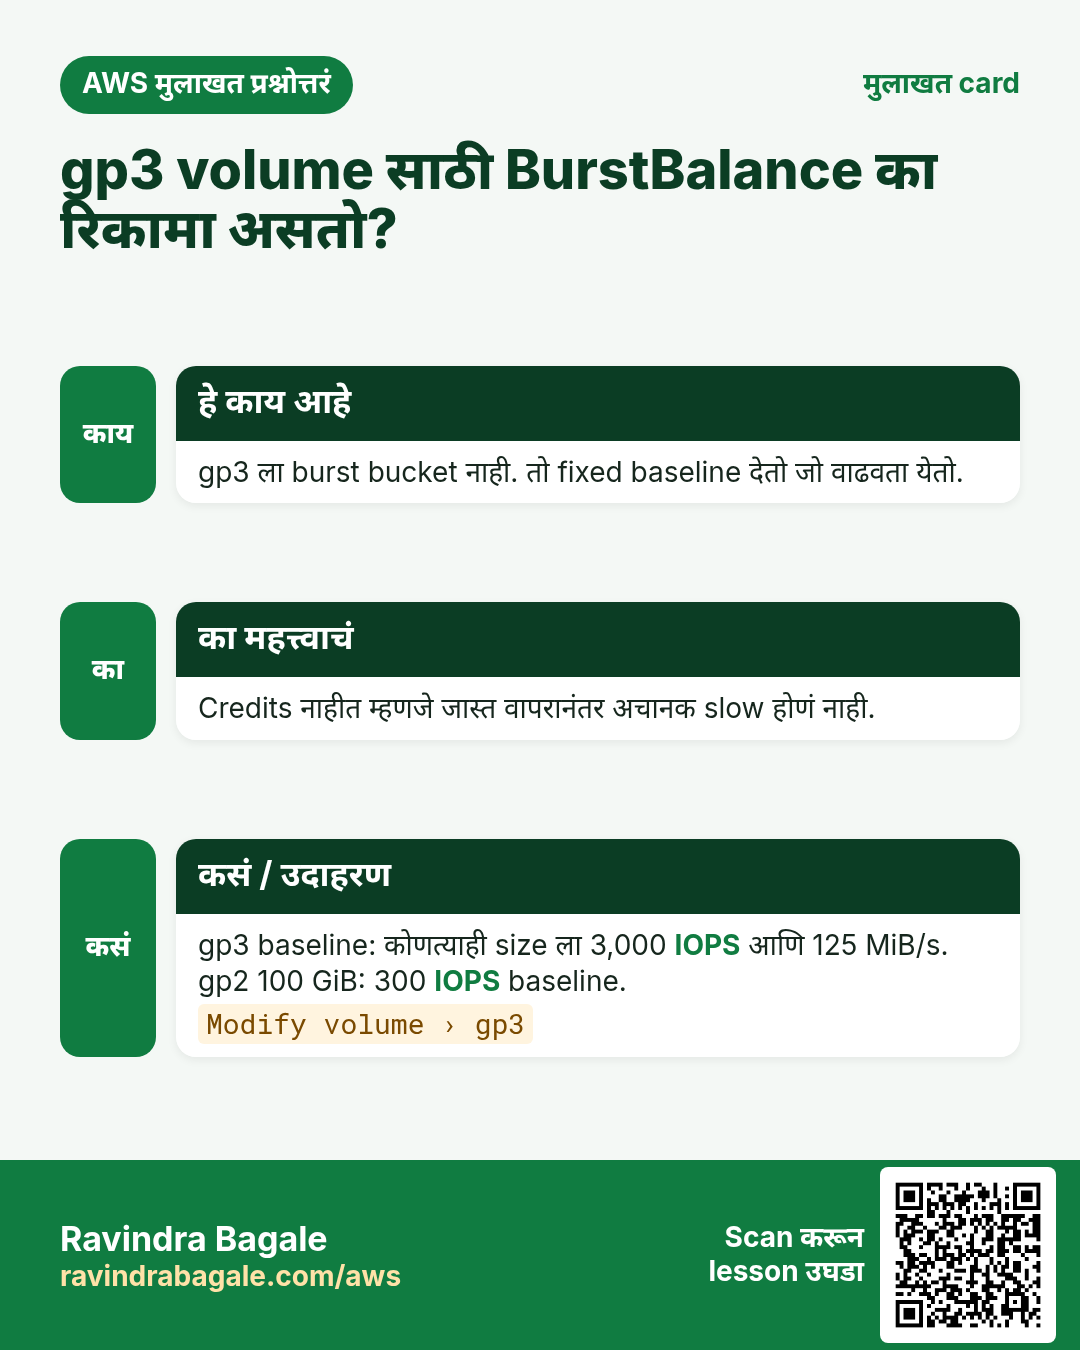
प्र. gp3 volume वर BurstBalance का नसतो?
gp3 ला burst bucket नाही. तो fixed baseline (3,000 IOPS, 125 MiB/s) देतो, जो वाढवता येतो.
प्र. Status check alarms साठी कोणता statistic?
Maximum, कारण value 0 किंवा 1 आहे आणि एक failure सुद्धा मोजला गेला पाहिजे.
घरी करून बघा
- तुमच्या एका lab server ला recover आणि reboot alarms लावा आणि set-alarm-state ने reboot test करा.
- छोट्या gp2 volume वर fio test चालवा आणि BurstBalance कमी होताना बघा. मग तो gp3 करा आणि queue कमी होताना बघा.
थोडक्यात सांगायचं तर
- StatusCheckFailed_System → recover; StatusCheckFailed_Instance → reboot.
- StatusCheckFailed_AttachedEBS instance कडून disks बघतो (फक्त Nitro); त्यासाठी recover चालत नाही.
- Volume status (ok/warning/impaired) हा check आहे, describe-volume-status ने दिसतो.
- BurstBalance (gp2/st1/sc1) आणि VolumeQueueLength CPU alarms ना न दिसणारे slow disks दाखवतात.
सराव Tasks
Patil Dairy हा कोल्हापूर मधला डेअरी व्यवसाय आहे. Sunita Patil त्यांचं IT व cloud काम पाहतात. त्यांचे पैसे INR मध्ये मोजले जातात आणि AWS resources ap-south-1 Region मध्ये चालतात. खालच्या tasks मध्ये तुम्ही या lesson मध्ये शिकलेलं वापरून त्यांची खरी कामं करता. सगळी नावं, account IDs, IP addresses व numbers सरावासाठी काल्पनिक आहेत.
0 / 11
सोपं SNS topic बनवा
का: Topic म्हणजे channel: एकदा publish, सगळ्या subscribers ना मिळतं.
काय करायचं: patildairy-alerts topic बनवा.
- Task वाचा आणि ते कोणत्या AWS service बद्दल आहे ते ठरवा.
- aws लिहा, मग service चं नाव, मग operation (action शब्द).
- प्रत्येक आवश्यक flag (--name) व त्यापुढे task मधली value लिहा.
- Flags कोणत्याही क्रमाने चालतात. Check answer दाबा.
सोपं Firing alarms दाखवा
का: Incident मध्ये आधी ALARM state मधले alarms पाहा.
काय करायचं: फक्त ALARM state असलेले alarms describe करा.
- Task वाचा आणि ते कोणत्या AWS service बद्दल आहे ते ठरवा.
- aws लिहा, मग service चं नाव, मग operation (action शब्द).
- प्रत्येक आवश्यक flag (--name) व त्यापुढे task मधली value लिहा.
- Flags कोणत्याही क्रमाने चालतात. Check answer दाबा.
सोपं Namespace मधले metrics दाखवा
का: Service साठी AWS कोणते metrics गोळा करतो ते पाहा.
काय करायचं: AWS/EC2 namespace मधले metrics दाखवा.
- Task वाचा आणि ते कोणत्या AWS service बद्दल आहे ते ठरवा.
- aws लिहा, मग service चं नाव, मग operation (action शब्द).
- प्रत्येक आवश्यक flag (--name) व त्यापुढे task मधली value लिहा.
- Flags कोणत्याही क्रमाने चालतात. Check answer दाबा.
सोपं एका topic वर publish
का: Alerting app ला फक्त publish लागतं.
काय करायचं: फक्त arn:aws:sns:ap-south-1:100444365147:patildairy-alerts वर sns:Publish allow करा.
- { "Version": "2012-10-17", "Statement": [ ... ] } ने सुरू करा.
- प्रत्येक statement मध्ये Effect, Action व Resource लिहा.
- Task ला लागेल तेवढंच द्या (least privilege).
- Double quotes व commas नीट वापरा. Check answer दाबा.
मध्यम Email subscribe करा
का: Email subscribers नी messages मिळण्याआधी confirm link दाबावी लागते.
काय करायचं: ops@patildairy.in ला email ने arn:aws:sns:ap-south-1:100444365147:patildairy-alerts वर subscribe करा.
- Task वाचा आणि ते कोणत्या AWS service बद्दल आहे ते ठरवा.
- aws लिहा, मग service चं नाव, मग operation (action शब्द).
- प्रत्येक आवश्यक flag (--name) व त्यापुढे task मधली value लिहा.
- Flags कोणत्याही क्रमाने चालतात. Check answer दाबा.
मध्यम Custom metric publish करा
का: Custom metrics ने business numbers वर graph व alarm करता येतो.
काय करायचं: Namespace PatilDairy/Shop मध्ये OrdersPlaced metric value 6 सह publish करा.
- Task वाचा आणि ते कोणत्या AWS service बद्दल आहे ते ठरवा.
- aws लिहा, मग service चं नाव, मग operation (action शब्द).
- प्रत्येक आवश्यक flag (--name) व त्यापुढे task मधली value लिहा.
- Flags कोणत्याही क्रमाने चालतात. Check answer दाबा.
मध्यम Target health तपासा
का: Targets unhealthy असल्यास site 502/503 errors दाखवते.
काय करायचं: arn:aws:elasticloadbalancing:ap-south-1:100444365147:targetgroup/patildairy-tg/6d0ecf831eec9f09 मधल्या targets चं health दाखवा.
- Task वाचा आणि ते कोणत्या AWS service बद्दल आहे ते ठरवा.
- aws लिहा, मग service चं नाव, मग operation (action शब्द).
- प्रत्येक आवश्यक flag (--name) व त्यापुढे task मधली value लिहा.
- Flags कोणत्याही क्रमाने चालतात. Check answer दाबा.
मध्यम Instance status checks तपासा
का: System व instance status checks AWS hardware की तुमच्या OS मध्ये problem ते सांगतात.
काय करायचं: Instance i-0b415a34440011a2b चे status checks दाखवा.
- Task वाचा आणि ते कोणत्या AWS service बद्दल आहे ते ठरवा.
- aws लिहा, मग service चं नाव, मग operation (action शब्द).
- प्रत्येक आवश्यक flag (--name) व त्यापुढे task मधली value लिहा.
- Flags कोणत्याही क्रमाने चालतात. Check answer दाबा.
मध्यम Kubernetes LoadBalancer Service
का: LoadBalancer Service ला AWS load balancer मिळतो.
काय करायचं: app: web select करणारी LoadBalancer Service, port 80 → targetPort 8080.
- Task मधल्या top-level keys पासून सुरू करा.
- Child keys 2 spaces ने indent करा (tabs नकोत).
- प्रत्येक property मध्ये task मधली value भरा.
- Check answer दाबा. Keys चा क्रम महत्त्वाचा नाही.
अवघड CPU alarm बनवा
का: Alarm metric पाहतो व users ला कळण्याआधी तुम्हाला कळवतो.
काय करायचं: patildairy-cpu-high alarm बनवा: AWS/EC2 CPUUtilization, 300 seconds चा Average, 1 evaluation period, GreaterThanThreshold 80, InstanceId=i-0b415a34440011a2b साठी, arn:aws:sns:ap-south-1:100444365147:patildairy-alerts ला notify.
- Task वाचा आणि ते कोणत्या AWS service बद्दल आहे ते ठरवा.
- aws लिहा, मग service चं नाव, मग operation (action शब्द).
- प्रत्येक आवश्यक flag (--name) व त्यापुढे task मधली value लिहा.
- Flags कोणत्याही क्रमाने चालतात. Check answer दाबा.
अवघड Alarm ने instance auto-recover करा
का: System check fail झाल्यास recover action instance healthy hardware वर हलवतो.
काय करायचं: patildairy-recover alarm बनवा: AWS/EC2 StatusCheckFailed_System, 60 s चा Maximum, 2 periods, GreaterThanOrEqualToThreshold 1, InstanceId=i-0b415a34440011a2b, action arn:aws:automate:ap-south-1:ec2:recover.
- Task वाचा आणि ते कोणत्या AWS service बद्दल आहे ते ठरवा.
- aws लिहा, मग service चं नाव, मग operation (action शब्द).
- प्रत्येक आवश्यक flag (--name) व त्यापुढे task मधली value लिहा.
- Flags कोणत्याही क्रमाने चालतात. Check answer दाबा.
उजळणी, तुलना आणि मुलाखत cards
हा lesson काही मिनिटांत revise करा. Cards phone वर save करा किंवा PNG download करा. प्रत्येक card वरचा QR हा lesson उघडतो.
अजून cards: Ravi Sir's Cards.