Beginners साठी SQL SELECT Query Examples
पहिल्या SQL chapter मध्ये आपण rows साठवल्या. खरी apps जास्त वेळ त्या rows ना प्रश्न विचारण्यात घालवतात: Pune मध्ये कोणते users राहतात, सगळ्यात मोठे तीन कोण, कुणाचं नाव "r" ने सुरू होतं, प्रत्येक department चा एकूण पगार किती. या chapter मध्ये आपण हे सगळे प्रश्न एकाच command ने, SELECT आणि त्याच्या clauses ने सोडवू. शेवटी UPDATE ने data बदलू आणि ते ALTER TABLE पेक्षा कसं वेगळं आहे ते बघू.
या class मध्ये काय शिकणार
- Repeat काढायला
DISTINCT, आणि output मधल्या column ला नवं नाव द्यायलाAS ASC(default),DESCआणि एकापेक्षा जास्त columns सहORDER BY=,!=,<>,<,>,<=,>=सहWHERE, आणिAND/ORIN,BETWEEN(दोन्ही टोकं धरून, text वर सुद्धा),IS NULL/IS NOT NULL, आणि%व_सहLIKELIMITआणिOFFSET- पैशासाठी
DECIMAL(10,2)असलेलाemptable, आणिMAX,MIN,SUM,AVG,COUNT(*)विरुद्धCOUNT(column) - Subqueries: सगळ्यात जास्त, सगळ्यात कमी आणि second-highest salary
GROUP BYआणिHAVING, आणिHAVINGहाWHEREपेक्षा कसा वेगळा- Data बदलायला
UPDATE ... SET ... WHERE, आणि तेALTER TABLEपेक्षा कसं वेगळं
1. Practice data
का: खालच्या प्रत्येक query चा result दिलेला आहे. तुम्ही याच दहा rows टाकल्या, तर तुम्हाला अगदी तीच उत्तरं मिळतील आणि स्वतः तपासता येईल.
कसं:
mysql -u root -pने login करा.-
Practice साठी नवीन database बनवा आणि त्यात जा:
CREATE DATABASE practice; USE practice; -
पहिल्या SQL chapter मधला ओळखीचा
userstable बनवा:CREATE TABLE users (id INT, name VARCHAR(100), city VARCHAR(50), age INT); -
एकाच
INSERTमध्ये दहा rows टाका:INSERT INTO users VALUES (1, 'ravi', 'solapur', 30), (2, 'zoya', 'pune', NULL), (3, 'siya', 'pune', 27), (4, 'maya', 'mumbai', 25), (5, 'amit', 'nashik', 20), (6, 'neha', 'mumbai', 25), (7, 'kiran', 'delhi', 37), (8, 'priya', 'solapur', 22), (9, 'arjun', 'dubai', 37), (10, 'ravi', 'nashik', 28); -
SELECT * FROM users;सगळ्या दहा rows दाखवतो.
पुढे लागणाऱ्या दोन गोष्टी लक्षात ठेवा: ravi नावाचे दोन users आहेत (एक Solapur चा, एक Nashik चा), आणि zoya ची age NULL आहे.
2. DISTINCT: प्रत्येक value एकदाच
का: SELECT city FROM users; प्रत्येक row ची एक city देतो, म्हणून pune, mumbai, solapur आणि nashik प्रत्येकी दोनदा येतात. "आपले users कोणत्या cities मध्ये राहतात?" याचं उत्तर हवं असेल, तर प्रत्येक city एकदाच पाहिजे.
काय: DISTINCT result मधून repeat झालेल्या rows काढतो. Table स्वतः बदलत नाही.
Classroom line
Unique means it appears only once; it must not repeat again and again.
Class मधलं वाक्य
Unique म्हणजे फक्त एकदाच यायला पाहिजे, परत परत repeat व्हायला नको.
Classroom line – हिंदी
"Unique matlab sirf ek bar aana chahiye, bar bar repeat nahi hona chahiye."
कसं:
SELECT city FROM users;10 rows देतो.SELECT DISTINCT city FROM users;6 rows देतो:solapur,pune,mumbai,nashik,delhi,dubai.SELECT DISTINCT name FROM users;9 नावं देतो:raviएकदाच येतो.SELECT DISTINCT age FROM users;8 values देतो, आणिNULLसुद्धा त्यातली एक value म्हणून मोजली जाते.DISTINCTलगेचSELECTनंतर येतो आणि तुम्ही select केलेल्या पूर्ण row वर चालतो.SELECT DISTINCT city, age FROM users;9 rows देतो: फक्तmumbai | 25ही जोडी दोनदा होती (maya आणि neha), म्हणून फक्त ती एकदा दिसते.
3. AS: column ला nickname
का: city किंवा SUM(salary) सारख्या headings तुम्हाला चालतात, पण report किंवा app ला जास्त स्पष्ट नावं लागू शकतात.
काय: AS column ला फक्त या एका query च्या output मध्ये नवं नाव देतो. Table मधली खरी column नावं तशीच राहतात.
Classroom line
An alias is like an "also known as", a nickname.
Class मधलं वाक्य
Alias म्हणजे "उर्फ", nickname सारखं.
Classroom line – हिंदी
"Alias matlab urf, ya nickname jaisa."
कसं:
SELECT city AS gaav, name AS naav FROM users;gaavआणिnaavheadings दाखवतो.DESC users;अजूनहीcityआणिnameच दाखवतो. Table मध्ये काहीच बदललं नाही.- Alias मध्ये space असेल तर quotes लागतात:
SELECT name AS 'full name' FROM users; - Aliases calculations बरोबर सगळ्यात उपयोगी, उदा. या chapter मध्ये पुढे येणारं
SELECT MAX(salary) AS highest FROM emp;
Figure 1. SELECT city repeat सह 10 rows देतो; SELECT DISTINCT city प्रत्येक city एकदाच देतो; AS फक्त output मधलं heading बदलतो.
4. ORDER BY: result sort करा
का: ORDER BY शिवाय MariaDB त्याला सोयीच्या क्रमाने rows देतो. Users A ते Z, किंवा सगळ्यात मोठे आधी हवे असतील, तर तसं सांगावं लागतं.
काय: ORDER BY हा SELECT चा एक clause आहे. तो FROM नंतर येतो (आणि WHERE असेल तर त्याच्याही नंतर).
ASCम्हणजे ascending: A ते Z, लहान number आधी. हा default आहे, म्हणून तो क्वचितच type करावा लागतो.DESCम्हणजे descending: Z ते A, मोठा number आधी.NULLसगळ्यात लहान value म्हणून धरला जातो:ASCमध्ये तो आधी येतो आणिDESCमध्ये शेवटी.
Classroom line
When we don't say anything, it is ascending by default.
Class मधलं वाक्य
आपण काही सांगितलं नाही, तर default ने ascending होतं.
Classroom line – हिंदी
"Jab hum kuch nahi bolte toh by default ascending hota hai."
कसं:
SELECT name, age FROM users ORDER BY age;आधी zoya (NULL), मग 20, 22, 25 ... असं 37 पर्यंत देतो.SELECT name, age FROM users ORDER BY age DESC;आधी 37 वर्षांचे, आणि zoya शेवटी.SELECT * FROM users ORDER BY name;नावं A ते Z sort करतो.SELECT * FROM users ORDER BY id DESC;सगळ्यात नवीन ids आधी दाखवतो.-
दोन users चं नाव ravi आहे. कोणता ravi आधी हे ठरवायला दुसरा column जोडा:
SELECT name, city FROM users ORDER BY name, city; -
आता
ravi | nashikहेravi | solapurच्या आधी येतं. दुसरा column फक्त पहिला सारखा असेल तेव्हाच वापरला जातो. - प्रत्येक column ला स्वतःची दिशा देता येते:
ORDER BY name, city DESCनावं A ते Z, आणि दोन ravi साठी cities Z ते A. - अगदी सारख्या sort value च्या rows (दोन 37 वर्षांचे) यांचा आपसातला क्रम ठरलेला नसतो. क्रम महत्त्वाचा असेल तर अजून एक column जोडा.
Classroom line
When names repeat, those rows should be ordered by the city column.
Class मधलं वाक्य
"Jevha nava duplicate astil, tevha city chya column ne ordering vhayla pahije."
जेव्हा नावं duplicate असतील, तेव्हा city च्या column ने ordering व्हायला पाहिजे.
Classroom line
When names repeat, those rows should be ordered by the city column.
Figure 2. Animation: ORDER BY age (ascending, NULL आधी), ORDER BY age DESC (NULL शेवटी), आणि ORDER BY name, city जिथे दोन ravi मधला tie city सोडवतो.
5. WHERE: फक्त हव्या त्या rows ठेवा
का: App ला जवळजवळ कधीच सगळ्या rows लागत नाहीत. "Mumbai चे users दाखवा" किंवा "27 किंवा कमी वयाचे users" म्हणजे filter करणं.
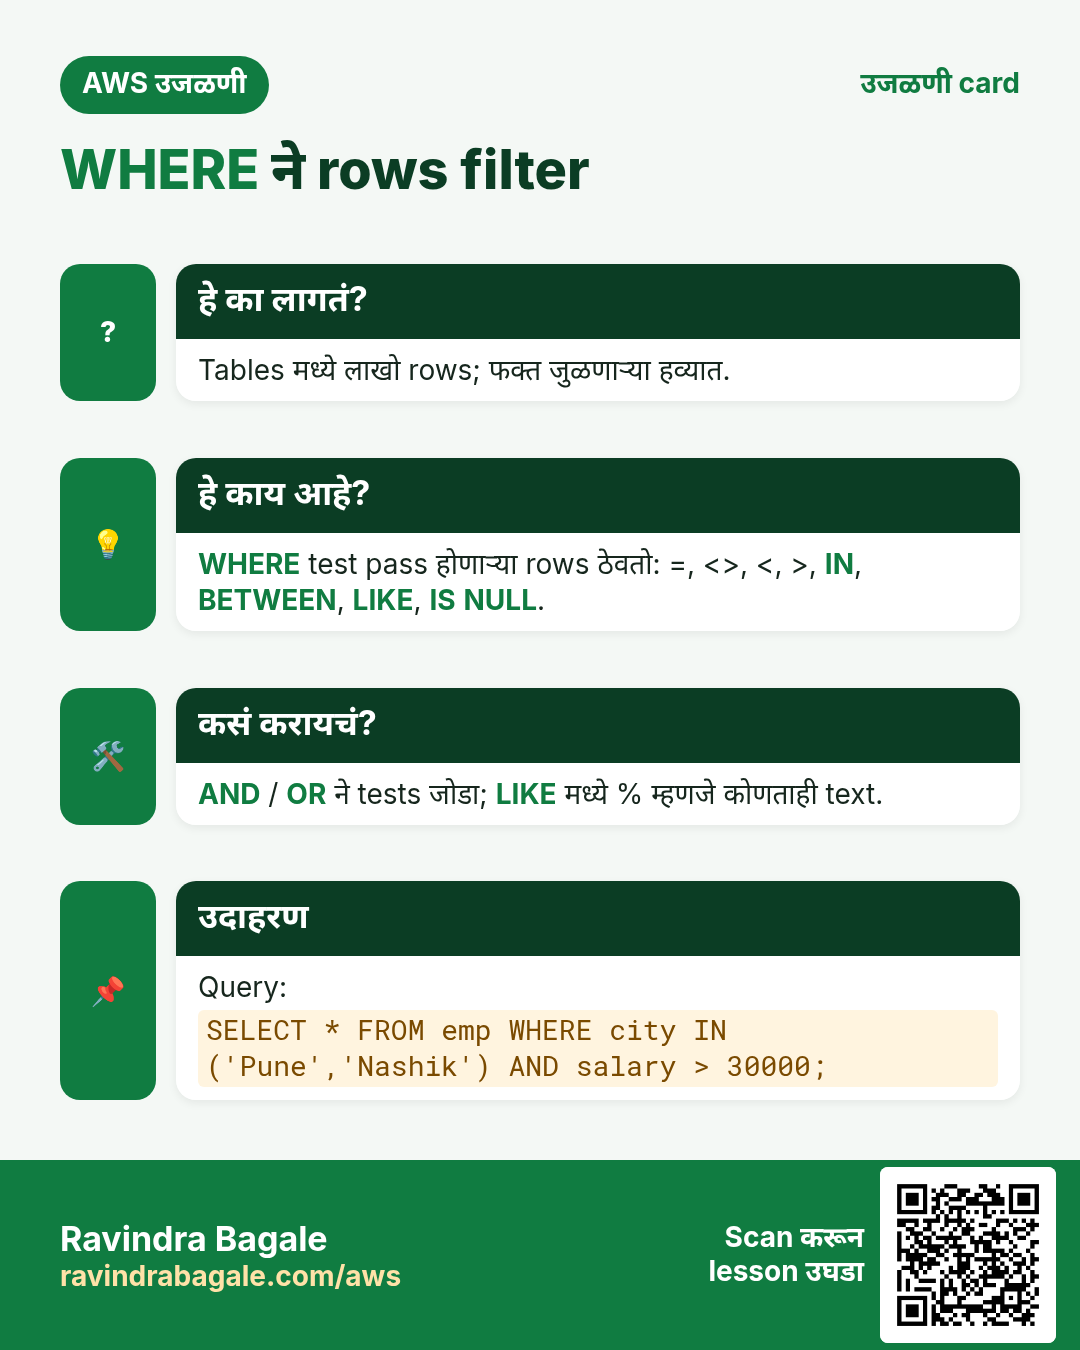
काय: WHERE FROM नंतर येतो आणि condition खरी असलेल्या rows च ठेवतो.
- Text values quotes मध्ये:
city = 'mumbai'. - Numbers quotes शिवाय:
age = 37.
Classroom line
If the value is text, we write it inside single or double quotes.
Class मधलं वाक्य
Value text मध्ये असेल, तर single quote किंवा double quote च्या आत लिहायची.
Classroom line – हिंदी
"Value agar text me hai, to single quote ya double quote ke andar likhenge."
कसं: comparison operators, प्रत्येकाचं आपल्या data वर उदाहरण:
=बरोबर:SELECT * FROM users WHERE city = 'mumbai';ने maya आणि neha.!=बरोबर नाही:SELECT * FROM users WHERE city != 'mumbai';ने उरलेल्या 8 rows.<>हा "बरोबर नाही" लिहायचा दुसरा मार्ग:WHERE city <> 'mumbai'ने त्याच 8 rows.- Condition च्या आधी
NOTसुद्धा चालतो:WHERE NOT city = 'mumbai'. <पेक्षा कमी:WHERE age < 25ने amit (20) आणि priya (22).>पेक्षा जास्त:WHERE age > 30ने kiran आणि arjun (37).<=कमी किंवा बरोबर:WHERE age <= 27ने siya, maya, amit, neha आणि priya.>=जास्त किंवा बरोबर:WHERE age >= 30ने ravi (30), kiran आणि arjun.- दोन characters चे operators याच क्रमाने लिहा:
<=आणि>=, कधीच=<किंवा=>नाही.
Figure 3. =, != किंवा <>, <, >, <= आणि >= सह WHERE, प्रत्येकाचं users table वर उदाहरण आणि मिळणाऱ्या rows.
6. AND आणि OR: एकापेक्षा जास्त conditions
का: खऱ्या filters मध्ये क्वचितच एकच condition असते: "25 पेक्षा मोठे Pune चे users". AND result लहान करतो, OR मोठा करतो, आणि गोंधळ झाला तर चुकीच्या rows येतात.
काय:
AND: दोन्ही conditions खऱ्या पाहिजेत.OR: किमान एक condition खरी पाहिजे.
Classroom line
If both conditions must be true, use AND.
Class मधलं वाक्य
दोन्ही conditions खऱ्या पाहिजेत, तर AND लावायचं.
Classroom line – हिंदी
"Agar dono condition sahi honi chahiye, to AND lagane ka."
कसं:
SELECT * FROM users WHERE city = 'pune' AND age <= 27;ने फक्त siya. zoya सुद्धा Pune ची आहे, पण तिची ageNULLआहे, म्हणून तिच्यासाठीage <= 27खरं नाही.SELECT * FROM users WHERE city = 'nashik' OR age > 30;ने amit आणि ravi (Nashik), आणि kiran व arjun (30 पेक्षा जास्त).-
Mumbai किंवा Pune चे users:
SELECT * FROM users WHERE city = 'mumbai' OR city = 'pune'; -
ORनंतर column चं नाव परत लिहा.WHERE city = 'mumbai' OR 'pune'स्वीकारलं जातं, पण नुसतं'pune'ही condition नाही: MariaDB फक्त Mumbai च्या rows देतो (warnings सह). WHERE city = 'mumbai' AND city = 'pune'empty set देतो. एका row ची एकच city असते, ती दोन्ही कधीच असू शकत नाही.
Classroom line
Many people go wrong here and write city='mumbai' or 'pune'.
Class मधलं वाक्य
"Bharpur lok ithe chuktat, city='mumbai' or 'pune' lihitat."
भरपूर लोक इथे चुकतात, city='mumbai' or 'pune' लिहितात.
Classroom line
Many people go wrong here and write city='mumbai' or 'pune'.
7. IN: एक column, values ची list
का: OR ने तीन cities म्हणजे city = तीनदा type करणं. IN तेच एका छोट्या list मध्ये सांगतो.
कसं:
SELECT * FROM users WHERE city IN ('mumbai', 'pune', 'solapur');त्या तीन cities चे users देतो.- Numbers सुद्धा असेच, quotes शिवाय:
WHERE age IN (20, 25, 27)ने siya, maya, amit आणि neha. NOT INउलटं:WHERE city NOT IN ('mumbai', 'pune')ने बाकी सगळे.
Classroom line
When it's one column with a condition on several values, we use IN.
Class मधलं वाक्य
Column एकच आहे आणि वेगवेगळ्या values वर condition आहे, तर IN वापरायचं.
Classroom line – हिंदी
"Column ek hi hai aur alag alag values pe condition hai, to IN use karenge."
8. BETWEEN: range
का: Ranges सगळीकडे असतात: वय 18 ते 25, किंमत 500 ते 1000, या महिन्याच्या orders. BETWEEN ते एका छोट्या condition मध्ये सांगतो.
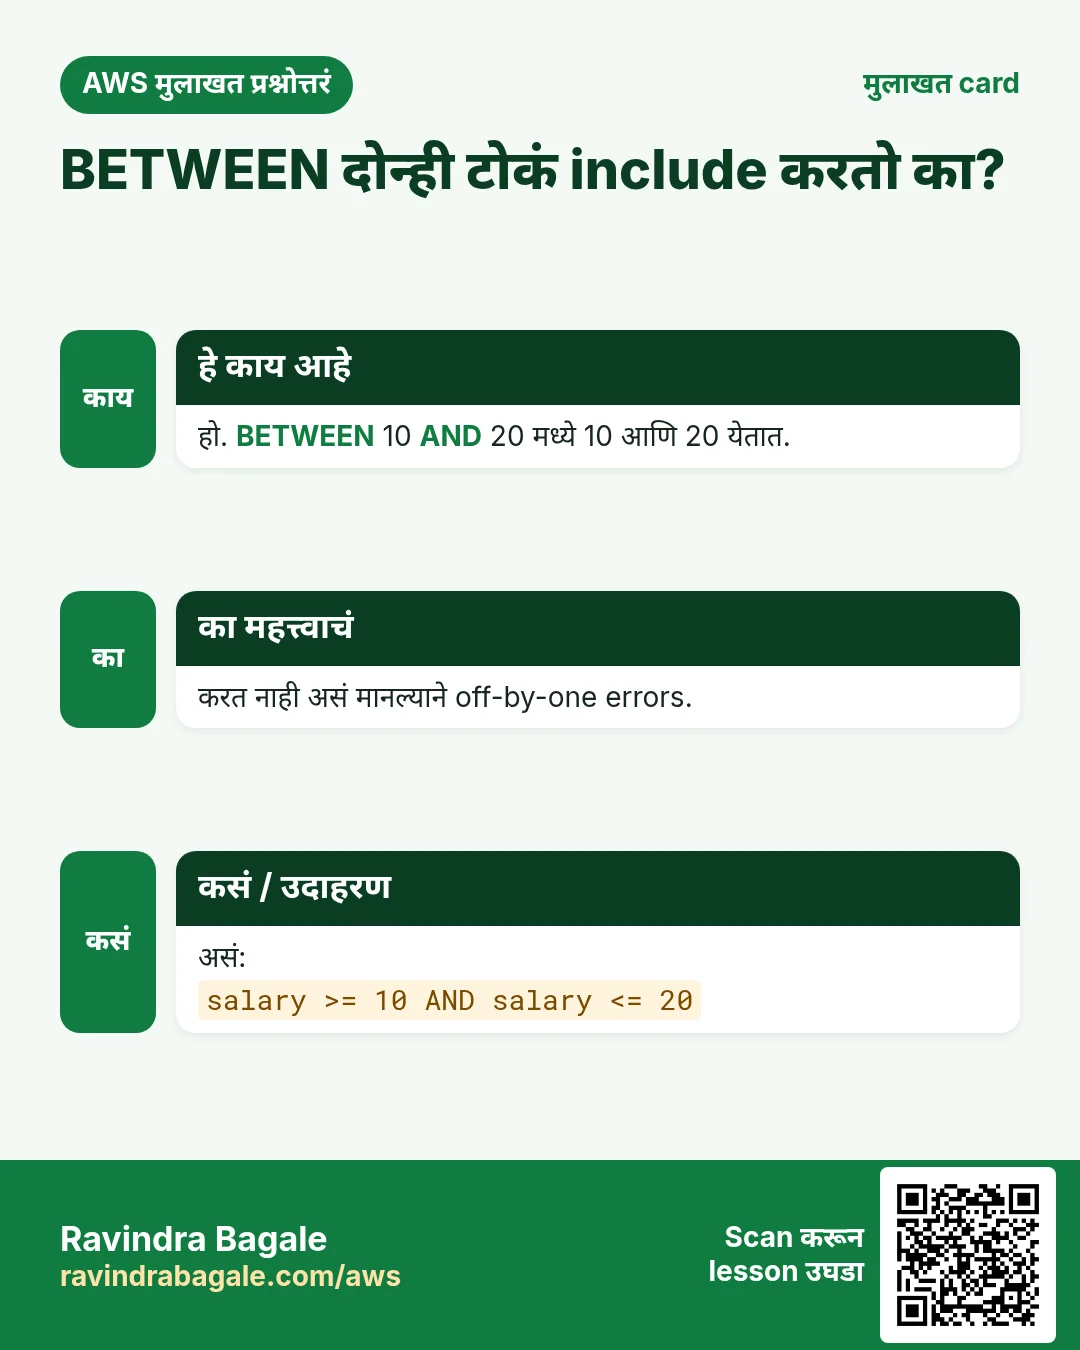
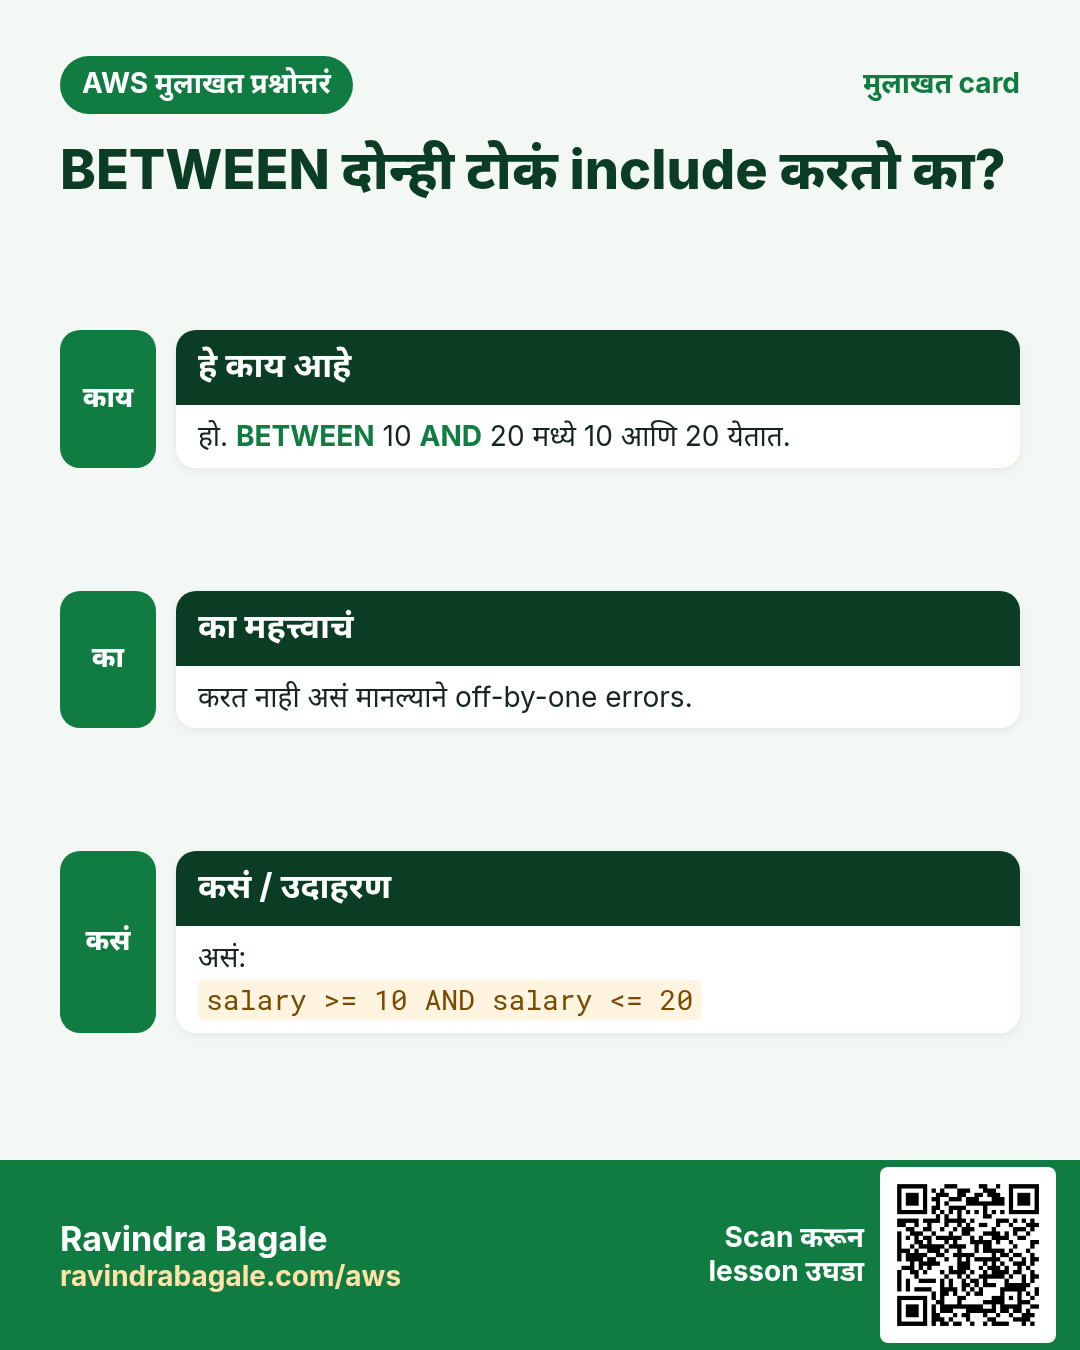
काय: BETWEEN a AND b a पासून b पर्यंतच्या values ठेवतो, दोन्ही टोकं धरून.
Classroom line
If it's a range, use BETWEEN.
Class मधलं वाक्य
Range असेल तर BETWEEN वापरायचं.
Classroom line – हिंदी
"Agar range hai to BETWEEN use karna hai."
कसं:
SELECT * FROM users WHERE age BETWEEN 20 AND 27;ने siya (27), maya (25), amit (20), neha (25) आणि priya (22). 20 आणि 27 दोन्ही धरले जातात.- हे
WHERE age >= 20 AND age <= 27सारखंच, फक्त छोटं. - नेहमी लहान value आधी लिहा.
BETWEEN 27 AND 20काहीच देत नाही. BETWEENtext वर सुद्धा चालतो, alphabetical क्रमाने:WHERE name BETWEEN 'neha' AND 'siya'ने neha, priya, दोन्ही ravi आणि siya.
Figure 4. AND (दोन्ही खरं), OR (किमान एक), IN (एका column साठी list) आणि BETWEEN (दोन्ही टोकं धरून range), प्रत्येकाच्या rows सह, आणि टाळायची OR ची चूक.
9. NULL: IS NULL आणि IS NOT NULL
काय: NULL म्हणजे "value च नाही". तो 0 नाही आणि 'NULL' text सुद्धा नाही. Value च नसल्यामुळे त्याची = ने तुलना कधीच खरी होत नाही.
कसं:
SELECT * FROM users WHERE age = NULL;Empty setदेतो, zoya ची age नसली तरी.SELECT * FROM users WHERE age = 'NULL';सुद्धाEmpty setदेतो; तोNULLया text शी तुलना करतो.-
बरोबर मार्ग
IS NULL:SELECT * FROM users WHERE age IS NULL; -
तो zoya देतो.
SELECT * FROM users WHERE age IS NOT NULL;उरलेले 9 users देतो.
10. LIKE: text मध्ये शोधा
का: Search box ला ("r ने सुरू होणारी नावं", "phone असलेली products") exact values नाही, patterns लागतात.
काय: LIKE text ची pattern शी तुलना करतो, आणि pattern मध्ये दोन wildcards असू शकतात:
%म्हणजे कितीही characters, शून्य सुद्धा._म्हणजे नेमका एक character.
Classroom line
If you want to build a search feature, you'll need LIKE.
Class मधलं वाक्य
"Searching functionality karaychi asel tar LIKE vaprava lagel."
Searching functionality करायची असेल तर LIKE वापरावा लागेल.
Classroom line
If you want to build a search feature, you'll need LIKE.
कसं:
SELECT name FROM users WHERE name LIKE 'r%';r ने सुरू होणारी नावं देतो: ravi, ravi.WHERE name LIKE '%ya'ya ने संपणारी नावं: zoya, siya, maya, priya.WHERE name LIKE '%ir%'ज्यात ir आहे अशी नावं: kiran.WHERE name LIKE '____'(चार underscores) नेमक्या 4 characters ची नावं: ravi, zoya, siya, maya, amit, neha, ravi.WHERE name LIKE '_____'(पाच underscores) ने kiran, priya, arjun.'s%a'म्हणजे s ने सुरू आणि a ने संपणारं: siya.%किंवा_नसेल तरLIKE 'ravi'हे= 'ravi'सारखंच वागतं.- MariaDB च्या default settings मध्ये
LIKE 'R%'ने सुद्धा ravi सापडतो: तुलना capital-small फरक बघत नाही.
Classroom line
As many characters as you need, that many underscores.
Class मधलं वाक्य
जितके characters पाहिजेत, तितके underscores.
Classroom line – हिंदी
"Jitne character chahiye, utne underscore."
Figure 5. = NULL कधीच जुळत नाही, IS NULL जुळतो; % (कितीही characters) आणि _ (नेमका एक character) सह LIKE patterns, आणि प्रत्येक pattern ला जुळणारी नावं.
11. LIMIT आणि OFFSET
का: Table मध्ये लाखो rows असू शकतात. काही rows मध्ये डोकावायचं, "top 3" दाखवायचे, किंवा results page by page दाखवायचे असतात.
काय:
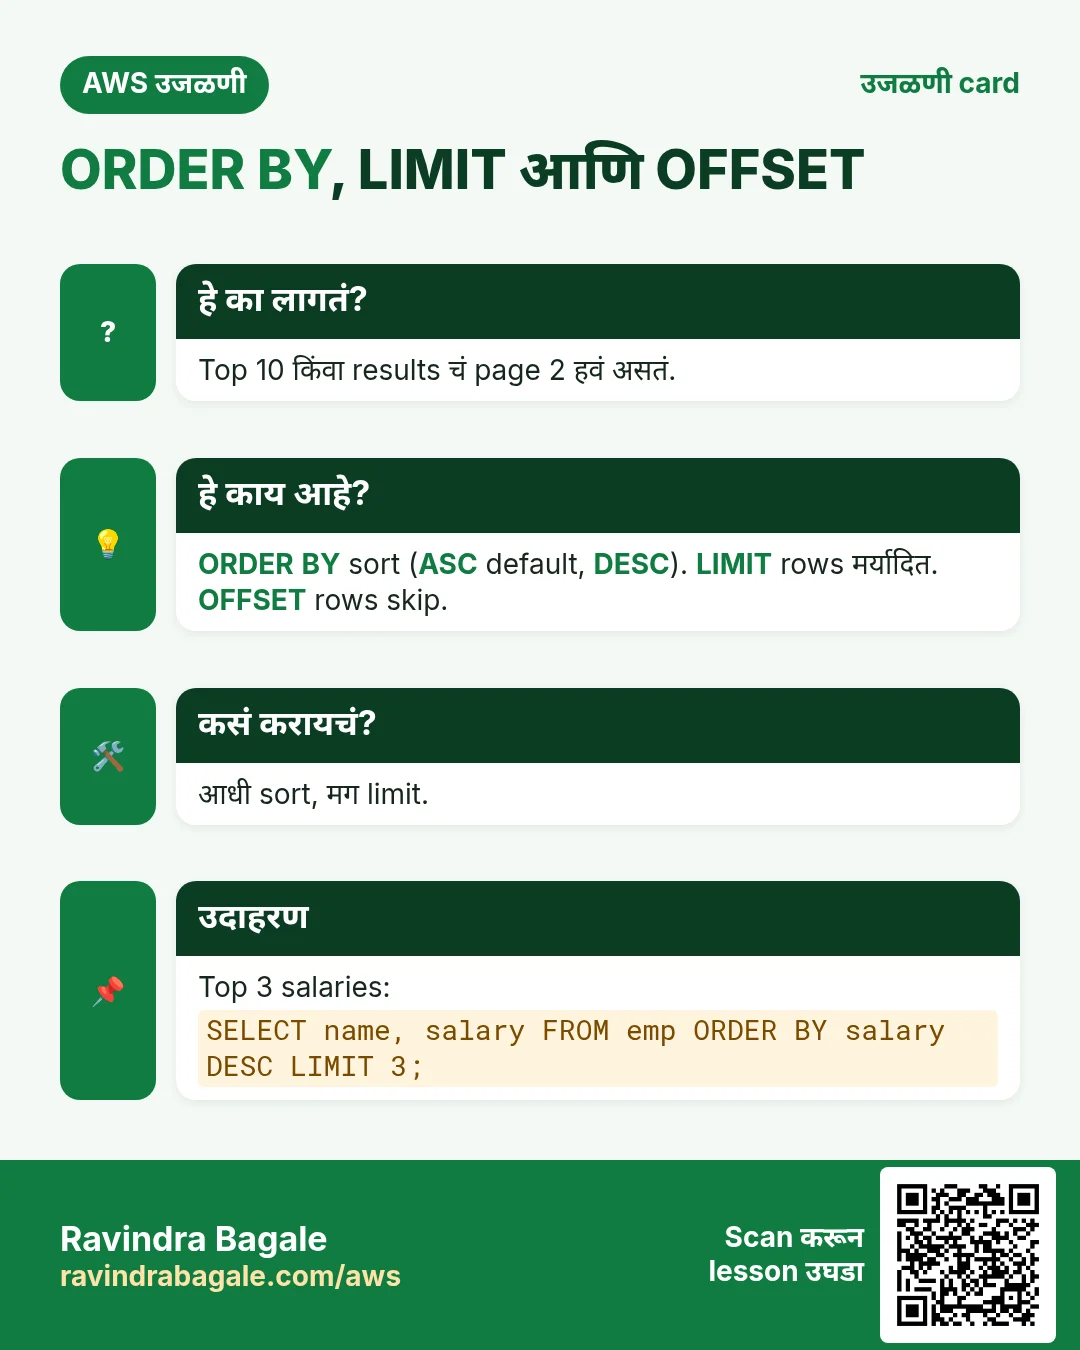
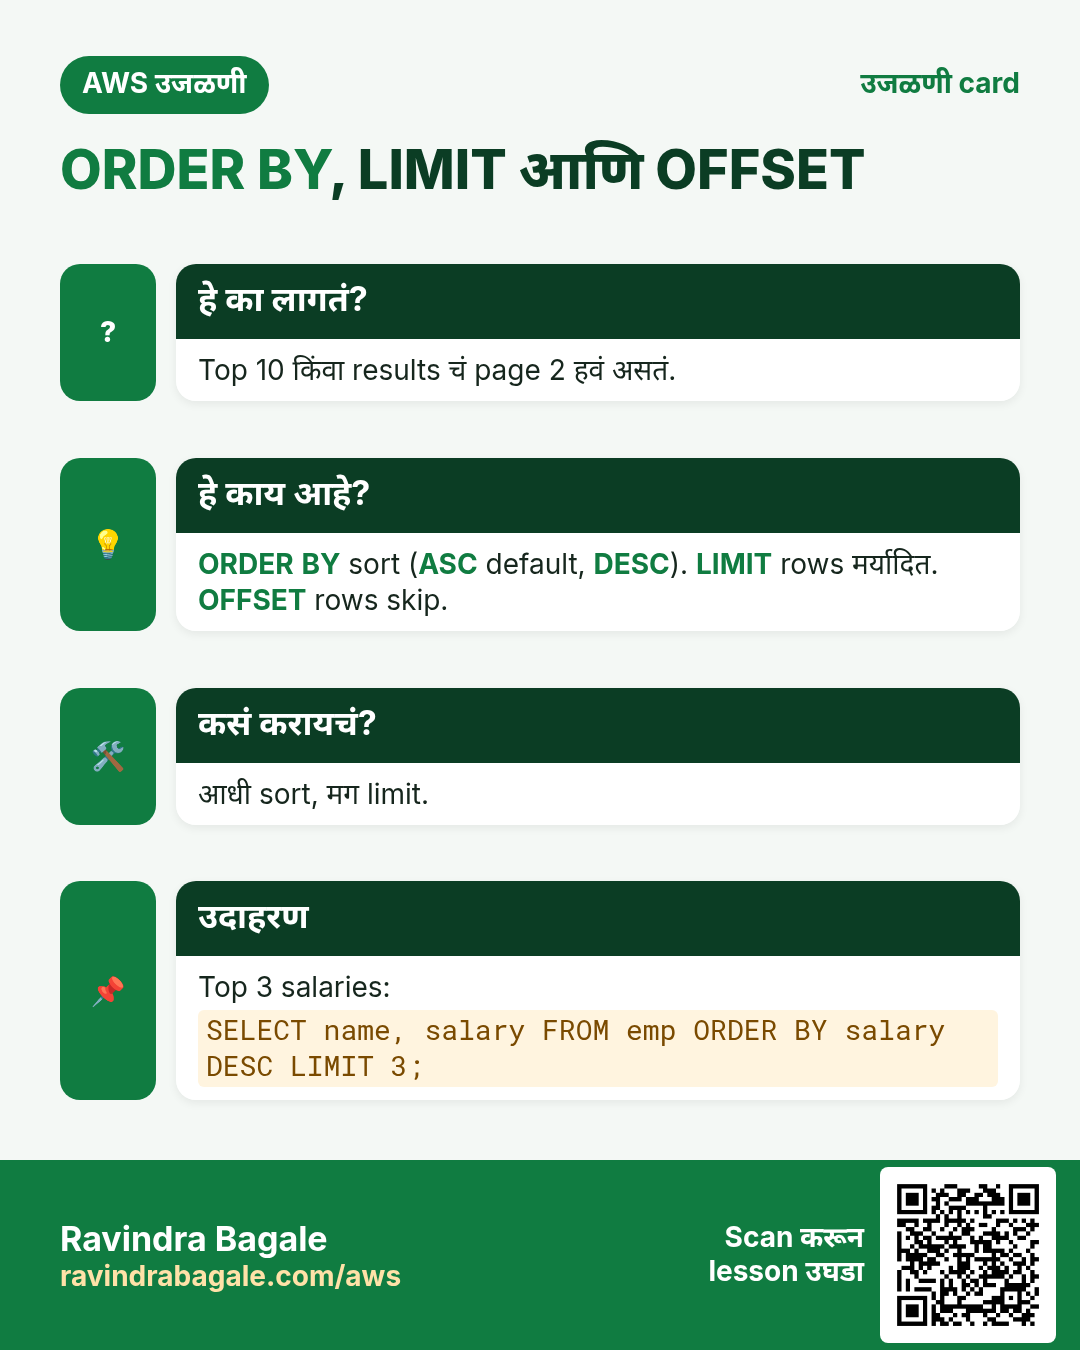
LIMIT nजास्तीत जास्तnrows देतो.OFFSET mआधीmrows सोडतो. तो दिला नाही तर offset 0.
Classroom line
OFFSET means skip that many and show the rest.
Class मधलं वाक्य
"Offset mhanje tevde sodun, bakiche dakhav."
Offset म्हणजे तेवढे सोडून, बाकीचे दाखव.
Classroom line
OFFSET means skip that many and show the rest.
कसं:
SELECT * FROM users LIMIT 2;पहिल्या 2 rows देतो.SELECT * FROM users LIMIT 3 OFFSET 2;2 rows सोडून पुढच्या 3 देतो (ids 3, 4 आणि 5).- एका page वर 3 असलेल्या list चं page 1 म्हणजे
LIMIT 3 OFFSET 0, page 2LIMIT 3 OFFSET 3, page 3LIMIT 3 OFFSET 6. -
"Top N" साठी आधी sort करा. सगळ्यात मोठे तीन users:
SELECT name, age FROM users ORDER BY age DESC LIMIT 3; -
ORDER BYशिवाय "पहिल्या 3 rows" ला guaranteed अर्थ नसतो; क्रम महत्त्वाचा असेल तेव्हा नेहमी sort करा.
Figure 6. Animation: LIMIT 2 पहिल्या दोन rows दाखवतो; LIMIT 3 OFFSET 2 दोन सोडून पुढच्या तीन दाखवतो; ORDER BY age DESC LIMIT 3 सगळ्यात मोठे तीन users देतो.
12. पगारासाठी table: emp, आणि पैशासाठी DECIMAL
का: Calculations practise करायला बेरीज करण्यासारखे numbers लागतात. Departments आणि salaries असलेला employee table हे classic उदाहरण.
काय: पैशासाठी DECIMAL(10,2) वापरा: एकूण 10 अंकांपर्यंत, त्यातले 2 दशांश चिन्हानंतर. DECIMAL नेमकी value साठवतो. FLOAT अंदाजे value साठवतो, त्यामुळे 0.10 सारख्या रकमा थोड्या round होऊ शकतात; वजनासाठी ते चालतं, पैशासाठी नाही.
कसं:
-
Table बनवा:
CREATE TABLE emp (id INT, name VARCHAR(20), dept VARCHAR(20), salary DECIMAL(10,2)); -
पाच employees टाका:
INSERT INTO emp VALUES (1, 'ravi', 'IT', 100000), (2, 'neha', 'Account', 250000), (3, 'govinda', 'IT', 270000), (4, 'pooja', 'HR', 10000), (6, 'ram', 'HR', 25000); -
SELECT * FROM emp;salaries दोन decimals सह दाखवतो, उदा.100000.00.
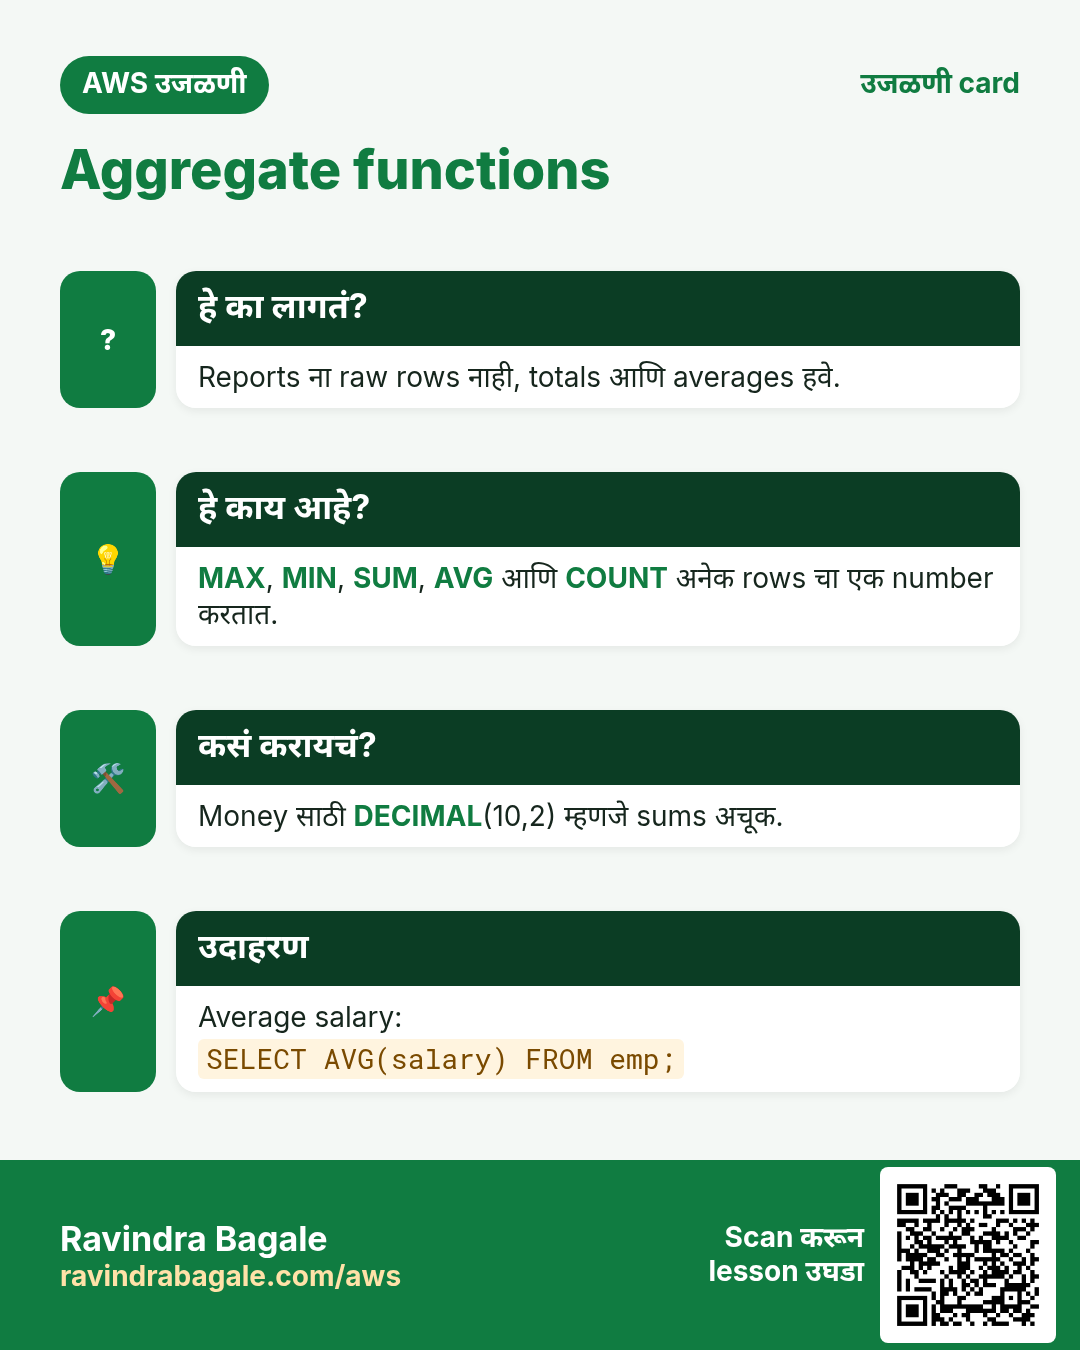
13. Aggregate functions: MAX, MIN, SUM, AVG आणि COUNT
का: "सगळ्यात जास्त salary किती?", "आपण एकूण किती पगार देतो?" या प्रश्नांना अनेक rows मधून काढलेलं एक उत्तर लागतं.
Classroom line
Which is the highest salary of all?
Class मधलं वाक्य
"Saglyat highest salary konti ahe?"
सगळ्यात highest salary कोणती आहे?
Classroom line
Which is the highest salary of all?
कसं:
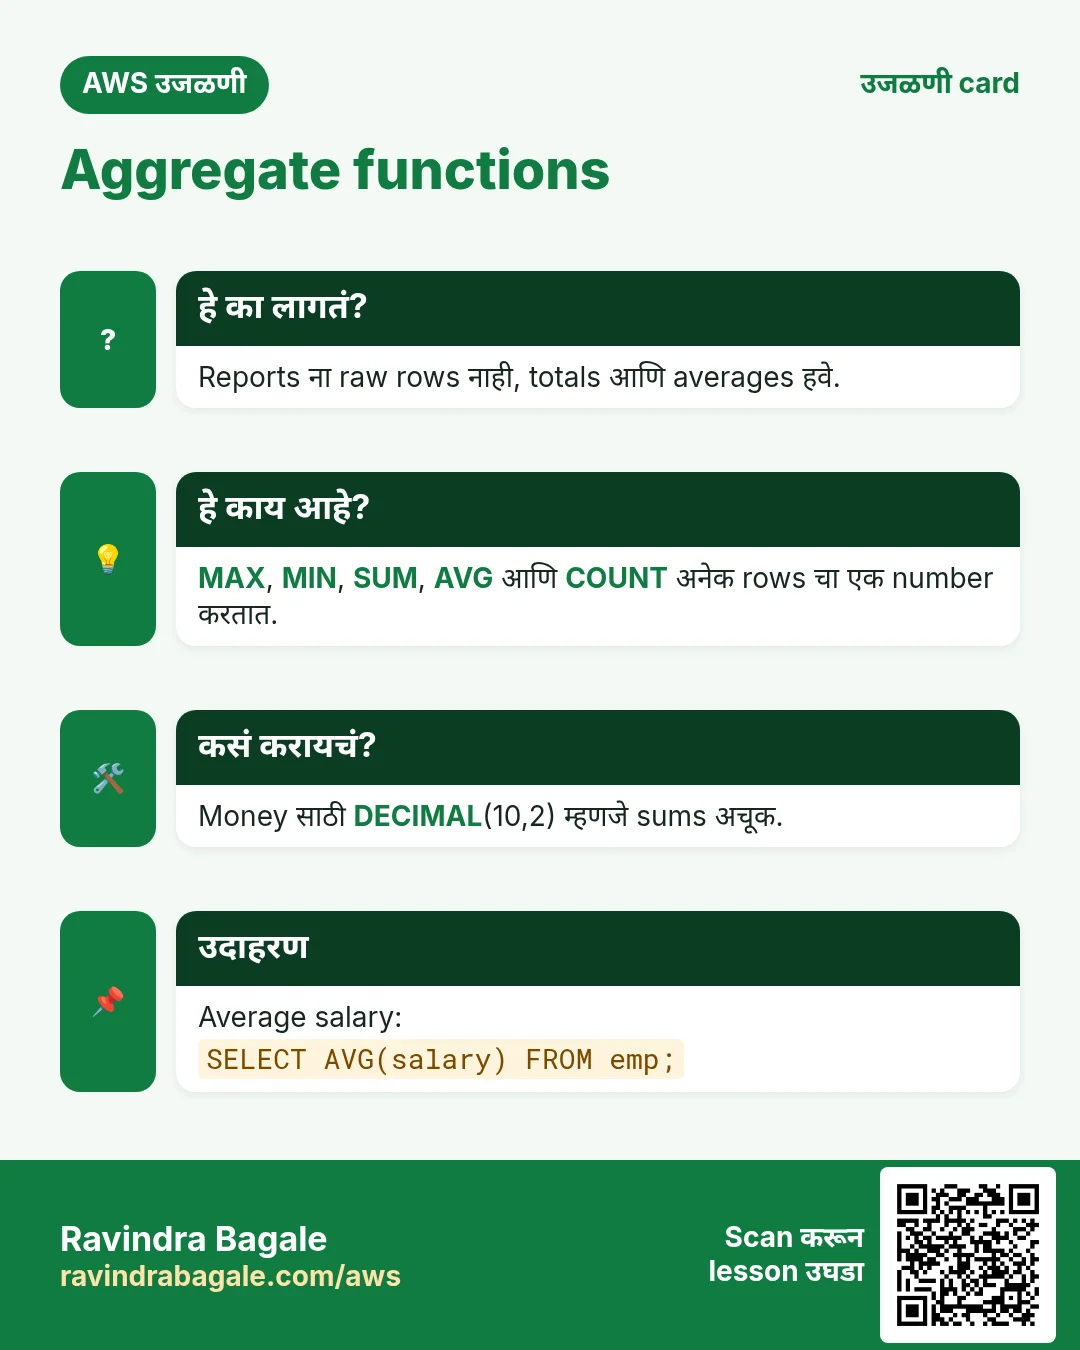
SELECT MAX(salary) FROM emp;सगळ्यात जास्त देतो: 270000.00.SELECT MIN(salary) FROM emp;सगळ्यात कमी देतो: 10000.00.SELECT SUM(salary) FROM emp;एकूण देतो: 655000.00.SELECT AVG(salary) FROM emp;सरासरी देतो: 131000 (सहा decimals सह छापतो).SELECT ROUND(AVG(salary), 2) FROM emp;ते 131000.00 असं round करतो.SELECT COUNT(salary) FROM emp;salaries मोजतो: 5.- Aliases सह एकदम अनेक:
SELECT MAX(salary) AS highest, MIN(salary) AS lowest FROM emp;
खालच्या screenshots मधले numbers तेच आहेत; किती decimals दिसतात ते फक्त column च्या type वर अवलंबून असतं.
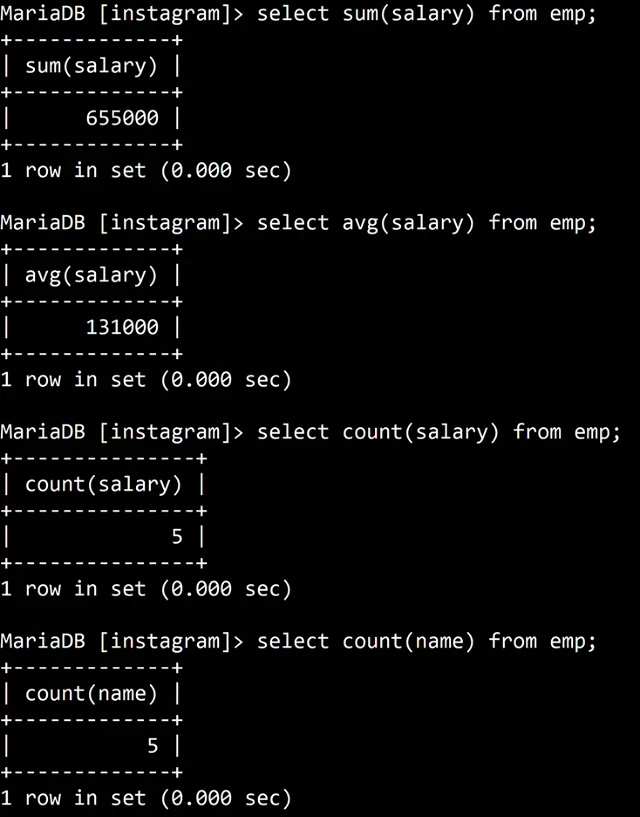
Whiteboard: emp table वर SUM, AVG, COUNT(salary) आणि COUNT(name): 655000, 131000, 5 आणि 5.
13.1 COUNT(*) विरुद्ध COUNT(column)
-
फक्त id आणि salary असलेला employee टाका:
INSERT INTO emp (id, salary) VALUES (7, 10000); -
या row साठी
nameआणिdeptNULLआहेत. SELECT COUNT(*) FROM emp;6 देतो:COUNT(*)rows मोजतो.SELECT COUNT(name) FROM emp;5 देतो:COUNT(column)फक्तNULLनसलेल्या values मोजतो.SELECT COUNT(id) FROM emp;6 देतो, कारण प्रत्येक row ला id आहे.- म्हणून "आपल्याकडे किती employees आहेत?" म्हणजे
COUNT(*). हा interview मधला अगदी नेहमीचा प्रश्न आहे.
Classroom line
The COUNT function doesn't count NULL.
Class मधलं वाक्य
Count function NULL ला count करत नाही.
Classroom line – हिंदी
"Count function NULL ko count nahi karta."
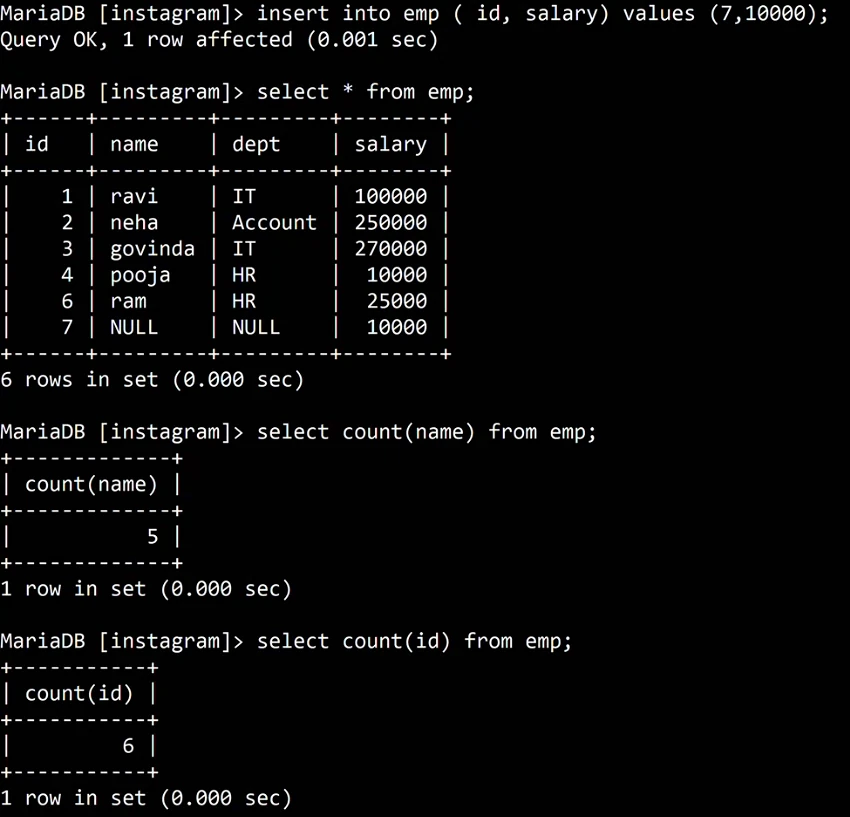
Whiteboard: फक्त id आणि salary सह row 7 टाकल्यानंतर: name आणि dept NULL, COUNT(name) 5 आणि COUNT(id) 6.
Figure 7. emp table वर MAX, MIN, SUM, AVG आणि COUNT, आणि row 7 टाकल्यानंतर: COUNT(*) प्रत्येक row मोजतो (6), COUNT(name) NULL name सोडतो (5).
14. Subquery: query मध्ये query
का: MAX(salary) सगळ्यात जास्त salary सांगतो, पण ती कोण कमावतो ते नाही. त्यासाठी पहिल्या query चं उत्तर वापरणारी दुसरी query लागते.
काय: Subquery म्हणजे brackets मधला SELECT, दुसऱ्या query च्या आत. आतली query आधी चालते, आणि बाहेरची query तिचा result वापरते.
Classroom line
We call this a query in a query.
Class मधलं वाक्य
"Hyala aapan query in query mhanto."
ह्याला आपण query in query म्हणतो.
Classroom line
We call this a query in a query.
कसं:
-
सगळ्यात जास्त कोण कमावतो?
SELECT name, salary FROM emp WHERE salary = (SELECT MAX(salary) FROM emp); -
आतली query 270000.00 देते, म्हणून बाहेरची query
WHERE salary = 270000.00होते आणि govinda देते. - आत आणि बाहेर एकच table चं नाव वापरा: salaries
empमध्ये आहेत, म्हणून दोन्ही भागFROM empम्हणतात. - सगळ्यात कमी कोण कमावतो?
MAXऐवजीMINलिहा: तुम्हाला दोन rows मिळतात, pooja आणिNULLname ची row, कारण दोघांचा पगार 10000.00. Subquery जुळणाऱ्या सगळ्या rows देते. -
Second-highest salary, interview चा आवडता प्रश्न:
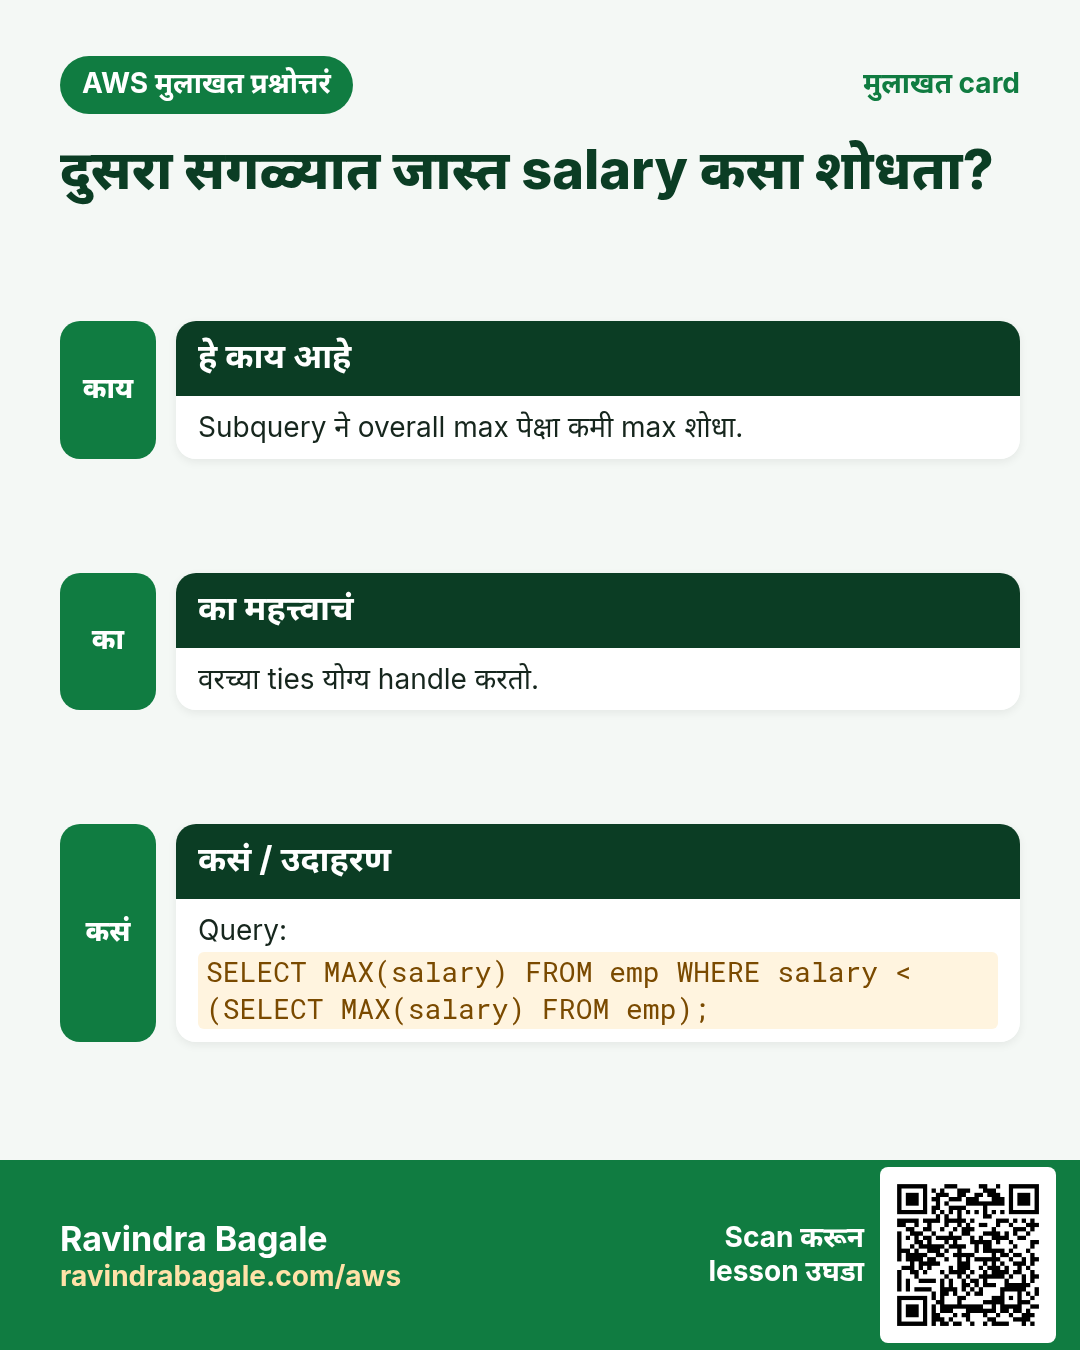
SELECT MAX(salary) FROM emp WHERE salary < (SELECT MAX(salary) FROM emp); -
आतली query 270000.00 शोधते; बाहेरची त्याच्या खालची सगळ्यात जास्त salary शोधते: 250000.00 (neha).
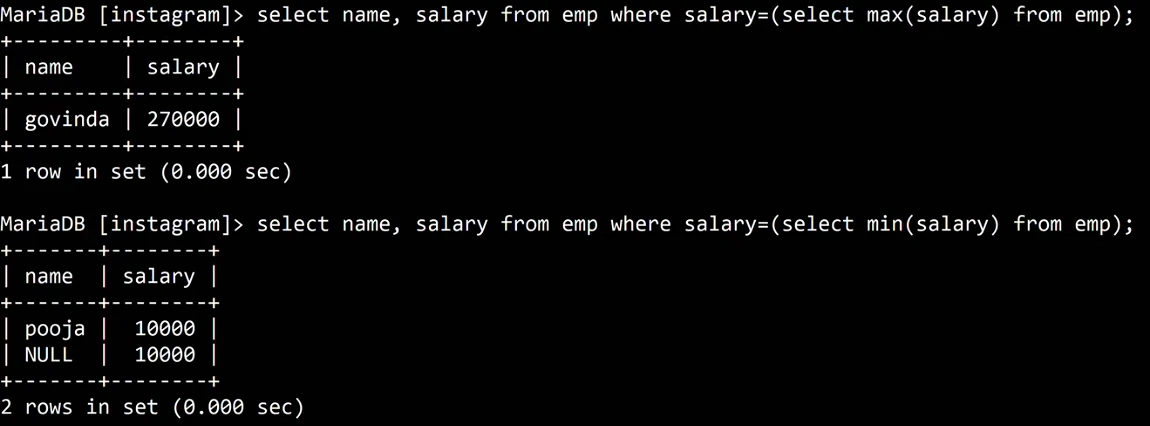
Whiteboard: emp वर subqueries: सगळ्यात जास्त salary govinda ची 270000; सगळ्यात कमी, 10000, दोन rows ना जुळते, pooja आणि NULL name ची row.
Figure 8. आतली query आधी चालते आणि 270000.00 देते; बाहेरची query ते वापरून govinda देते. MIN दोन tie rows देतो. Second-highest salary म्हणजे MAX च्या खालचा MAX: 250000.00.
15. GROUP BY: प्रत्येक group चं एक उत्तर
का: SUM(salary) पूर्ण company चा एक total देतो. "प्रत्येक department चा एकूण पगार" म्हणजे प्रत्येक department साठी एक total.
काय: GROUP BY dept सारख्या dept च्या rows एकत्र करतो, आणि aggregate function प्रत्येक group साठी एकदा चालतं.
Classroom line
Whenever you need a group-wise answer, use GROUP BY.
Class मधलं वाक्य
"Jya veli group-wise answer pahije, tevha group by vaprayacha."
ज्या वेळी group-wise answer पाहिजे, तेव्हा group by वापरायचा.
Classroom line
Whenever you need a group-wise answer, use GROUP BY.
कसं:
SELECT SUM(salary) FROM emp GROUP BY dept;चार totals देतो, पण कोणता कुणाचा ते कळत नाही.-
Group चा column
SELECTमध्ये जोडा:SELECT dept, SUM(salary) FROM emp GROUP BY dept; -
Result:
NULL10000.00,Account250000.00,HR35000.00,IT370000.00. - Department नसलेल्या rows चा स्वतःचा
NULLgroup बनतो. - इतर functions सुद्धा प्रत्येक group वर चालतात:
SELECT dept, COUNT(*) AS people, AVG(salary) FROM emp GROUP BY dept; SELECTमध्ये फक्त group केलेला column आणि aggregate functions ठेवा.nameसारख्या column च्या एका group मध्ये अनेक values असतात, म्हणून त्याचं एक उत्तर नसतं.
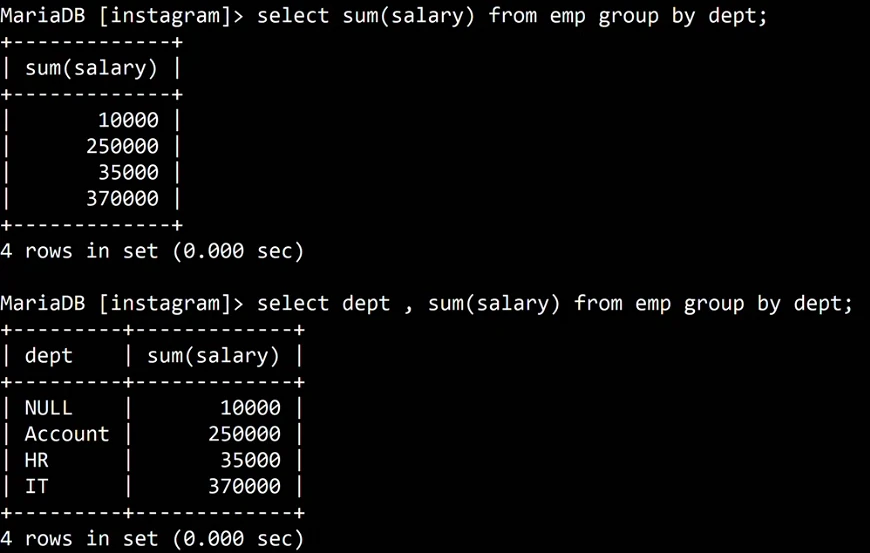
Whiteboard: dept प्रमाणे group केलेला SUM(salary), आधी dept column शिवाय आणि मग त्यासह.
16. HAVING: groups filter करा
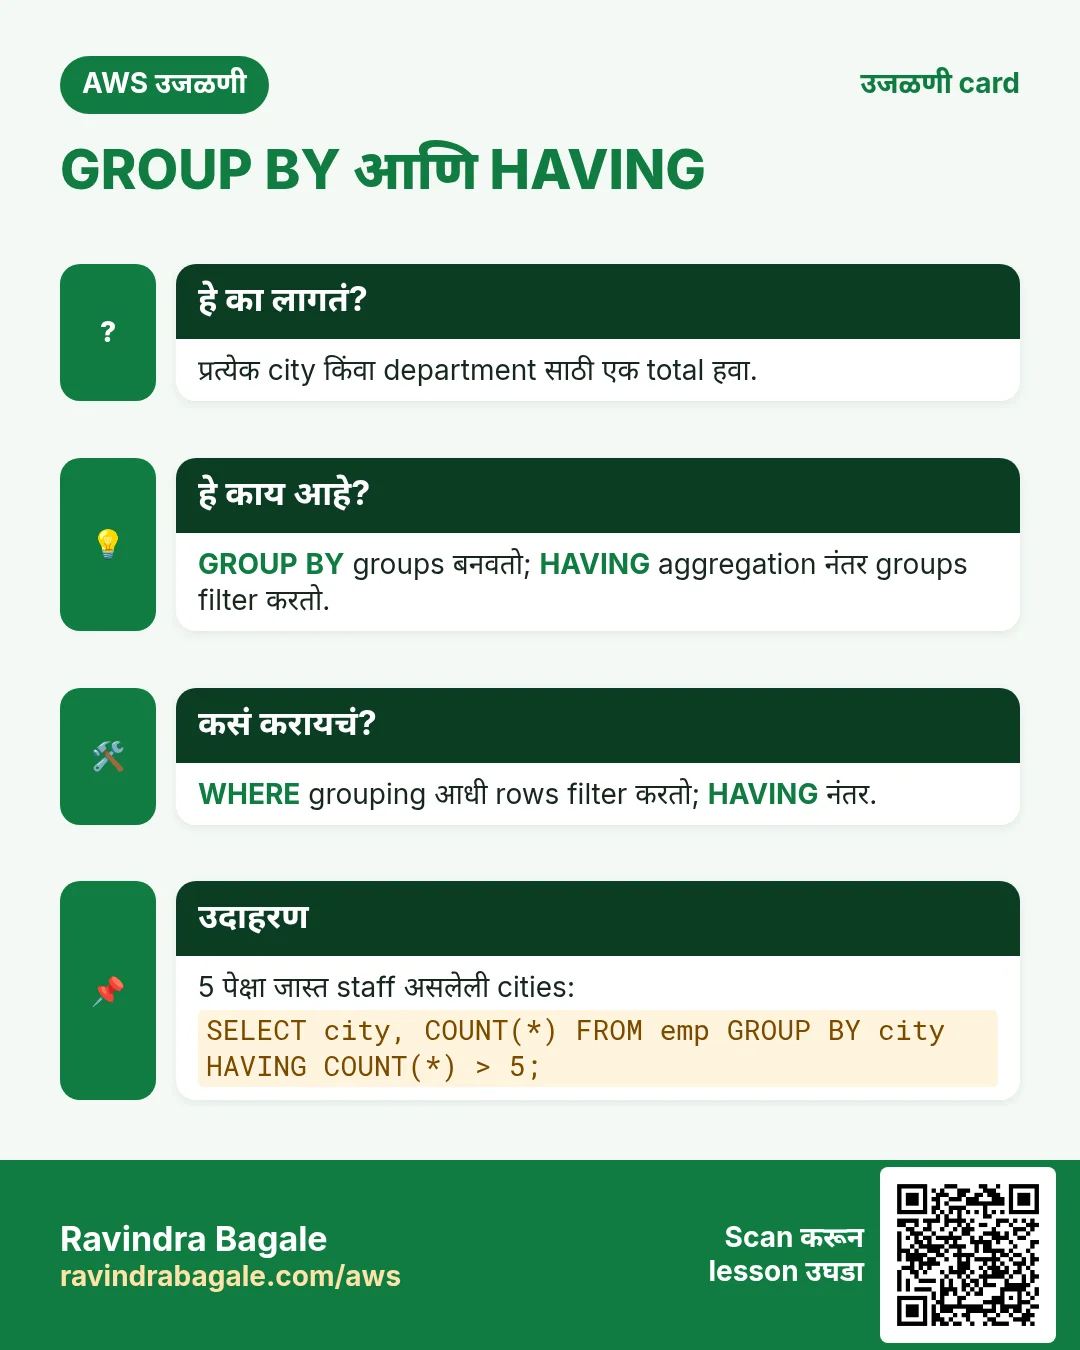
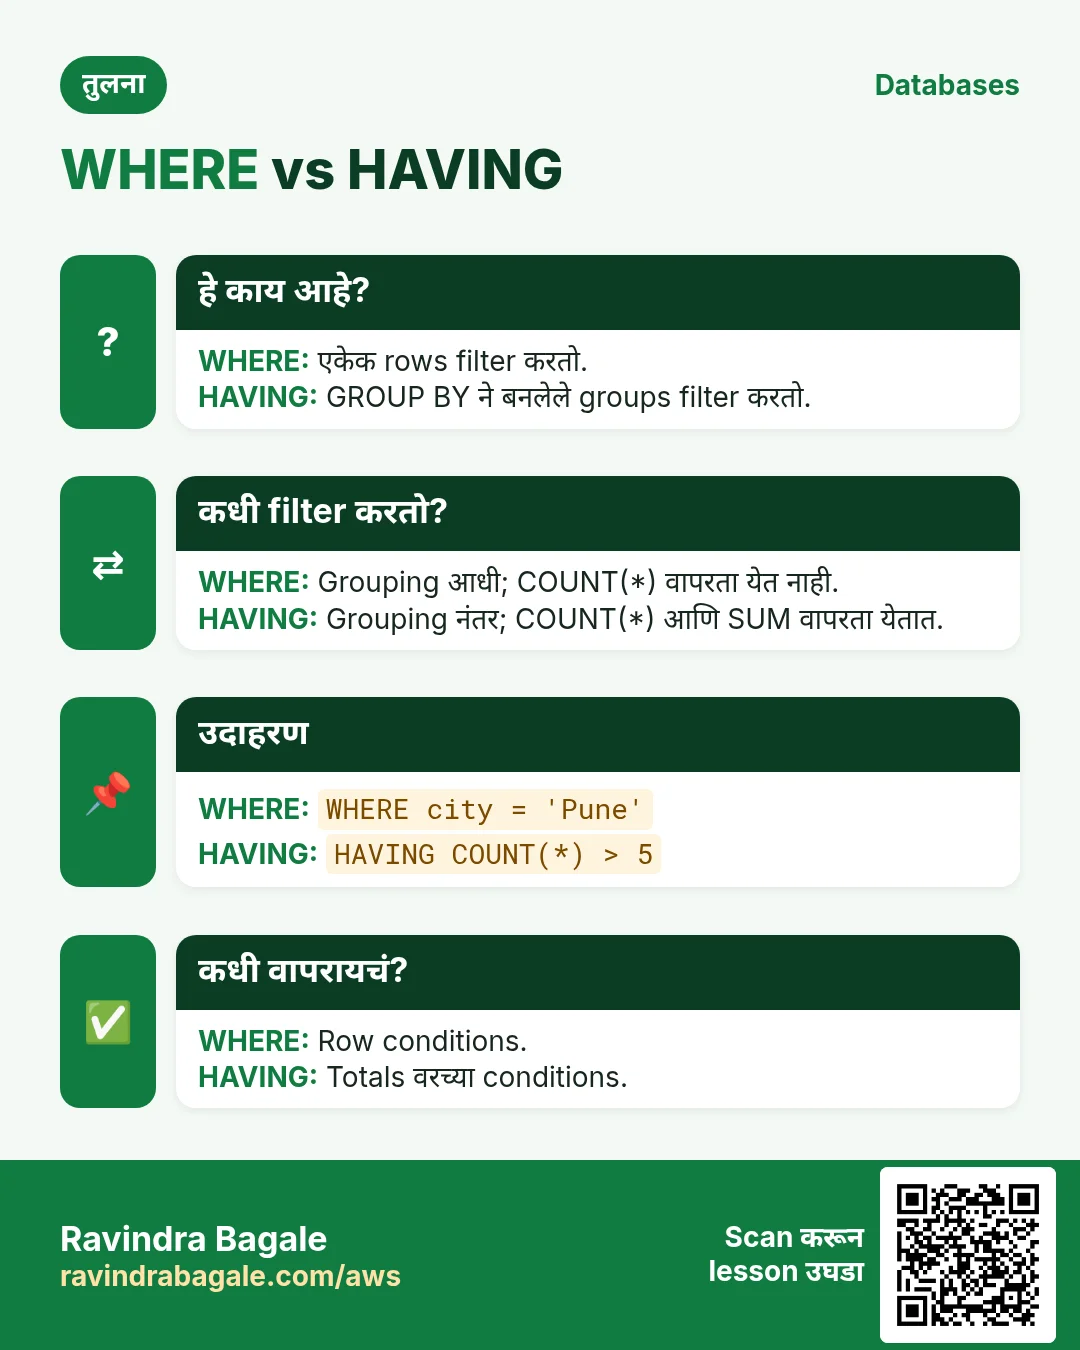
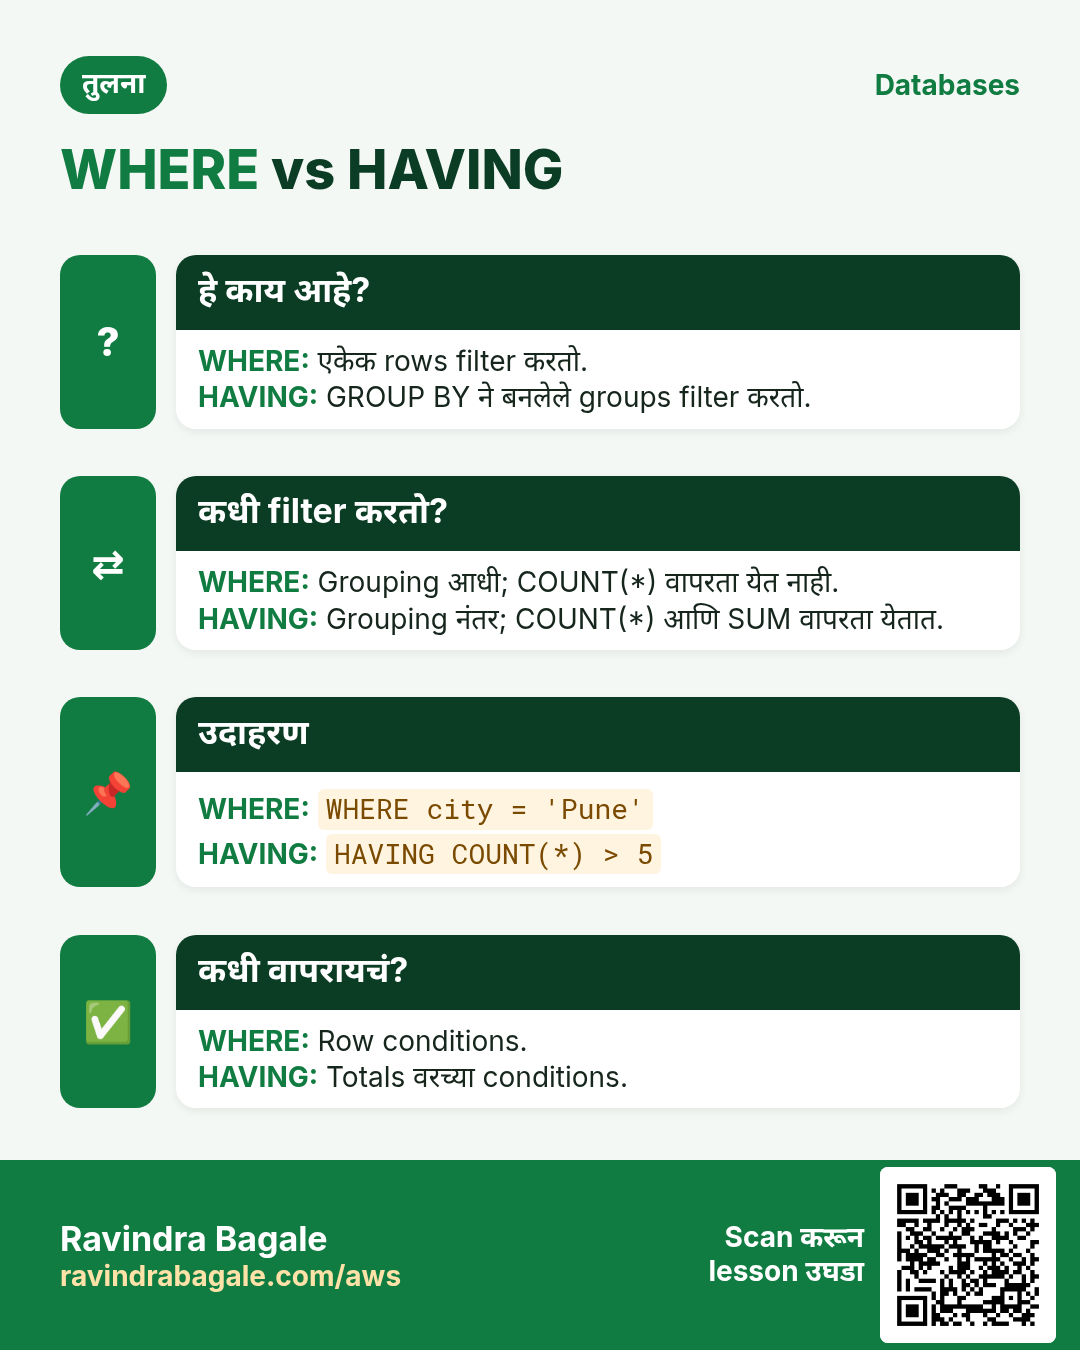
का: "एकापेक्षा जास्त users असलेली शहरं" ही groups वरची condition, rows वरची नाही. WHERE grouping आधी चालतो म्हणून हे करू शकत नाही; HAVING करू शकतो.
काय: HAVING ही GROUP BY नंतर groups वरची condition. WHERE ही grouping च्या आधी rows वरची condition.
Classroom line
If the condition is on groups, we don't use WHERE; we use HAVING.
Class मधलं वाक्य
Groups वर condition असेल तर where नाही, having वापरायचं.
Classroom line – हिंदी
"Groups pe condition ho toh where nahi, having use karenge."
कसं:
-
ज्यांचा एकूण पगार 100000 पेक्षा जास्त आहे असे departments:
SELECT dept, SUM(salary) FROM emp GROUP BY dept HAVING SUM(salary) > 100000; -
Result: Account 250000.00 आणि IT 370000.00.
SELECT * FROM emp WHERE SUM(salary) > 100000;ERROR 1111 ... Invalid use of group functionदेतो:WHEREएका वेळी एकच row बघतो, totals बनण्याआधीच.-
दोन्ही वापरता येतात:
WHEREआधी rows काढतो, मगHAVINGgroups काढतो:SELECT dept, SUM(salary) AS total FROM emp WHERE dept IS NOT NULL GROUP BY dept HAVING total > 100000 ORDER BY total DESC; -
ते आधी IT (370000.00) आणि मग Account (250000.00) देतं.
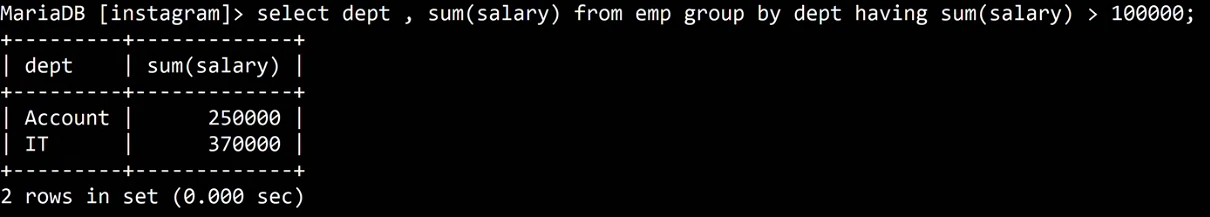
Whiteboard: HAVING SUM(salary) > 100000 सह GROUP BY dept फक्त Account आणि IT ठेवतो.
Figure 9. Animation: department प्रमाणे रंगवलेल्या emp च्या सहा rows, प्रत्येक department चा एक total बनवणारा GROUP BY dept (NULL group सह), आणि 100000 पेक्षा जास्त असलेले groups च ठेवणारा HAVING.
Ravindra Bagale's Tip
मोठा SELECT MariaDB ज्या क्रमाने चालवतो त्या क्रमाने वाचा: FROM (कोणता table), WHERE (कोणत्या rows), GROUP BY (कोणते groups), HAVING (कोणते groups टिकतात), SELECT (कोणते columns), ORDER BY (कोणत्या क्रमाने), LIMIT (किती). Query ने अनपेक्षित उत्तर दिलं, तर ती एक-एक clause करून परत चालवा, आधीचा result बरोबर दिसल्यावरच पुढचा clause जोडा.
17. UPDATE: असलेला data बदला
का: User city बदलतो, किंवा नाव चुकीचं type झालं. तुम्ही असलेल्या rows बदलता; delete करून परत insert करत नाही.
काय:
UPDATErows मधला data बदलतो. तो CRUD मधला U आहे.ALTER TABLEtable चं structure बदलतो: columns जोडतो, बदलतो किंवा काढतो. Rows जशा आहेत तशाच राहतात. उदा.ALTER TABLE users ADD phone VARCHAR(15);रिकामाphonecolumn जोडतो.ALTER TABLEपुढच्या SQL chapter मध्ये नीट बघू.
UPDATE चं रूप:
UPDATE table SET column = value WHERE condition;
कसं: दुसऱ्या ravi चं (id 10, Nashik चा) नाव ravindra करायचं आहे. Solapur चा ravi बदलता कामा नये.
Classroom line
I don't want to change the ravi from Solapur; only the ravi from Nashik should become ravindra.
Class मधलं वाक्य
"Mala Solapur walya ravila nahi badlaycha, fakt Nashik walya ravilach ravindra karaycha."
मला Solapur वाल्या रवीला नाही बदलायचं, फक्त Nashik वाल्या रवीलाच ravindra करायचं.
Classroom line
I don't want to change the ravi from Solapur; only the ravi from Nashik should become ravindra.
- आधी जी condition वापरणार आहात तिचा
SELECTचालवा:SELECT * FROM users WHERE name = 'ravi'; - तो दोन rows देतो.
UPDATE users SET name = 'ravindra' WHERE name = 'ravi';दोन्ही बदलेल. -
नेमकी एकच row निवडणारा column वापरा. इथे तो
id:UPDATE users SET name = 'ravindra' WHERE id = 10; -
MariaDB
Query OK, 1 row affectedआणिRows matched: 1 Changed: 1असं उत्तर देतो. - तपासा:
SELECT * FROM users WHERE name LIKE 'ravi%';ravi (Solapur) आणि ravindra (Nashik) दाखवतो. - Commas ने एकदम अनेक columns बदला:
UPDATE users SET age = 26, city = 'pune' WHERE id = 5; WHEREशिवायUPDATEtable मधली प्रत्येक row बदलतो. नेहमी आधीWHEREलिहा.- प्रत्येक वेळी "rows affected" चा number वाचा. तो अपेक्षेपेक्षा मोठा असेल, तर तुमची condition हव्यापेक्षा जास्त rows ना जुळली.
Figure 10. SELECT मधल्या clauses चा क्रम, आणि UPDATE (rows मधला data बदलतो) विरुद्ध ALTER TABLE (table चं structure बदलतो).
Practice झाल्यावर exit; type करा आणि EC2 instance stop करा.
18. पूर्ण class एका page वर
SELECT DISTINCT city FROM users;प्रत्येक value एकदा.SELECT city AS gaav ...heading बदलतो.ORDER BY colascending (default),ORDER BY col DESC, tie साठीORDER BY name, city.=,!=/<>,<,>,<=,>=सहWHERE; text quotes मध्ये, numbers शिवाय.ANDदोन्ही खरं,ORकिमान एक;ORनंतर column परत लिहा.IN (...)list;BETWEEN a AND bदोन्ही टोकं धरून range, text वर सुद्धा.IS NULL/IS NOT NULL;= NULLकधीच जुळत नाही.%(कितीही characters) आणि_(नेमका एक) सहLIKE.LIMIT n OFFSET m; top N साठी आधीORDER BYने sort.- पैसे
DECIMAL(10,2)मध्ये.MAX,MIN,SUM,AVG,COUNT(*)(rows) आणिCOUNT(col)(NULL नसलेल्या values). - Subquery:
WHERE salary = (SELECT MAX(salary) FROM emp); second highest:MAXच्या खालचाMAX. GROUP BY deptप्रत्येक group चं एक उत्तर;HAVINGgroups filter करतो,WHERErows.UPDATE t SET col = val WHERE ...;data बदलतो;ALTER TABLEstructure बदलतो.
19. Hands-on lab: practice table वर दहा queries
हा lab का. खालची प्रत्येक query app खरंच विचारतो अशा प्रश्नाचं उत्तर देते. Section 1 मधल्या दहा rows वापरा, म्हणजे तुमचे results तंतोतंत जुळतील.
- प्रत्येक शहर एकदा
- Command:
SELECT DISTINCT city FROM users; - काय दिसेल: 6 rows:
solapur,pune,mumbai,nashik,delhi,dubai. - Check करा:
6 rows in set, 10 नाही. - का: City dropdown ला प्रत्येक value एकदाच हवी.
DISTINCTफक्त result मधले repeats काढतो; table तसाच राहतो.
- Command:
- Pune चे users
- Command:
SELECT name, age FROM users WHERE city = 'pune'; - काय दिसेल:
zoya | NULLआणिsiya | 27. - Check करा:
2 rows in set. - का:
WHEREफक्त जुळणाऱ्या rows ठेवतो. Text values ना quotes लागतात.
- Command:
- एकदम दोन शहरं
- Command:
SELECT name FROM users WHERE city IN ('pune', 'mumbai'); - काय दिसेल:
zoya,siya,maya,neha. - Check करा:
4 rows in set. - का:
INम्हणजेcity = 'pune' OR city = 'mumbai'लिहायचा छोटा मार्ग.
- Command:
- वयाची range
- Command:
SELECT name, age FROM users WHERE age BETWEEN 25 AND 30; - काय दिसेल:
ravi 30,siya 27,maya 25,neha 25,ravi 28. - Check करा:
5 rows in set; 25 आणि 30 समाविष्ट. - का:
BETWEENदोन्ही टोकं समाविष्ट करतो. Zoya चंNULLवय कोणत्याच range मध्ये येत नाही.
- Command:
- नसलेल्या values
- Command:
SELECT name FROM users WHERE age IS NULL; - काय दिसेल:
zoya - Check करा:
WHERE age = NULLEmpty setदेतो. - का:
NULLम्हणजे value नाही, म्हणून=त्याच्याशी कधीच जुळत नाही. नेहमीIS NULLवापरा.
- Command:
- r ने सुरू होणारी नावं
- Command:
SELECT id, name FROM users WHERE name LIKE 'r%'; - काय दिसेल:
1 raviआणि10 ravi. - Check करा:
2 rows in set. - का:
%म्हणजे कितीही अक्षरं. Type करताना search box नावं अशीच शोधतो.
- Command:
- सगळ्यात मोठे तीन
- Command:
SELECT name, age FROM users ORDER BY age DESC LIMIT 3; - काय दिसेल:
kiranआणिarjun(37), मगravi(30). - Check करा:
3 rows in set. - का:
DESCमोठ्यापासून sort करतो;LIMIT 3पहिले तीन ठेवतो.ORDER BYशिवाय "पहिले तीन" ला अर्थ नाही.
- Command:
- Rows आणि values मोजा
- Command:
SELECT COUNT(*), COUNT(age), MAX(age), MIN(age) FROM users; - काय दिसेल:
10 | 9 | 37 | 20 - Check करा: Zoya च्या
NULLमुळेCOUNT(age)एकने कमी. - का:
COUNT(*)rows मोजतो;COUNT(column)NULLसोडतो. "किती users" साठीCOUNT(*)वापरा.
- Command:
- सगळ्यात मोठा कोण?
- Command:
SELECT name FROM users WHERE age = (SELECT MAX(age) FROM users); - काय दिसेल:
kiranआणिarjun. - Check करा:
2 rows in set. - का:
MAXvalue देतो, व्यक्ती नाही. आतली query 37 शोधते; बाहेरची ते कोणाचं ते शोधते.
- Command:
- एकापेक्षा जास्त users असलेली शहरं
- Command:
SELECT city, COUNT(*) AS total FROM users GROUP BY city HAVING COUNT(*) > 1; - काय दिसेल:
mumbai 2,nashik 2,pune 2,solapur 2. - Check करा:
delhiआणिdubai(प्रत्येकी 1) बाहेर. - का:
GROUP BYप्रत्येक शहरासाठी एक row बनवतो;HAVINGते groups filter करतो.WHEREकरू शकत नाही, कारण तो grouping आधी चालतो.
- Command:
- एक row बदला
- Command:
UPDATE users SET city = 'pune' WHERE id = 8; - काय दिसेल:
Query OK, 1 row affectedआणिRows matched: 1 Changed: 1 Warnings: 0. - Check करा:
SELECT name, city FROM users WHERE id = 8;→priya | pune. - का: आधी जुळणारा
SELECTचालवा आणि count तपासा.WHEREशिवाय प्रत्येक row बदलेल.
- Command:
20. Try at home
Try at home
Task 1: filters
- Section 1 मधला
userspractice data टाका. - प्रत्येक age एकदा, सगळ्यात मोठ्यापासून लहानापर्यंत sort करून दाखवा.
- Pune किंवा Solapur चे users दाखवा, आधी
ORने, मगINने. - 22 ते 28 वयाचे users
BETWEENने, मग>=आणि<=ने दाखवा. Results ची तुलना करा. - ज्यांची age माहीत नाही ते users शोधा.
- ज्यांच्या नावात
iआहे अशी नावं, आणि नेमक्या 5 अक्षरांची नावं शोधा.
Task 2: sorting आणि pages
- Age असलेले दोन सगळ्यात लहान users दाखवा.
- एका page वर 3 users: pages 1, 2 आणि 3 च्या queries लिहा.
Task 3: emp
salary DECIMAL(10,2)सहempबनवा आणि पाच employees टाका.- सगळ्यात जास्त, सगळ्यात कमी, एकूण आणि सरासरी salary शोधा, प्रत्येकाला alias देऊन.
- फक्त id आणि salary असलेला employee टाका, मग
COUNT(*)आणिCOUNT(name)ची तुलना करा. - सगळ्यात जास्त salary कोण कमावतो, आणि second-highest salary किती ते शोधा.
- प्रत्येक department चे employees आणि एकूण salary दाखवा, फक्त एकापेक्षा जास्त employees असलेल्या departments साठी.
Task 4: UPDATE
id = 10साठीSELECTचालवा, मगUPDATEने त्या user ची citypuneकरा.- "rows affected" ची line वाचा. मग
SELECTने तपासा.
Recap
थोडक्यात
DISTINCTresult मधल्या repeat rows काढतो;ASफक्त output मधल्या column ला नाव देतो.ORDER BYहाFROMआणिWHEREनंतरचा clause;ASCdefault,DESCउलटा; दुसरा column tie सोडवतो.WHERE=,!=किंवा<>,<,>,<=,>=ने rows filter करतो;ANDआणिORने जोडा.- List साठी
IN, range साठीBETWEEN(दोन्ही टोकं धरून), नसलेल्या values साठीIS NULL, patterns साठी%आणि_सहLIKE. LIMITआणिOFFSETrows चा तुकडा देतात; top N साठी आधी sort.- पैशासाठी
DECIMAL(10,2);MAX,MIN,SUM,AVGआणिCOUNTअनेक rows मधून एक उत्तर काढतात;COUNT(*)rows मोजतो,COUNT(col)NULLसोडतो. - Subquery आधी चालते आणि बाहेरच्या query ला उत्तर देते, उदा. सगळ्यात जास्त कोण कमावतो किंवा second-highest salary शोधायला.
GROUP BYप्रत्येक group चं एक उत्तर देतो;HAVINGgroups filter करतो,WHERErows.UPDATE ... SET ... WHEREdata बदलतो (आधीSELECTने तपासा;WHEREनसेल तर प्रत्येक row बदलते);ALTER TABLEstructure बदलतो.
सराव Tasks
Paris Fashion Hub हा पॅरिस मधला फॅशन व्यवसाय आहे. Camille Laurent त्यांचं IT व cloud काम पाहतात. त्यांचे पैसे EUR मध्ये मोजले जातात आणि AWS resources eu-west-3 Region मध्ये चालतात. खालच्या tasks मध्ये तुम्ही या lesson मध्ये शिकलेलं वापरून त्यांची खरी कामं करता. सगळी नावं, account IDs, IP addresses व numbers सरावासाठी काल्पनिक आहेत.
0 / 10
सोपं मोठ्या orders आधी
का: RDS setup नंतर database query करणं रोजचं काम.
काय करायचं: Order id व amount, मोठी amount आधी.
Tables: customers(id, name, city) व orders(id, customer_id, amount, odate).
- Task कोणत्या table बद्दल आहे ते पाहा (box वरची table list).
- SQL statement step by step लिहा: काय, कुठून, कोणते rows.
- Statement ; ने संपवा.
- Check answer दाबा. Query table च्या practice copy वर चालते.
सोपं City नुसार customers
का: RDS setup नंतर database query करणं रोजचं काम.
काय करायचं: Pune मधल्या customers ची नावं.
Tables: customers(id, name, city) व orders(id, customer_id, amount, odate).
- Task कोणत्या table बद्दल आहे ते पाहा (box वरची table list).
- SQL statement step by step लिहा: काय, कुठून, कोणते rows.
- Statement ; ने संपवा.
- Check answer दाबा. Query table च्या practice copy वर चालते.
सोपं MariaDB मध्ये login करा
का: mysql client ने database server वर SQL चालवता येतं.
काय करायचं: MariaDB client root user म्हणून उघडा व password विचारू द्या.
- हे काम करणारा Linux command शोधा.
- Task ला लागणारे options (उदा. -r, -h) जोडा.
- File नावं, folders किंवा users योग्य क्रमाने लिहा.
- System files/users बदलत असाल तर sudo वापरा. Check answer दाबा.
मध्यम एकूण sales
का: RDS setup नंतर database query करणं रोजचं काम.
काय करायचं: सगळ्या order amounts ची बेरीज.
Tables: customers(id, name, city) व orders(id, customer_id, amount, odate).
- Task कोणत्या table बद्दल आहे ते पाहा (box वरची table list).
- SQL statement step by step लिहा: काय, कुठून, कोणते rows.
- Statement ; ने संपवा.
- Check answer दाबा. Query table च्या practice copy वर चालते.
मध्यम Customer नावांसह orders
का: RDS setup नंतर database query करणं रोजचं काम.
काय करायचं: प्रत्येक customer नाव व order amount.
Tables: customers(id, name, city) व orders(id, customer_id, amount, odate).
- Task कोणत्या table बद्दल आहे ते पाहा (box वरची table list).
- SQL statement step by step लिहा: काय, कुठून, कोणते rows.
- Statement ; ने संपवा.
- Check answer दाबा. Query table च्या practice copy वर चालते.
मध्यम लहान orders काढा
का: RDS setup नंतर database query करणं रोजचं काम.
काय करायचं: 200 पेक्षा कमी amount चे orders delete.
Tables: customers(id, name, city) व orders(id, customer_id, amount, odate).
- Task कोणत्या table बद्दल आहे ते पाहा (box वरची table list).
- SQL statement step by step लिहा: काय, कुठून, कोणते rows.
- Statement ; ने संपवा.
- Check answer दाबा. Query table च्या practice copy वर चालते.
मध्यम City दुरुस्त करा
का: RDS setup नंतर database query करणं रोजचं काम.
काय करायचं: Customer 5 Rome ला गेले. Record update करा.
Tables: customers(id, name, city) व orders(id, customer_id, amount, odate).
- Task कोणत्या table बद्दल आहे ते पाहा (box वरची table list).
- SQL statement step by step लिहा: काय, कुठून, कोणते rows.
- Statement ; ने संपवा.
- Check answer दाबा. Query table च्या practice copy वर चालते.
अवघड Customer नुसार sales
का: RDS setup नंतर database query करणं रोजचं काम.
काय करायचं: Customer नुसार total, फक्त 1000 पेक्षा जास्त.
Tables: customers(id, name, city) व orders(id, customer_id, amount, odate).
- Task कोणत्या table बद्दल आहे ते पाहा (box वरची table list).
- SQL statement step by step लिहा: काय, कुठून, कोणते rows.
- Statement ; ने संपवा.
- Check answer दाबा. Query table च्या practice copy वर चालते.
अवघड Orders नसलेले customers
का: RDS setup नंतर database query करणं रोजचं काम.
काय करायचं: कधीच order न केलेल्या customers ची नावं.
Tables: customers(id, name, city) व orders(id, customer_id, amount, odate).
- Task कोणत्या table बद्दल आहे ते पाहा (box वरची table list).
- SQL statement step by step लिहा: काय, कुठून, कोणते rows.
- Statement ; ने संपवा.
- Check answer दाबा. Query table च्या practice copy वर चालते.
अवघड Database चा file मध्ये backup घ्या
का: mysqldump पूर्ण database SQL म्हणून लिहितो. मोठ्या बदलांआधी save करा.
काय करायचं: parisfashion_wp database root user ने (password विचारून) parisfashion_wp.sql मध्ये dump करा.
- हे काम करणारा Linux command शोधा.
- Task ला लागणारे options (उदा. -r, -h) जोडा.
- File नावं, folders किंवा users योग्य क्रमाने लिहा.
- System files/users बदलत असाल तर sudo वापरा. Check answer दाबा.
झटपट उजळणी cards
हा lesson दोन मिनिटांत revise करा. Cards phone वर save करा किंवा PNG download करा. प्रत्येक card वरचा QR त्याचा lesson उघडतो.
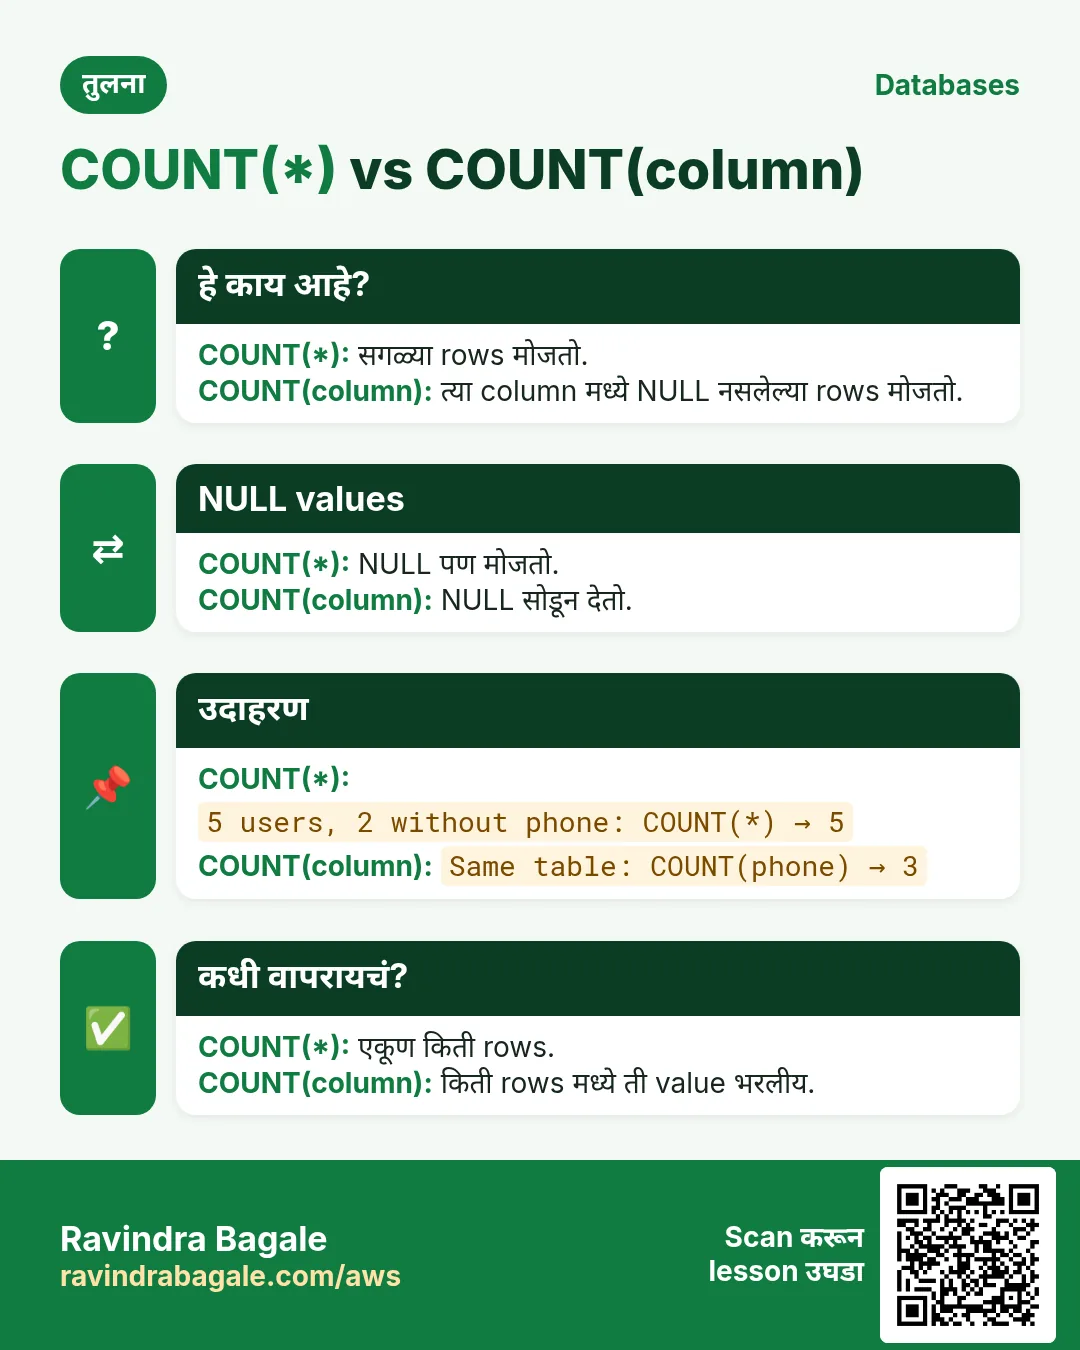
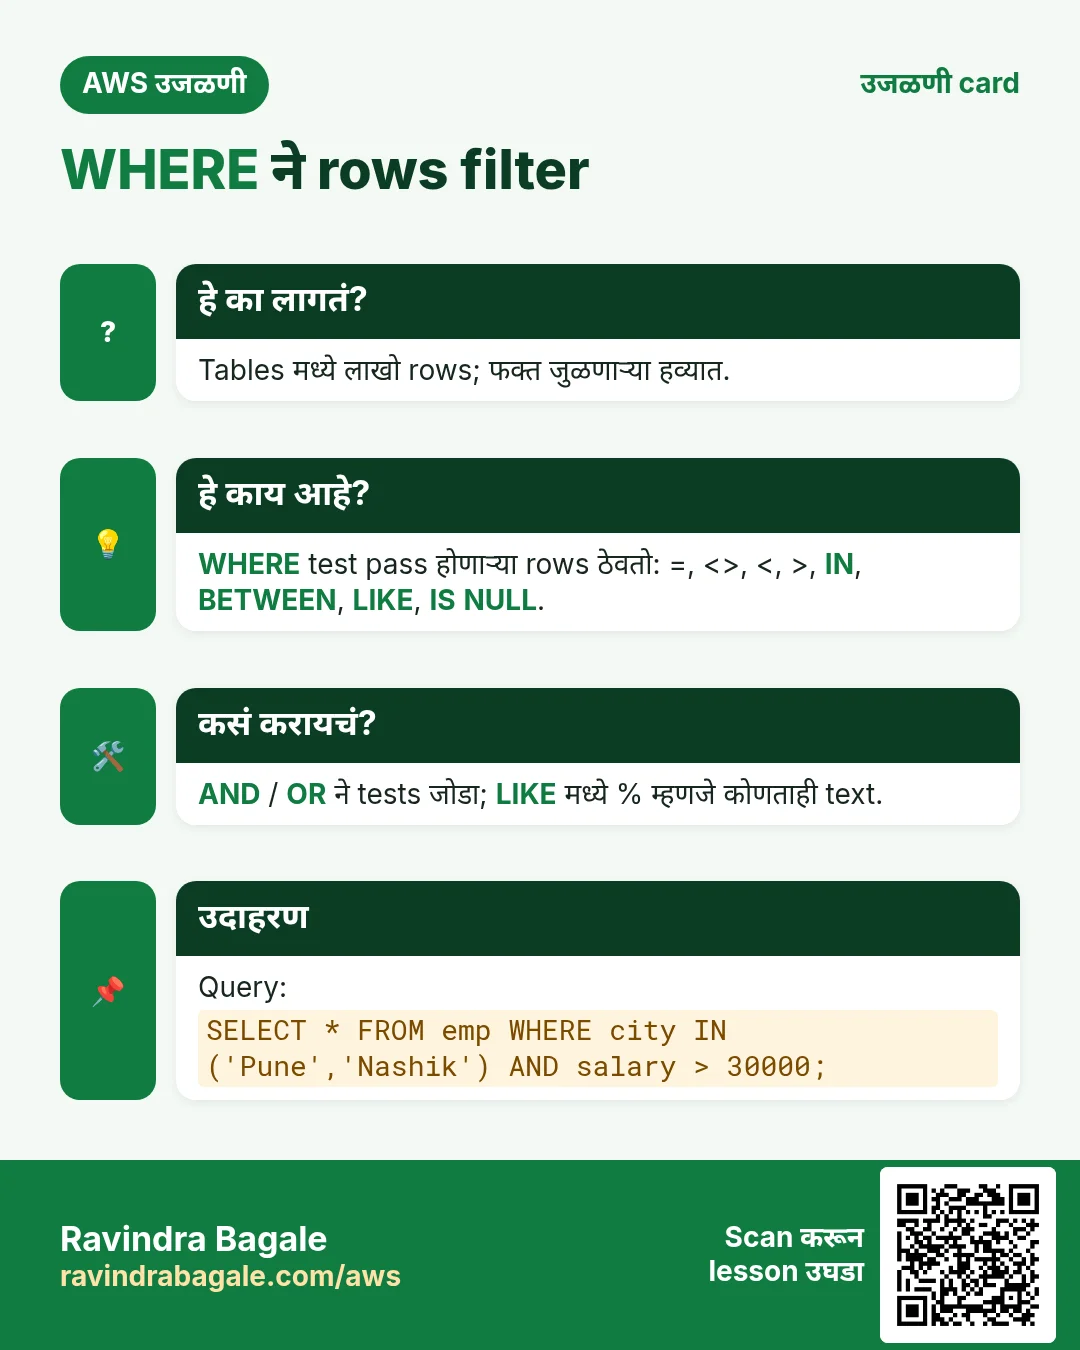
अजून cards: Ravi Sir's Cards.