Linux RAID mdadm सह आणि df व du: Disk Space Troubleshooting सोप्या भाषेत
Disks fail होतात. एक fail झाली तरी RAID तुमचा server चालू ठेवतो, data अनेक disks वर पसरवून किंवा copy करून. हा chapter mdadm ने software RAID शिकवतो (create, check, fail झालेली disk बदल, config save) आणि मग सगळ्यात सामान्य disk ticket: 'disk full'. df आणि du step by step, मोठ्या files कशा शोधायच्या, deleted files अजून जागा का वापरतात, आणि inodes संपल्यावर काय करायचं ते शिकाल.
या chapter मध्ये तुम्ही काय शिकाल
- RAID 0, 1, 5, 6 आणि 10 जाणून घ्या
- mdadm ने arrays बनवा आणि तपासा
- Fail disk बदला आणि rebuild बघा
- df -h, df -i आणि du बरोबर वाचा
- Disk काय भरतो ते शोधा
- जागा safely मोकळी करा, deleted-पण-open files सह
1. रोजचं उदाहरण: तुमच्या documents च्या xerox
हे का लागतं?
तुम्ही Aadhaar आणि property papers च्या दोन xerox वेगवेगळ्या bags मधे ठेवता. एक bag हरवली तरी दुसरी copy असते, आणि लगेच नवी copy काढता. वेगळं, तुमचं कपाट भरलं: कोणता कप्पा सगळ्यात मोठा ते बघता, मग त्यातला कोणता डबा, जुनी वर्तमानपत्रं सापडेपर्यंत.
हे काय आहे?
दोन bags मधे दोन copies = RAID 1. नवी copy = disk बदलल्यानंतर rebuild. कप्पा तपासणं = df. प्रत्येक डबा = du. जुनी वर्तमानपत्रं = मोठे जुने logs.
कसं करायचं (step by step)
2. RAID levels सोप्या शब्दांत
हे का लागतं?
चुकीचा level म्हणजे data loss किंवा वाया गेलेल्या disks.
हे काय आहे?
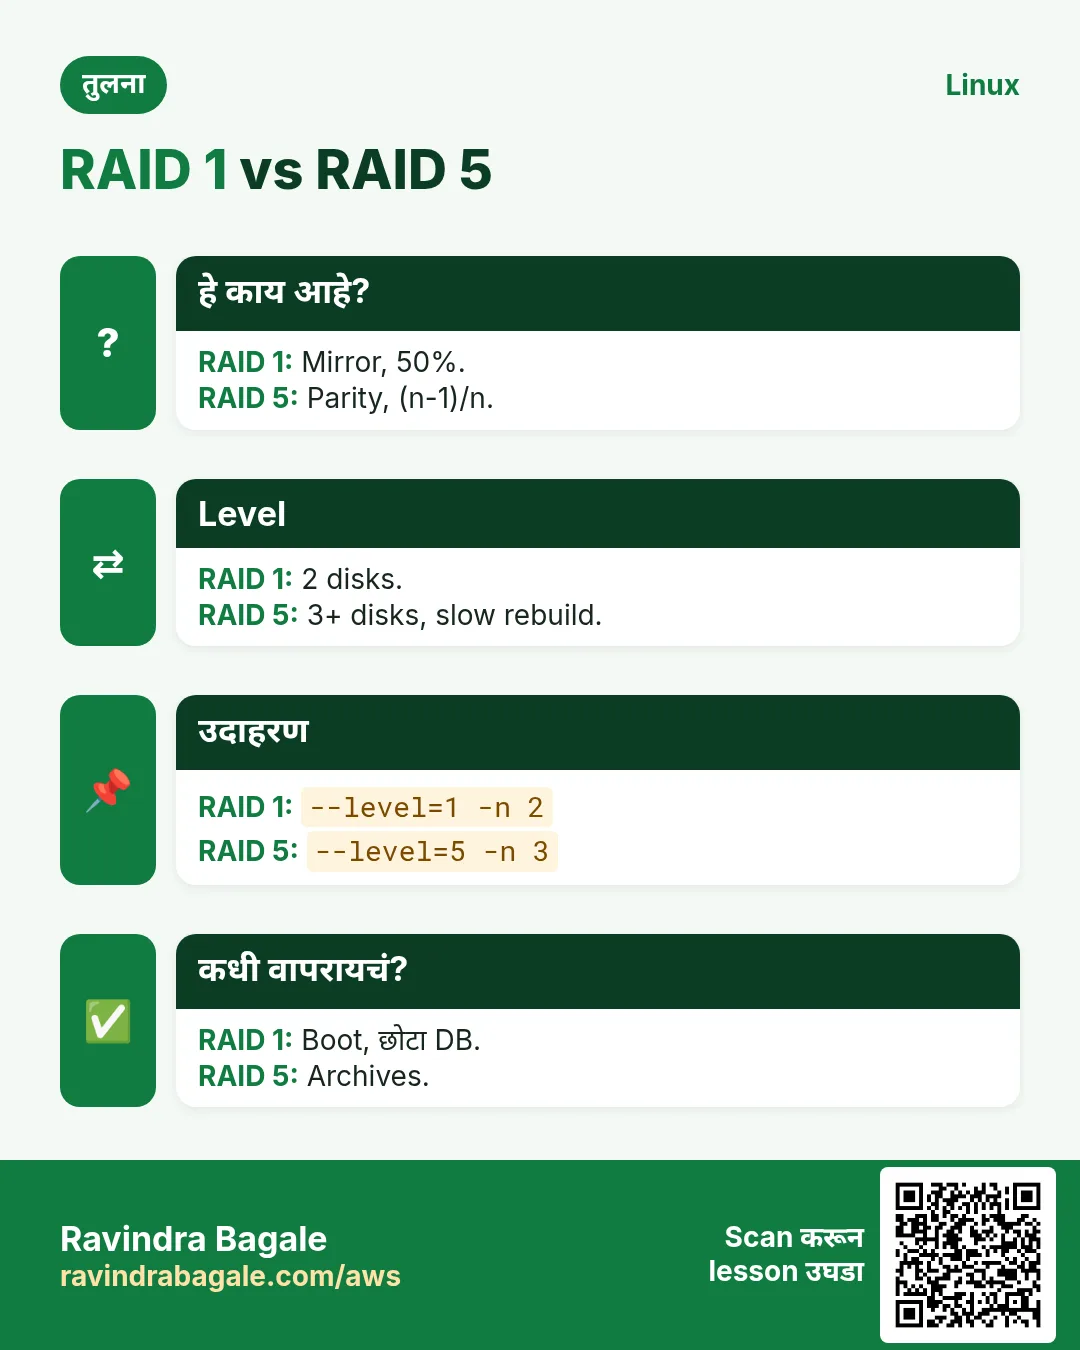
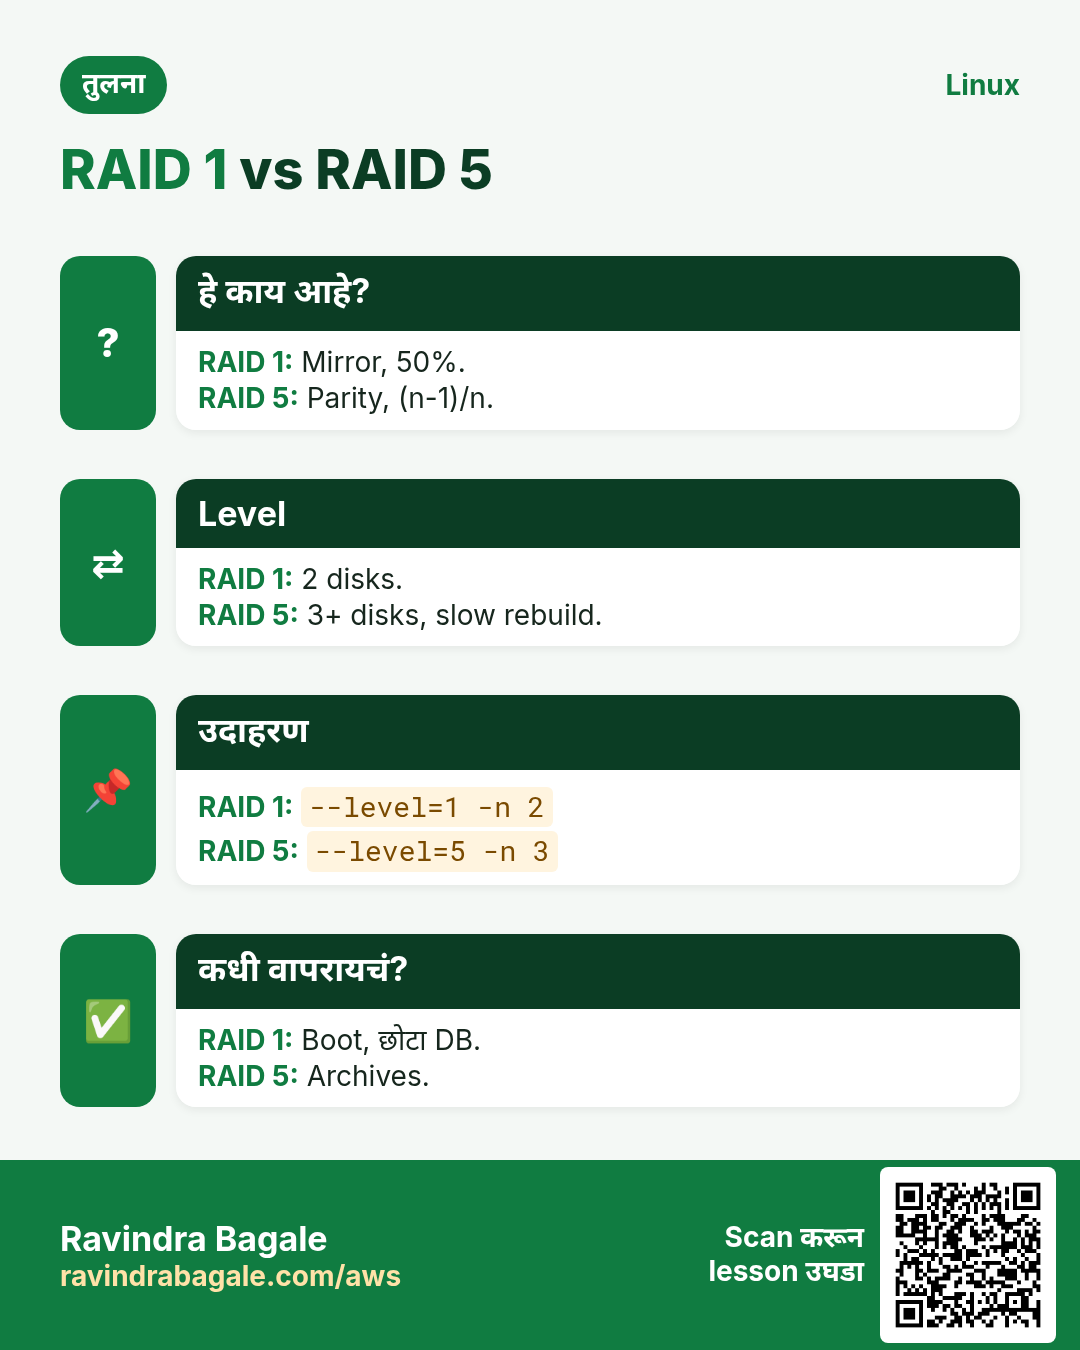
RAID 0: stripe, जलद, safety नाही. RAID 1: mirror, अर्धी जागा, एक failure टिकतो. RAID 5: parity, 3+ disks, एक टिकतो. RAID 6: double parity, 4+ disks, दोन टिकतात. RAID 10: striped mirrors, 4+ disks, जलद आणि safe. RAID backup नाही: deletes आणि ransomware पण copy होतात.
| Level | Min disks | टिकतो | वापरता येणारी |
|---|---|---|---|
| 0 | 2 | 0 | 100% |
| 1 | 2 | 1 | 50% |
| 5 | 3 | 1 | (n-1)/n |
| 6 | 4 | 2 | (n-2)/n |
| 10 | 4 | प्रत्येक mirror ला 1 | 50% |
कसं करायचं (step by step)
- Support तपासा.
cat /proc/mdstatOutput:
Personalities : [raid1] [raid6] [raid5] [raid4] [raid10]
unused devices: <none>
याचा अर्थ: Kernel तयार.
- mdadm install.
sudo dnf install -y mdadm && mdadm --versionOutput:
mdadm - v4.2याचा अर्थ: Tool तयार.
3. mdadm --create: array बनवा
हे का लागतं?
Database साठी दोन disks एक safe disk म्हणून हव्यात.
हे काय आहे?
sudo mdadm --create /dev/md0 --level=1 --raid-devices=2 DEV1 DEV2. RAID 5 साठी --level=5 --raid-devices=3. Hot spare साठी --spare-devices=1 DEV. सुरुवातीचं resync background मधे; लगेच mkfs करून वापरता येतं.
कसं करायचं (step by step)
- Mirror.
sudo mdadm --create /dev/md0 --level=1 --raid-devices=2 /dev/nvme1n1 /dev/nvme2n1Output:
mdadm: array /dev/md0 started.याचा अर्थ: RAID 1 तयार.
- Spare सह RAID 5.
sudo mdadm --create /dev/md1 --level=5 --raid-devices=3 --spare-devices=1 /dev/sd[b-e]Output:
mdadm: array /dev/md1 started.याचा अर्थ: 3 data + 1 spare.
- वापरा.
sudo mkfs.xfs /dev/md0 && sudo mkdir -p /data && sudo mount /dev/md0 /dataOutput:
meta-data=/dev/md0 ...याचा अर्थ: कोणत्याही disk सारखं.
4. /proc/mdstat आणि mdadm --detail: health
हे का लागतं?
शांतपणे degraded चालणारा RAID खोटी सुरक्षितता देतो.
हे काय आहे?
cat /proc/mdstat प्रत्येक array, members, [UU] (सगळे up) किंवा [U_] (एक नाही), आणि resync progress. mdadm --detail /dev/md0 State (clean, degraded, recovering), प्रत्येक device ची role आणि UUID. watch -n2 cat /proc/mdstat rebuild follow.
कसं करायचं (step by step)
- Healthy.
cat /proc/mdstatOutput:
md0 : active raid1 nvme2n1[1] nvme1n1[0]
      104791040 blocks super 1.2 [2/2] [UU]
याचा अर्थ: दोन्ही up.
- Degraded.
cat /proc/mdstatOutput:
md0 : active raid1 nvme2n1[1](F) nvme1n1[0]
      [2/1] [U_]
याचा अर्थ: Disk 2 fail.
- Detail.
sudo mdadm --detail /dev/md0 | grep -E 'State|Active|Failed'Output:
State : clean, degraded
Active Devices : 1
Failed Devices : 1
याचा अर्थ: आत्ता action.
5. Fail disk बदला: --fail, --remove, --add
हे का लागतं?
खऱ्या आयुष्यातलं सगळ्यात सामान्य RAID काम.
हे काय आहे?
1 mdadm /dev/md0 --fail DEV (आधीच F नसेल तर). 2 mdadm /dev/md0 --remove DEV. 3 Disk बदला. 4 mdadm /dev/md0 --add NEWDEV. 5 [UU] होईपर्यंत /proc/mdstat बघा. Hot spare असेल तर rebuild आपोआप.
कसं करायचं (step by step)
- Fail आणि remove.
sudo mdadm /dev/md0 --fail /dev/nvme2n1 --remove /dev/nvme2n1Output:
mdadm: set /dev/nvme2n1 faulty in /dev/md0
mdadm: hot removed /dev/nvme2n1 from /dev/md0
याचा अर्थ: Array बाहेर.
- नवी जोडा.
sudo mdadm /dev/md0 --add /dev/nvme3n1Output:
mdadm: added /dev/nvme3n1याचा अर्थ: Rebuild सुरू.
- बघा.
cat /proc/mdstatOutput:
md0 : active raid1 nvme3n1[2] nvme1n1[0]
      [2/1] [U_]
      [=====>.......]  recovery = 41.2% finish=6.1min
याचा अर्थ: [UU] ची वाट.
6. Config save: mdadm.conf आणि initramfs
हे का लागतं?
Config save नसेल तर array /dev/md127 म्हणून येऊ शकतो किंवा boot ला assemble होत नाही.
हे काय आहे?
mdadm --detail --scan ARRAY lines print. /etc/mdadm.conf (RHEL) किंवा /etc/mdadm/mdadm.conf (Ubuntu) मधे जोडा. मग initramfs rebuild: dracut -f (RHEL) किंवा update-initramfs -u (Ubuntu). fstab मधे md device किंवा filesystem UUID nofail सह.
कसं करायचं (step by step)
- Scan आणि save.
sudo mdadm --detail --scan | sudo tee -a /etc/mdadm.confOutput:
ARRAY /dev/md0 metadata=1.2 name=db1:0 UUID=5d2c...e1याचा अर्थ: Save.
- Initramfs.
sudo dracut -fOutput:
(no output)याचा अर्थ: Boot ला array माहीत.
- Manual assemble.
sudo mdadm --assemble --scanOutput:
mdadm: /dev/md0 has been started with 2 drives.याचा अर्थ: Disks नव्या server ला हलवल्यावर.
7. RAID monitoring: mdadm --monitor
हे का लागतं?
रात्री 2 ला fail disk ने alert पाठवावा, आठवड्यांनी सापडू नये.
हे काय आहे?
mdadm.conf मधे MAILADDR you@example.com आणि mdmonitor.service enable. mdadm --monitor --scan --oneshot --test test alert. अनेक teams node_exporter ने /proc/mdstat scrape करतात.
कसं करायचं (step by step)
- Enable.
echo 'MAILADDR ops@example.com' | sudo tee -a /etc/mdadm.conf && sudo systemctl enable --now mdmonitorOutput:
Created symlink ... mdmonitor.serviceयाचा अर्थ: Alerts चालू.
- Test.
sudo mdadm --monitor --scan --oneshot --testOutput:
(test mail sent)याचा अर्थ: Mailbox तपासा.
8. df -h: कोणता filesystem full
हे का लागतं?
'Disk full' alerts df मधून. Files शोधण्याआधी कोणता mount full ते शोधा.
हे काय आहे?
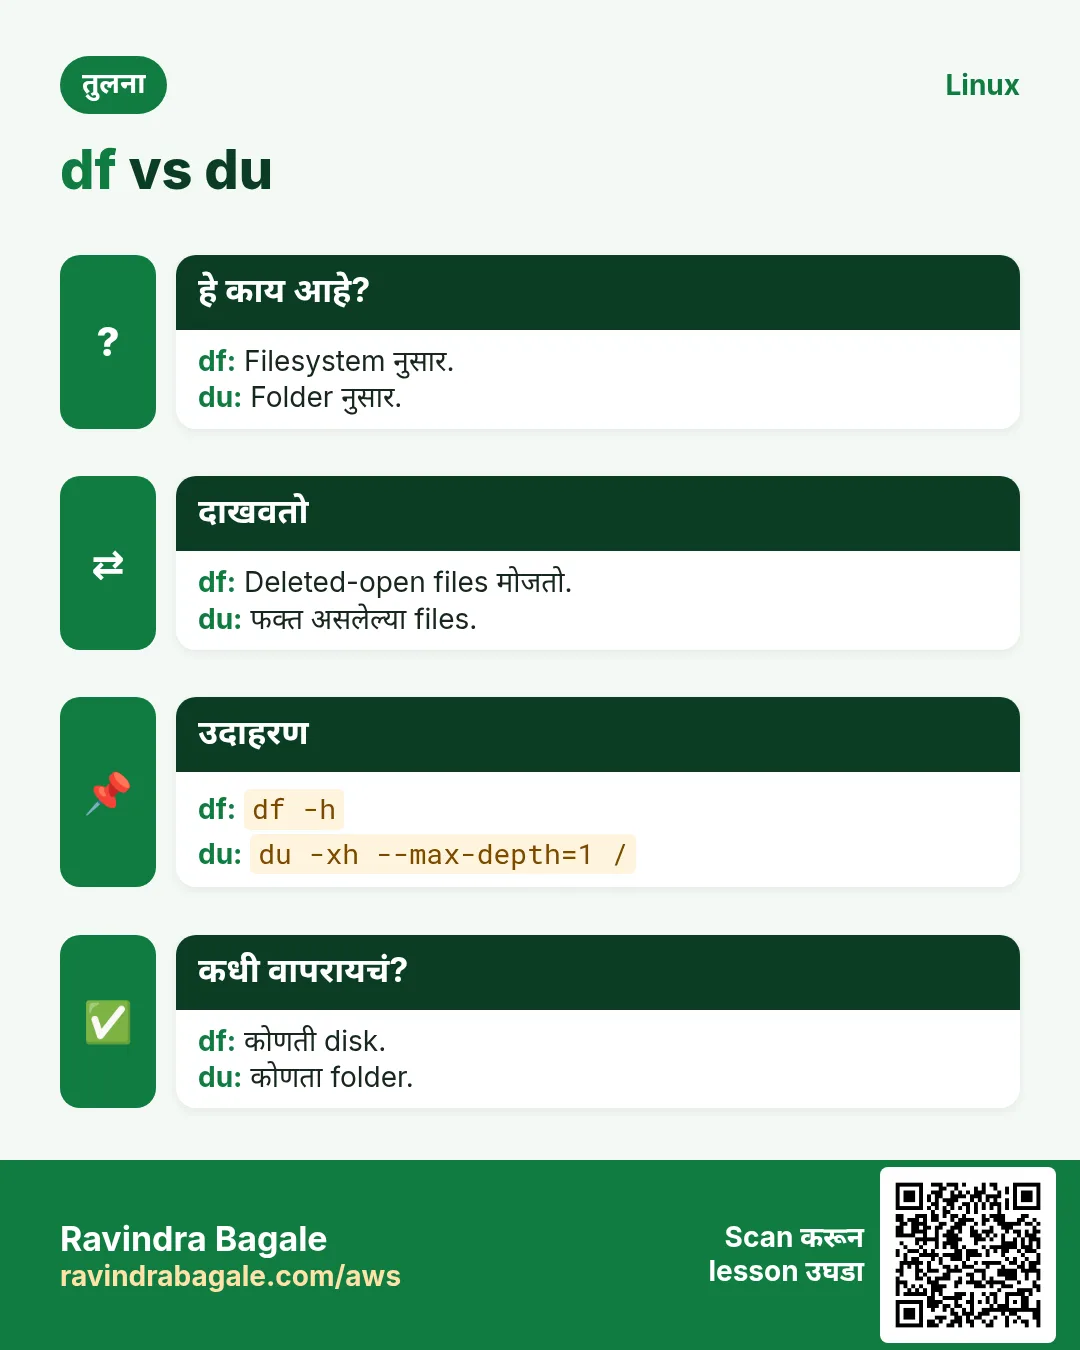
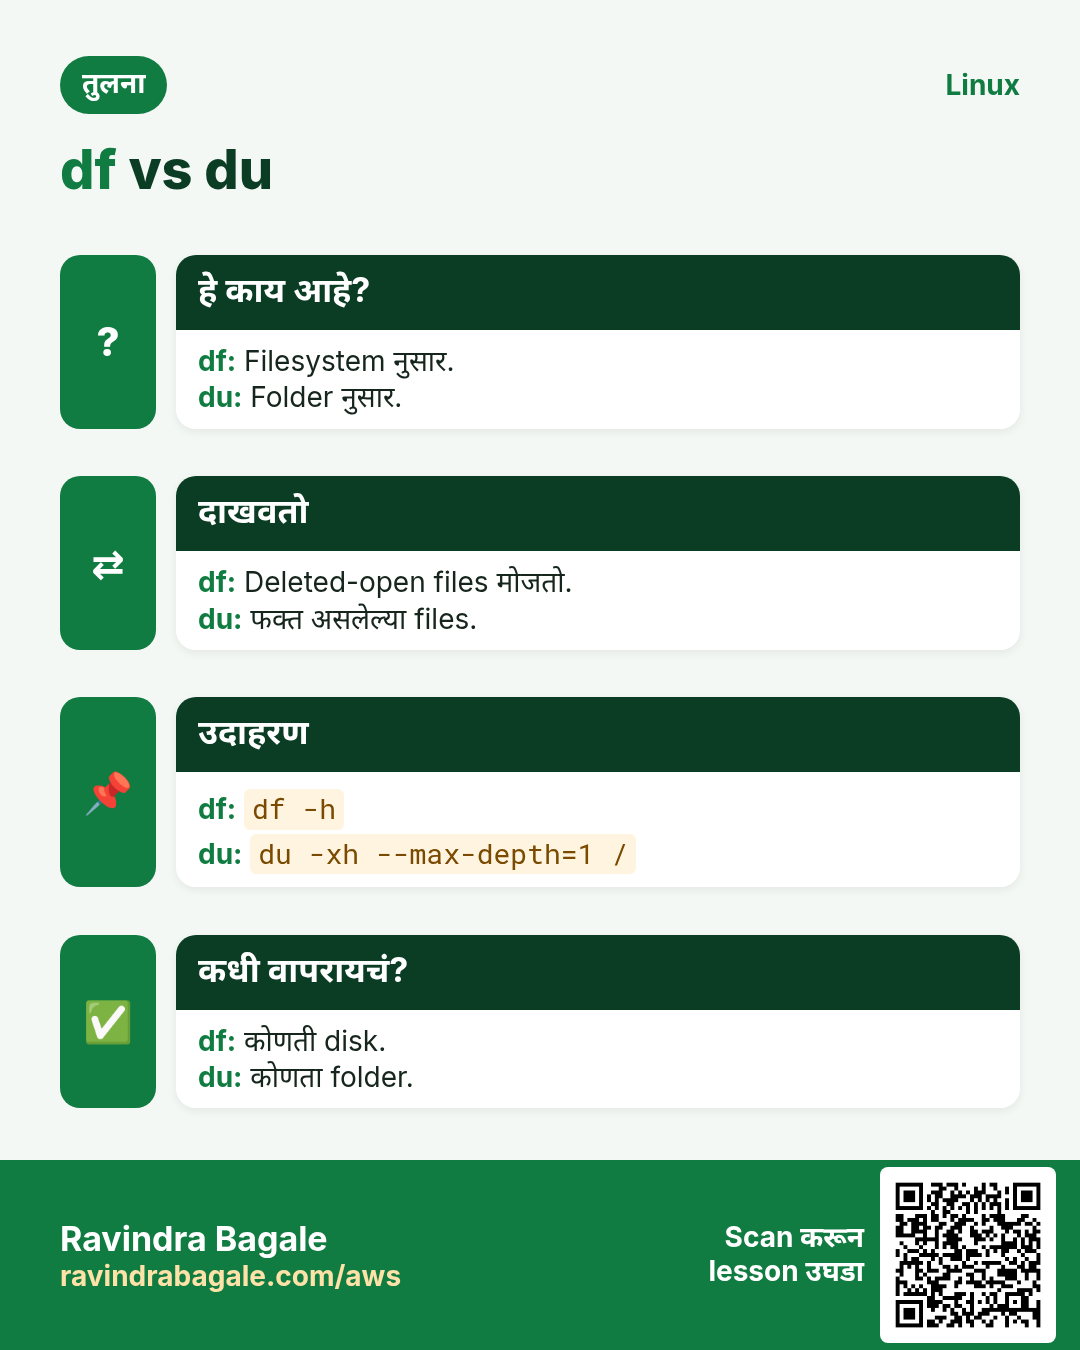
df -h प्रत्येक mounted filesystem ची size, used, available आणि Use%. एका path साठी df -h /var. df -hT type. -x tmpfs -x devtmpfs memory filesystems लपवतो. 85% वर cleanup plan; 100% ला apps write fail.
कसं करायचं (step by step)
- सगळे.
df -hT -x tmpfs -x devtmpfsOutput:
Filesystem     Type Size Used Avail Use% Mounted on
/dev/nvme0n1p1 xfs   20G  19G  1.0G  95% /
/dev/md0       xfs  100G  41G   59G  41% /data
याचा अर्थ: Root हा problem.
- Path कोणत्या filesystem वर?
df -h /var/logOutput:
/dev/nvme0n1p1 20G 19G 1.0G 95% /याचा अर्थ: /var/log root वर.
9. du: कोणता folder मोठा
हे का लागतं?
df कोणता filesystem ते सांगतो; du कोणता folder आणि file जागा वापरतो ते.
हे काय आहे?
du -sh DIR एका folder चं total. du -h --max-depth=1 DIR | sort -h sub-folders size नुसार. -x एकाच filesystem वर (/ वर महत्त्वाचं). find / -xdev -type f -size +500M -exec ls -lh {} + मोठ्या files. ncdu friendly interactive version.
कसं करायचं (step by step)
- Root चा top level.
sudo du -xh --max-depth=1 / 2>/dev/null | sort -h | tail -4Output:
1.2G /usr
2.1G /opt
14G  /var
19G  /
याचा अर्थ: /var मोठा.
- आत जा.
sudo du -xh --max-depth=1 /var/log | sort -h | tail -3Output:
180M /var/log/journal
11G  /var/log/app
12G  /var/log
याचा अर्थ: App logs.
- सगळ्यात मोठ्या files.
sudo find /var/log/app -type f -size +1G -exec ls -lh {} +Output:
-rw-r--r-- 1 app app 9.8G Oct 25 debug.logयाचा अर्थ: एक debug log.
- Interactive.
sudo ncdu -x /Output:
(browse with arrows)याचा अर्थ: शोधायला जलद.
10. जागा safely मोकळी करा
हे का लागतं?
चुकीची file किंवा app ने open ठेवलेला log delete केल्यास जास्त बिघडतं.
हे काय आहे?
Active log delete करण्याऐवजी truncate: truncate -s 0 FILE (किंवा : > FILE). Journal साफ: journalctl --vacuum-size=200M. Package caches: dnf clean all / apt clean. जुन्या container images: docker system prune. मग logrotate (chapter 21) ने कारण fix.
कसं करायचं (step by step)
- Active log रिकामा.
sudo truncate -s 0 /var/log/app/debug.log && df -h /Output:
/dev/nvme0n1p1 20G 9.2G 11G 46% /याचा अर्थ: लगेच जागा परत.
- Journal.
sudo journalctl --vacuum-size=200MOutput:
Vacuuming done, freed 1.4G of archived journalsयाचा अर्थ: मोकळं.
- Caches.
sudo dnf clean allOutput:
42 files removedयाचा अर्थ: छोटा फायदा.
11. Deleted पण अजून open: lsof +L1
हे का लागतं?
10G log delete केला पण df अजून full दाखवतो. File folder मधून गेली पण process अजून ती open धरतो.
हे काय आहे?
sudo lsof +L1 link count 0 (deleted) असलेल्या open files. Fix: process restart किंवा reload, किंवा /proc/PID/fd/N ने truncate. असं झालं की du आणि df जुळत नाहीत.
कसं करायचं (step by step)
- शोधा.
sudo lsof +L1Output:
COMMAND PID  USER FD SIZE/OFF   NLINK NAME
java    2201 app  5w 10737418240 0    /var/log/app/debug.log (deleted)
याचा अर्थ: Java अजून लिहितो.
- Restart शिवाय मोकळं.
sudo truncate -s 0 /proc/2201/fd/5 && df -h /Output:
/dev/nvme0n1p1 20G 9.1G 11G 45% /याचा अर्थ: जागा मोकळी.
- किंवा restart.
sudo systemctl restart myappOutput:
(no output)याचा अर्थ: Process file बंद करतो.
12. Inodes: df -i
हे का लागतं?
Disk free GBs दाखवते तरी 'No space left' म्हणते कारण inodes (file entries) संपले, बहुतेक लाखो छोट्या files मुळे.
हे काय आहे?
df -i प्रत्येक filesystem चा inode वापर. जास्त files असलेले folders: sudo find /var -xdev -type f | cut -d/ -f2-4 | sort | uniq -c | sort -n | tail. सामान्य कारणं: session files, mail queues, cache folders. जुन्या find -mtime +7 -delete ने काढा.
कसं करायचं (step by step)
- Inodes full.
df -i /Output:
Filesystem     Inodes IUsed IFree IUse% Mounted on
/dev/sdc1      1.3M  1.3M  0     100% /
याचा अर्थ: Inodes संपले.
- कुठे?
sudo find / -xdev -type f | cut -d/ -f2-4 | sort | uniq -c | sort -n | tail -2Output:
  48120 var/lib/php
1201188 var/lib/php/sessions
याचा अर्थ: PHP sessions.
- जुन्या साफ.
sudo find /var/lib/php/sessions -type f -mmin +1440 -delete && df -i /Output:
IUse% 9%याचा अर्थ: Fix.
13. अनेक industries मधली खरी उदाहरणं
हे का लागतं?
तेच Linux skill प्रत्येक प्रकारच्या company मध्ये लागतं. वेगवेगळ्या ठिकाणी पाहिलं की लक्षात राहतं.
हे काय आहे?
प्रत्येक row म्हणजे एक काल्पनिक team. कोण हे वापरतं आणि कसं ते दाखवते.
कसं करायचं (step by step)
| Team आणि शहर | ते कसं वापरतात | Command |
|---|---|---|
| Anil, stock broker, Pune | Trading DB साठी RAID 1 | mdadm --create /dev/md0 --level=1 |
| Helen, cloud hosting, Amsterdam | Busy MySQL साठी RAID 10 | mdadm --level=10 --raid-devices=4 |
| Takeshi, video, Kyoto | मोठ्या media archives साठी RAID 6 | mdadm --level=6 |
| Zara, e-commerce, Karachi | Deleted open logs शोधते | lsof +L1 |
| Paulo, hosting, Lisbon | Inode-full PHP servers fix | df -i |
| Meera, school portal, Nashik | Team ला weekly du report | du -xh --max-depth=1 / | sort -h |
14. नेहमीच्या errors आणि त्यांचे fixes
हे का लागतं?
हे errors सगळ्यांना येतात. कारण माहीत असलं की तास वाचतात.
हे काय आहे?
आधी नेमका message वाचा. मग खालच्या row शी जुळवा.
कसं करायचं (step by step)
| दिसणारा error | का होतं | Fix कसा करायचा |
|---|---|---|
No space left on device | Filesystem किंवा inodes full | df -h आणि df -i.df -h; df -i |
df full but du shows less | Deleted files अजून open | शोधून सोडवा.sudo lsof +L1 |
md0 [U_] degraded | एक disk fail | लगेच बदला.sudo mdadm --detail /dev/md0 |
mdadm: cannot open /dev/sdb: Device or resource busy | Disk वापरात किंवा जुना md metadata | Free असेल तर तपासून superblock zero.sudo mdadm --zero-superblock /dev/sdb |
Array appears as /dev/md127 after reboot | Config save नाही | mdadm.conf save, initramfs rebuild.sudo mdadm --detail --scan |
du: cannot read directory: Permission denied | Root नाही | sudo ने.sudo du -sh /var |
du takes forever on / | इतर mounts मधे जातो (NFS) | -x वापरा.sudo du -xsh / |
rm deleted log but space not freed | App file धरतो | Truncate किंवा restart.sudo systemctl restart myapp |
mdadm: add new device failed: Invalid argument | नवी disk members पेक्षा छोटी | तेवढी किंवा मोठी size.lsblk -b |
journal is using 4G | Size limit नाही | Vacuum आणि SystemMaxUse.sudo journalctl --vacuum-size=200M |
15. Troubleshooting step by step
हे का लागतं?
'Disk full' साठी filesystem ते folder ते file ते process.
हे काय आहे?
वरून खाली जा. ज्या step ला problem दिसतो तिथे थांबा.
कसं करायचं (step by step)
- कोणता filesystem?
df -hT -x tmpfs- Inodes?
df -i- कोणता folder?
sudo du -xh --max-depth=1 / | sort -h- कोणती file?
sudo find / -xdev -type f -size +1G- Deleted पण open?
sudo lsof +L1- RAID healthy?
cat /proc/mdstat16. Lab 1: Loop devices वर RAID 1 आणि failure
हे का लागतं?
Mirror बनवा, disk fail करा, नवी जोडा आणि rebuild बघा.
हे काय आहे?
पूर्ण hands-on lab. प्रत्येक step test Linux machine वर करा (EC2 instance, VM किंवा WSL).
कसं करायचं (step by step)
- तीन fake disks.
for i in 1 2 3; do truncate -s 300M /tmp/r$i.img; sudo losetup -f --show /tmp/r$i.img; doneOutput:
/dev/loop1
/dev/loop2
/dev/loop3- Mirror.
sudo mdadm --create /dev/md9 --level=1 --raid-devices=2 /dev/loop1 /dev/loop2 --runOutput:
mdadm: array /dev/md9 started.- एक fail.
sudo mdadm /dev/md9 --fail /dev/loop2 --remove /dev/loop2Output:
hot removed /dev/loop2- नवी जोडा.
sudo mdadm /dev/md9 --add /dev/loop3 && cat /proc/mdstatOutput:
recovery = ...- थांबवा.
sudo mdadm --stop /dev/md9Output:
mdadm: stopped /dev/md917. Lab 2: भरा, शोधा आणि मोकळं करा
हे का लागतं?
Process ने open ठेवलेली मोठी file बनवा, delete करा, आणि जागा परत मिळवा.
हे काय आहे?
पूर्ण hands-on lab. प्रत्येक step test Linux machine वर करा (EC2 instance, VM किंवा WSL).
कसं करायचं (step by step)
- मोठी file.
fallocate -l 1G /tmp/big.log && df -h /tmpOutput:
Used +1G- Open धरा.
tail -f /tmp/big.log &Output:
[1] 4321- Delete.
rm /tmp/big.log && df -h /tmpOutput:
Still used- शोधा.
lsof +L1 | grep big.logOutput:
tail 4321 ... /tmp/big.log (deleted)- सोडवा.
kill %1 && df -h /tmpOutput:
Space backRavindra Bagale's Tip
When df and du disagree, run sudo lsof +L1 before anything else. A deleted log still held by a running app is the most common reason, and truncating it through /proc/PID/fd or restarting the app frees the space at once.
Ravindra Bagale's Tip – मराठी
df आणि du जुळत नसतील तर इतर काहीही आधी sudo lsof +L1 चालवा. चालू app ने धरलेला deleted log हे सगळ्यात सामान्य कारण, आणि /proc/PID/fd ने truncate किंवा app restart केल्यावर जागा लगेच मोकळी.
Ravindra Bagale's Tip – हिंदी
df और du मेल न खाएं तो सबसे पहले sudo lsof +L1 चलाइए. चलते app द्वारा पकड़ा deleted log सबसे आम कारण है, और /proc/PID/fd से truncate या app restart करते ही जगह तुरंत खाली हो जाती है.
18. नेहमी विचारले जाणारे प्रश्न
प्र. RAID backup आहे?
नाही. Disk failure पासून वाचवतो, deletes किंवा corruption पासून नाही.
प्र. Software की hardware RAID?
mdadm reliable आणि portable; hardware RAID ला vendor tools.
प्र. Cloud मधे RAID?
EBS आधीच replicated; speed साठी कधी RAID 0.
प्र. मोठ्या disks वर RAID 5?
Rebuild ला वेळ; RAID 6 किंवा 10 safer.
प्र. df आणि du वेगळे का?
Deleted open files, reserved blocks, किंवा mounts खाली लपलेल्या files.
प्र. du मधे -x?
एकाच filesystem वर.
प्र. Logs delete की truncate?
Active logs truncate; फक्त बंद जुन्या files delete.
प्र. Inodes कोण वापरतो?
प्रत्येक file आणि folder एक.
19. मुलाखत प्रश्न आणि उत्तरं
Beginner level
प्र. Filesystem नुसार disk usage?
df -h.
प्र. Folder ची size?
du -sh DIR.
प्र. RAID 1 म्हणजे?
दोन disks चा mirror.
प्र. RAID status?
cat /proc/mdstat.
Mid level level
प्र. Fail RAID disk बदल?
--fail, --remove, मग नवी --add, mdstat बघा.
प्र. df full, du नाही?
Deleted open files साठी lsof +L1.
प्र. जागा नाही पण GBs free?
Inodes full: df -i.
प्र. Reboot नंतर array नाव?
--detail --scan mdadm.conf मधे, initramfs rebuild.
Senior level
प्र. Write-heavy DB साठी RAID?
RAID 10: जलद writes आणि safe; RAID 5 write penalty टाळा.
प्र. Prod वर रात्री 3 ला disk full: steps?
df, du -x drill-down, lsof +L1, truncate/vacuum, मग root cause आणि alert threshold.
प्र. Disk full incidents टाळा?
logrotate, journald limits, वेगळे LVs, 80% ला alerts, cleanup jobs.
प्र. RAID 5 मधे दोन disks fail?
Array गेला; backup मधून restore. म्हणून RAID 6/backups महत्त्वाचे.
घरी करून बघा
- तुमच्या machine वर df -hT आणि sudo du -xh --max-depth=1 / | sort -h चालवा आणि top तीन जागा वापरणारे लिहा.
- चार loop devices (तीन अधिक एक spare) वापरून RAID 5 ने Lab 1 करा.
सराव Tasks
Nairobi Ride हा नैरोबी मधला वाहतूक व्यवसाय आहे. Wanjiru Kamau त्यांचं IT व cloud काम पाहतात. त्यांचे पैसे KES मध्ये मोजले जातात आणि AWS resources af-south-1 Region मध्ये चालतात. खालच्या tasks मध्ये तुम्ही या lesson मध्ये शिकलेलं वापरून त्यांची खरी कामं करता. सगळी नावं, account IDs, IP addresses व numbers सरावासाठी काल्पनिक आहेत.
0 / 18
सोपं RAID status
का: Disk failures आणि full disks apps थांबवतात.
काय करायचं: Kernel RAID status दर 5 seconds refresh.
- हे काम करणारा Linux command शोधा.
- Task ला लागणारे options (उदा. -r, -h) जोडा.
- File नावं, folders किंवा users योग्य क्रमाने लिहा.
- System files/users बदलत असाल तर sudo वापरा. Check answer दाबा.
सोपं Array detail
का: Disk failures आणि full disks apps थांबवतात.
काय करायचं: /dev/md2 चे पूर्ण details.
- हे काम करणारा Linux command शोधा.
- Task ला लागणारे options (उदा. -r, -h) जोडा.
- File नावं, folders किंवा users योग्य क्रमाने लिहा.
- System files/users बदलत असाल तर sudo वापरा. Check answer दाबा.
सोपं Disk free
का: Disk failures आणि full disks apps थांबवतात.
काय करायचं: फक्त xfs filesystems चा disk usage, human sizes.
- हे काम करणारा Linux command शोधा.
- Task ला लागणारे options (उदा. -r, -h) जोडा.
- File नावं, folders किंवा users योग्य क्रमाने लिहा.
- System files/users बदलत असाल तर sudo वापरा. Check answer दाबा.
सोपं Path वर free
का: Disk failures आणि full disks apps थांबवतात.
काय करायचं: /srv कोणत्या filesystem वर आणि किती भरलं.
- हे काम करणारा Linux command शोधा.
- Task ला लागणारे options (उदा. -r, -h) जोडा.
- File नावं, folders किंवा users योग्य क्रमाने लिहा.
- System files/users बदलत असाल तर sudo वापरा. Check answer दाबा.
सोपं Inodes
का: Disk failures आणि full disks apps थांबवतात.
काय करायचं: /srv असलेल्या filesystem चा inode usage.
- हे काम करणारा Linux command शोधा.
- Task ला लागणारे options (उदा. -r, -h) जोडा.
- File नावं, folders किंवा users योग्य क्रमाने लिहा.
- System files/users बदलत असाल तर sudo वापरा. Check answer दाबा.
सोपं Folder size
का: Disk failures आणि full disks apps थांबवतात.
काय करायचं: /srv/uploads ची total size.
- हे काम करणारा Linux command शोधा.
- Task ला लागणारे options (उदा. -r, -h) जोडा.
- File नावं, folders किंवा users योग्य क्रमाने लिहा.
- System files/users बदलत असाल तर sudo वापरा. Check answer दाबा.
मध्यम RAID 1
का: Disk failures आणि full disks apps थांबवतात.
काय करायचं: /dev/xvdm आणि /dev/xvdn पासून /dev/md2 RAID 1.
- हे काम करणारा Linux command शोधा.
- Task ला लागणारे options (उदा. -r, -h) जोडा.
- File नावं, folders किंवा users योग्य क्रमाने लिहा.
- System files/users बदलत असाल तर sudo वापरा. Check answer दाबा.
मध्यम Fail mark
का: Disk failures आणि full disks apps थांबवतात.
काय करायचं: /dev/md2 मधे /dev/xvdn failed mark.
- हे काम करणारा Linux command शोधा.
- Task ला लागणारे options (उदा. -r, -h) जोडा.
- File नावं, folders किंवा users योग्य क्रमाने लिहा.
- System files/users बदलत असाल तर sudo वापरा. Check answer दाबा.
मध्यम Array मधून काढा
का: Disk failures आणि full disks apps थांबवतात.
काय करायचं: /dev/md2 मधून /dev/xvdn काढा.
- हे काम करणारा Linux command शोधा.
- Task ला लागणारे options (उदा. -r, -h) जोडा.
- File नावं, folders किंवा users योग्य क्रमाने लिहा.
- System files/users बदलत असाल तर sudo वापरा. Check answer दाबा.
मध्यम नवी disk
का: Disk failures आणि full disks apps थांबवतात.
काय करायचं: /dev/md2 ला /dev/xvdo जोडा.
- हे काम करणारा Linux command शोधा.
- Task ला लागणारे options (उदा. -r, -h) जोडा.
- File नावं, folders किंवा users योग्य क्रमाने लिहा.
- System files/users बदलत असाल तर sudo वापरा. Check answer दाबा.
मध्यम Sub-folder sizes
का: Disk failures आणि full disks apps थांबवतात.
काय करायचं: /srv खाली एक level sizes, लहान ते मोठे.
- हे काम करणारा Linux command शोधा.
- Task ला लागणारे options (उदा. -r, -h) जोडा.
- File नावं, folders किंवा users योग्य क्रमाने लिहा.
- System files/users बदलत असाल तर sudo वापरा. Check answer दाबा.
मध्यम एकाच fs वर
का: Disk failures आणि full disks apps थांबवतात.
काय करायचं: इतर filesystems मधे न जाता /home ची total size.
- हे काम करणारा Linux command शोधा.
- Task ला लागणारे options (उदा. -r, -h) जोडा.
- File नावं, folders किंवा users योग्य क्रमाने लिहा.
- System files/users बदलत असाल तर sudo वापरा. Check answer दाबा.
मध्यम Log रिकामा
का: Disk failures आणि full disks apps थांबवतात.
काय करायचं: /srv/app/trace.log delete न करता रिकामा.
- हे काम करणारा Linux command शोधा.
- Task ला लागणारे options (उदा. -r, -h) जोडा.
- File नावं, folders किंवा users योग्य क्रमाने लिहा.
- System files/users बदलत असाल तर sudo वापरा. Check answer दाबा.
मध्यम वेळेनुसार journal
का: Disk failures आणि full disks apps थांबवतात.
काय करायचं: 7 दिवसांपेक्षा जुन्या journal files delete.
- हे काम करणारा Linux command शोधा.
- Task ला लागणारे options (उदा. -r, -h) जोडा.
- File नावं, folders किंवा users योग्य क्रमाने लिहा.
- System files/users बदलत असाल तर sudo वापरा. Check answer दाबा.
अवघड ARRAY lines
का: Disk failures आणि full disks apps थांबवतात.
काय करायचं: सगळ्या arrays साठी ARRAY lines (mdadm.conf साठी).
- हे काम करणारा Linux command शोधा.
- Task ला लागणारे options (उदा. -r, -h) जोडा.
- File नावं, folders किंवा users योग्य क्रमाने लिहा.
- System files/users बदलत असाल तर sudo वापरा. Check answer दाबा.
अवघड Array stop
का: Disk failures आणि full disks apps थांबवतात.
काय करायचं: /dev/md2 array stop.
- हे काम करणारा Linux command शोधा.
- Task ला लागणारे options (उदा. -r, -h) जोडा.
- File नावं, folders किंवा users योग्य क्रमाने लिहा.
- System files/users बदलत असाल तर sudo वापरा. Check answer दाबा.
अवघड मोठ्या files
का: Disk failures आणि full disks apps थांबवतात.
काय करायचं: फक्त त्या filesystem वर /srv खाली 2G पेक्षा मोठ्या files.
- हे काम करणारा Linux command शोधा.
- Task ला लागणारे options (उदा. -r, -h) जोडा.
- File नावं, folders किंवा users योग्य क्रमाने लिहा.
- System files/users बदलत असाल तर sudo वापरा. Check answer दाबा.
अवघड Deleted पण open
का: Disk failures आणि full disks apps थांबवतात.
काय करायचं: /srv filesystem वरच्या deleted-पण-open files.
- हे काम करणारा Linux command शोधा.
- Task ला लागणारे options (उदा. -r, -h) जोडा.
- File नावं, folders किंवा users योग्य क्रमाने लिहा.
- System files/users बदलत असाल तर sudo वापरा. Check answer दाबा.
20. संबंधित chapters
- DevOps साठी Linux Ops Refresh
- Automation साठी Bash Scripting
- Linux grep आणि find Commands Examples सह
- Linux Servers मध्ये Passwordless SSH
थोडक्यात सांगायचं तर
- RAID 0/1/5/6/10 speed, जागा आणि safety ची देवाणघेवाण.
- mdadm --create, --detail, /proc/mdstat.
- बदल: --fail, --remove, --add, rebuild बघा.
- mdadm.conf save आणि initramfs rebuild.
- df filesystem, du -x folder, find file.
- Deleted-open files साठी lsof +L1; inodes साठी df -i.
उजळणी, तुलना आणि मुलाखत cards
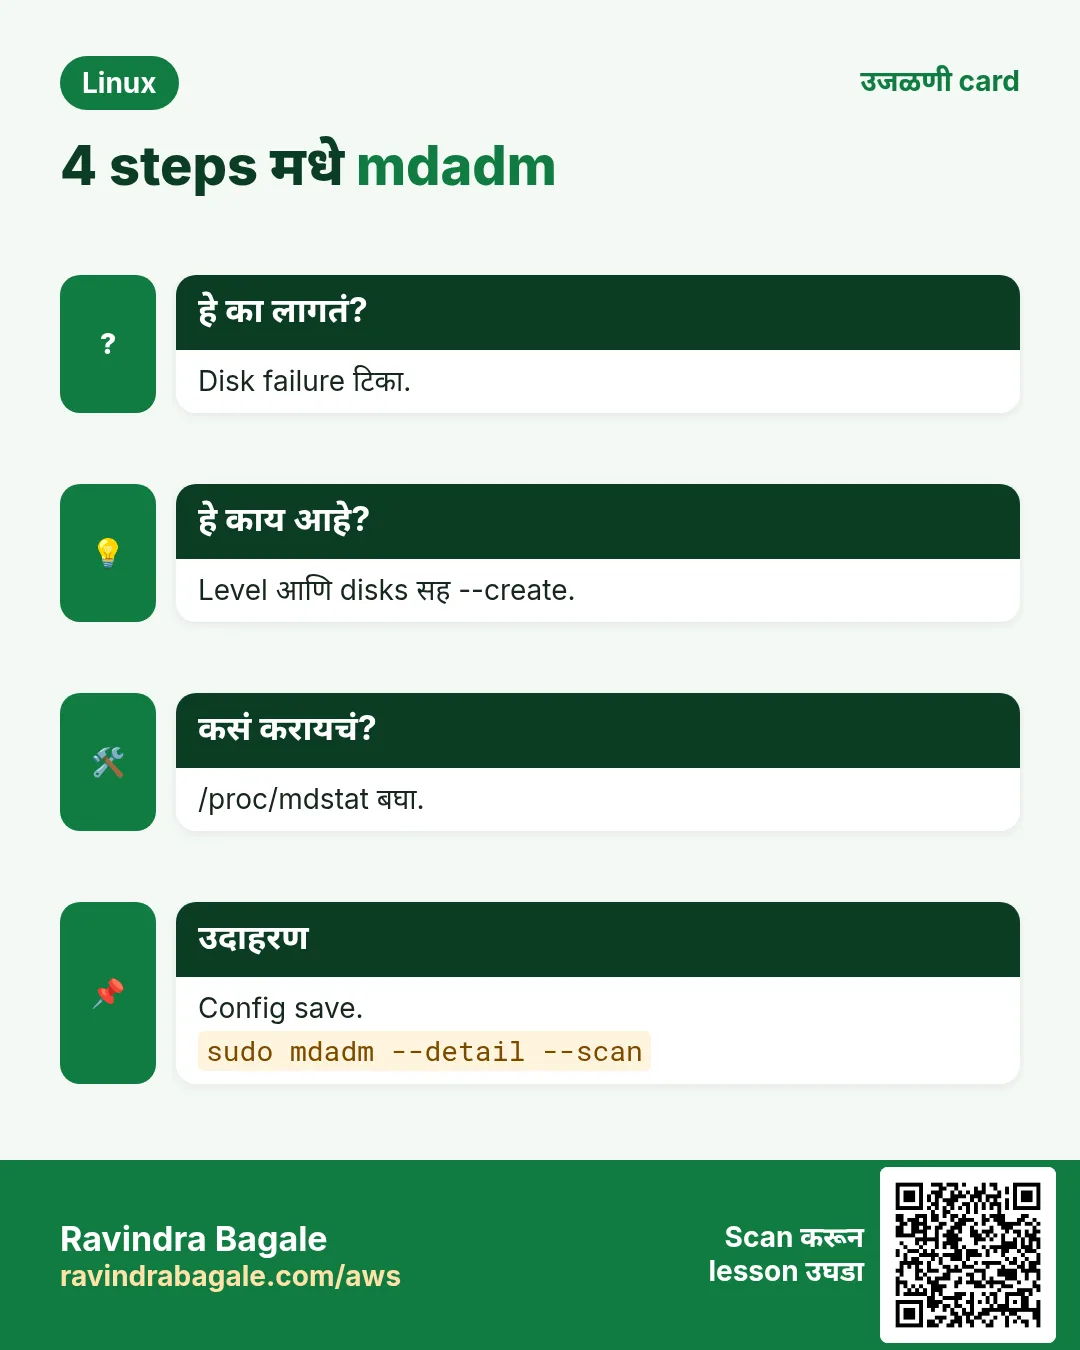
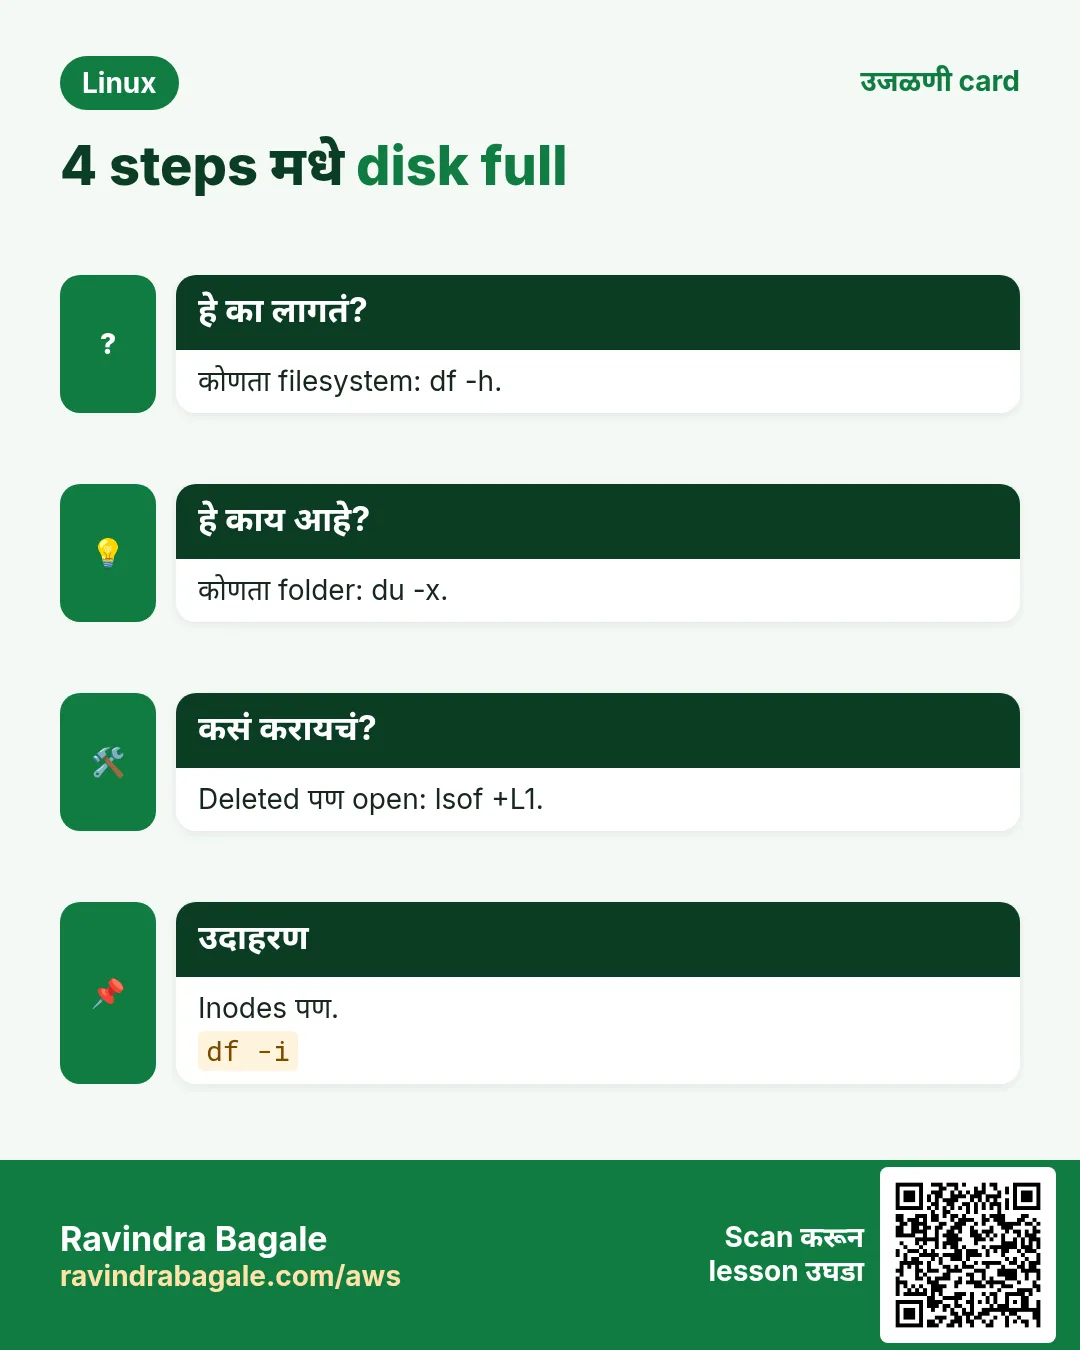
हा lesson काही मिनिटांत revise करा. Cards phone वर save करा किंवा PNG download करा. प्रत्येक card वरचा QR हा lesson उघडतो.
अजून cards: Ravi Sir's Cards.