Amazon DynamoDB म्हणजे काय? NoSQL vs RDS MySQL
तुम्ही EC2 सोबत RDS MySQL वापरलं. Tables, rows, JOINs, fixed schema. अनेक serverless apps ना दुसरं store हवं: single-digit ms reads, patch करायचा server नाही, आणि requests नुसार bill. ते Amazon DynamoDB. हा chapter NoSQL vs RDS आणि keys शिकवतो.
या chapter मध्ये तुम्ही काय शिकाल
- NoSQL vs RDS MySQL सोप्या शब्दांत
- Table, item, attribute, partition key, sort key
- चांगली key कशी निवडायची
- On-demand vs provisioned pricing
- DynamoDB कधी आणि RDS कधी
1. गोष्ट: फुगलेली attendance sheet
College app प्रत्येक "I am present" tap MySQL table मध्ये लिही. Festival दिवशी दहा मिनिटांत 40,000 taps. RDS CPU 100%. त्या दिवशी JOINs नको होते — student id आणि date ने keyed fast writes हवे होते.
Attendance DynamoDB वर: partition key studentId, sort key date. Writes partitions वर पसरले. Festival वाचला.
2. DynamoDB म्हणजे काय?
हे का लागतं?
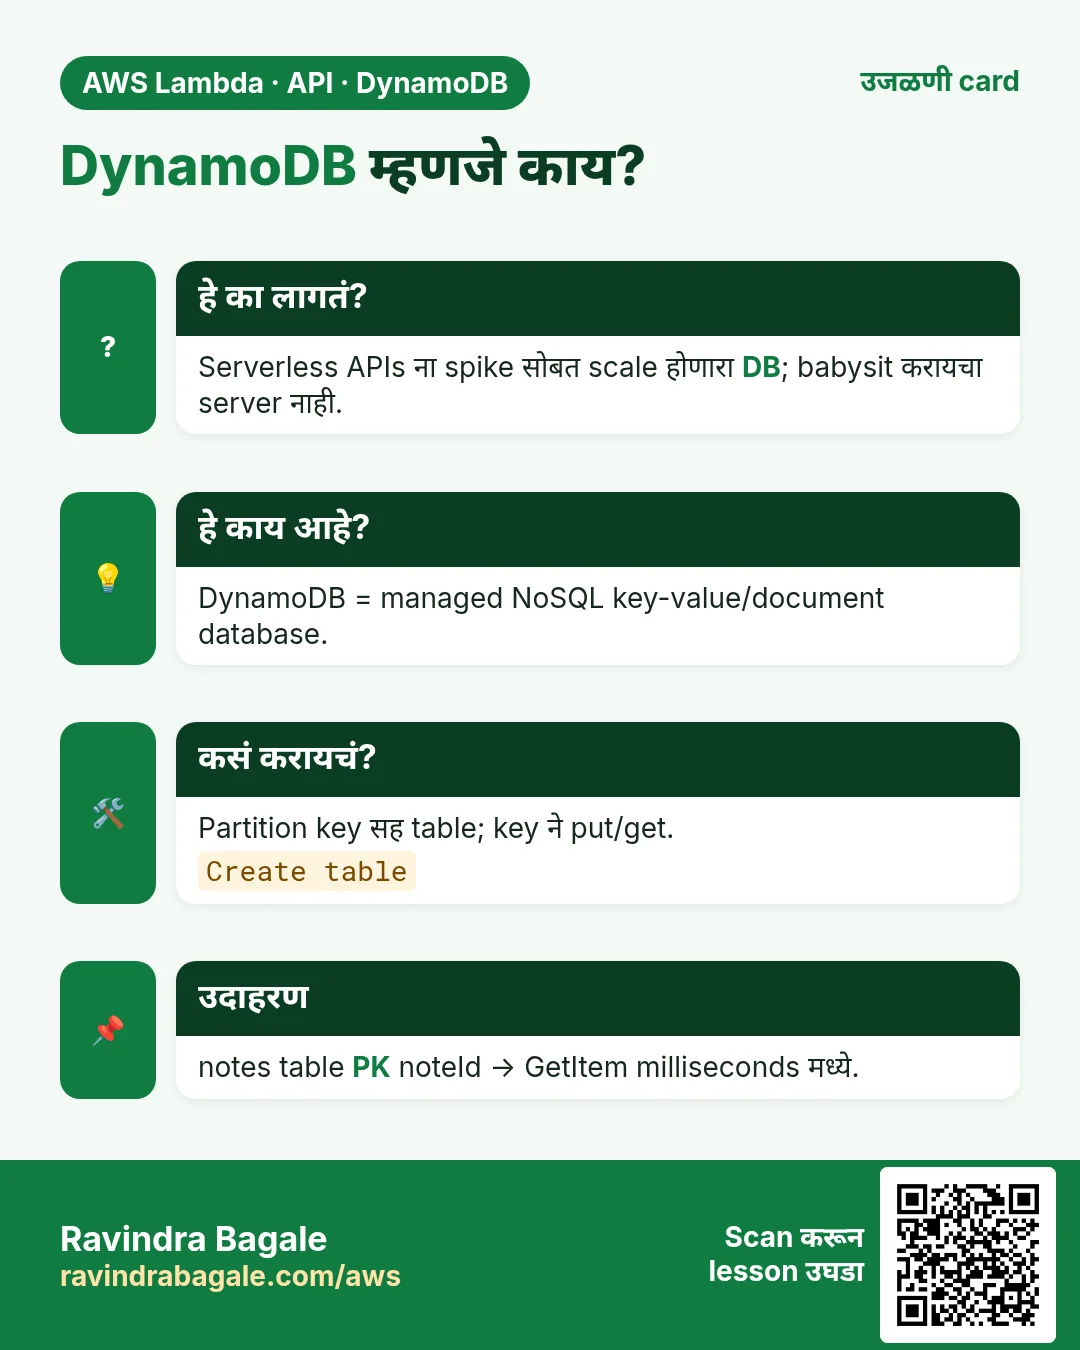
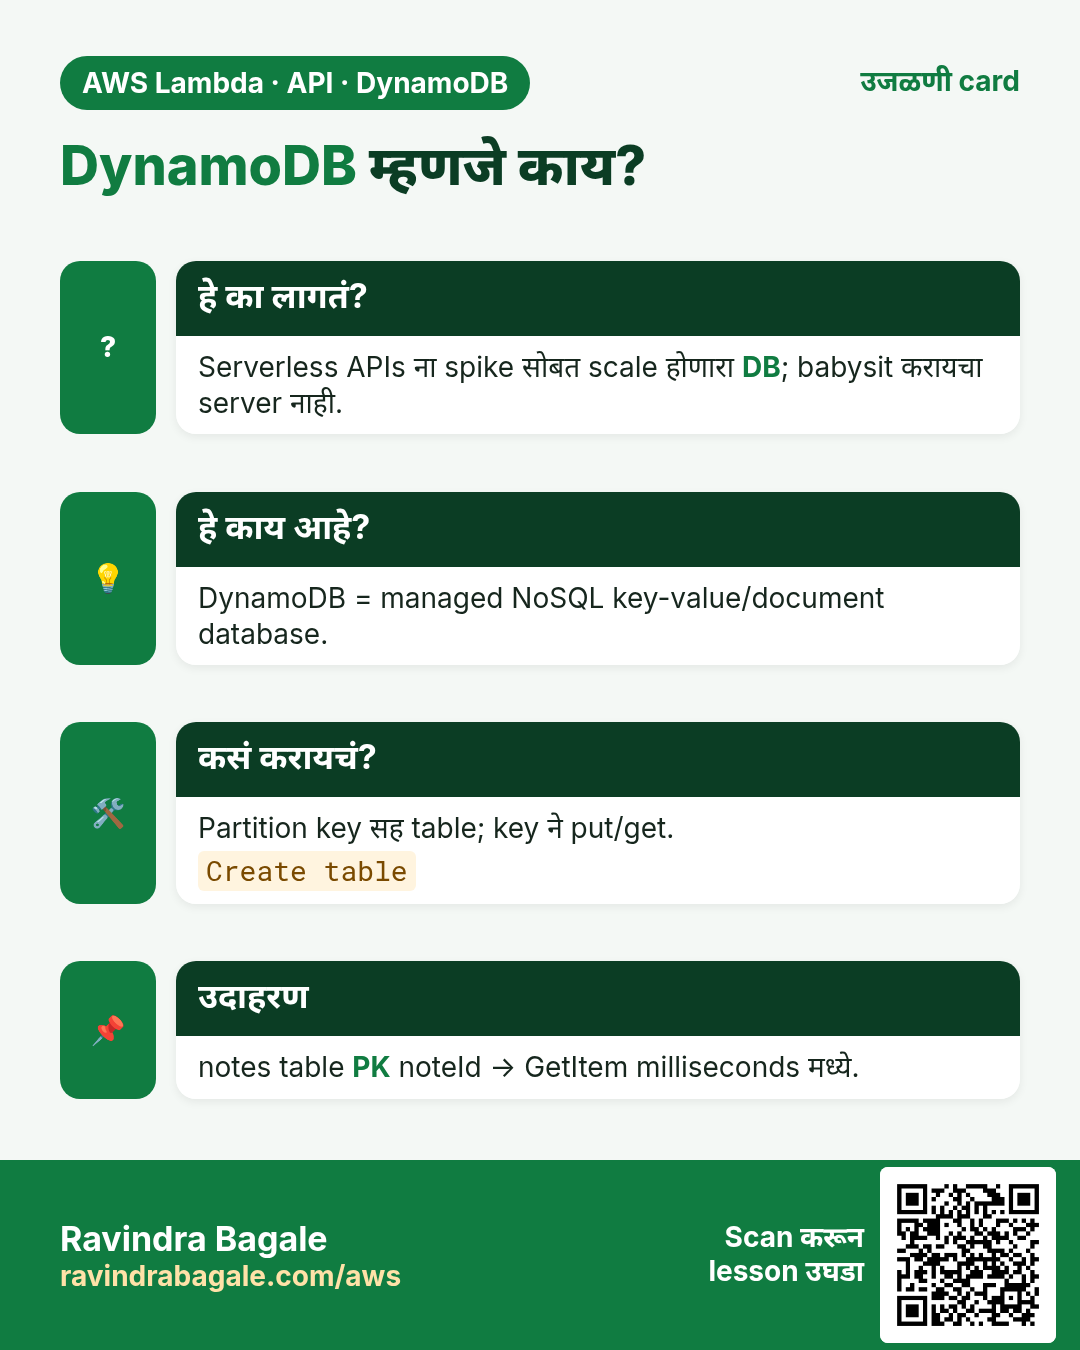
Serverless APIs ना असा database हवा जो Lambda सोबत scale होईल आणि रात्री 2 ला instance size विचारणार नाही.
हे काय आहे?
Amazon DynamoDB ही fully managed NoSQL key-value आणि document database. Table बनवा, keys ठरवा, मग Put/Get/Query. Disks, replicas, partitioning AWS करते.
| Word | अर्थ | MySQL नाते |
|---|---|---|
| Table | एकाच key schema चे items | Table |
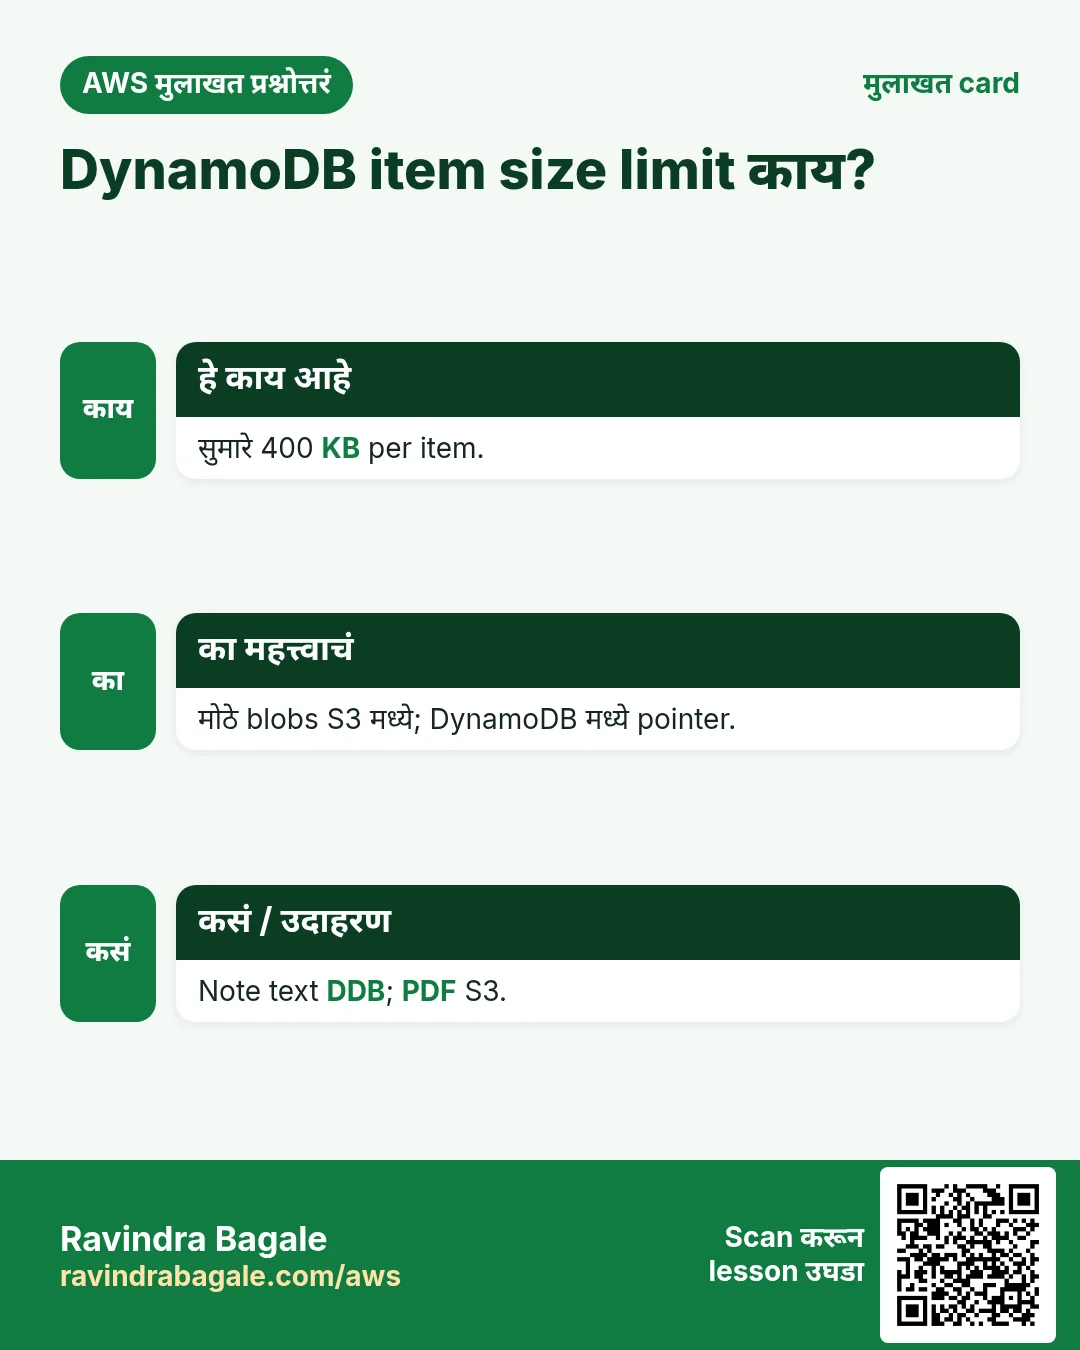
| Item | एक record (400 KB पर्यंत) | Row |
| Attribute | Item वरील field; एका table मध्ये items वेगळे असू शकतात | Column (पण लवचिक) |
| Partition key (PK) | Required; item कोणत्या partition मध्ये | Shard key सारखं |
| Sort key (SK) | Optional; एका PK चे items sort | थेट जोडीदार नाही |
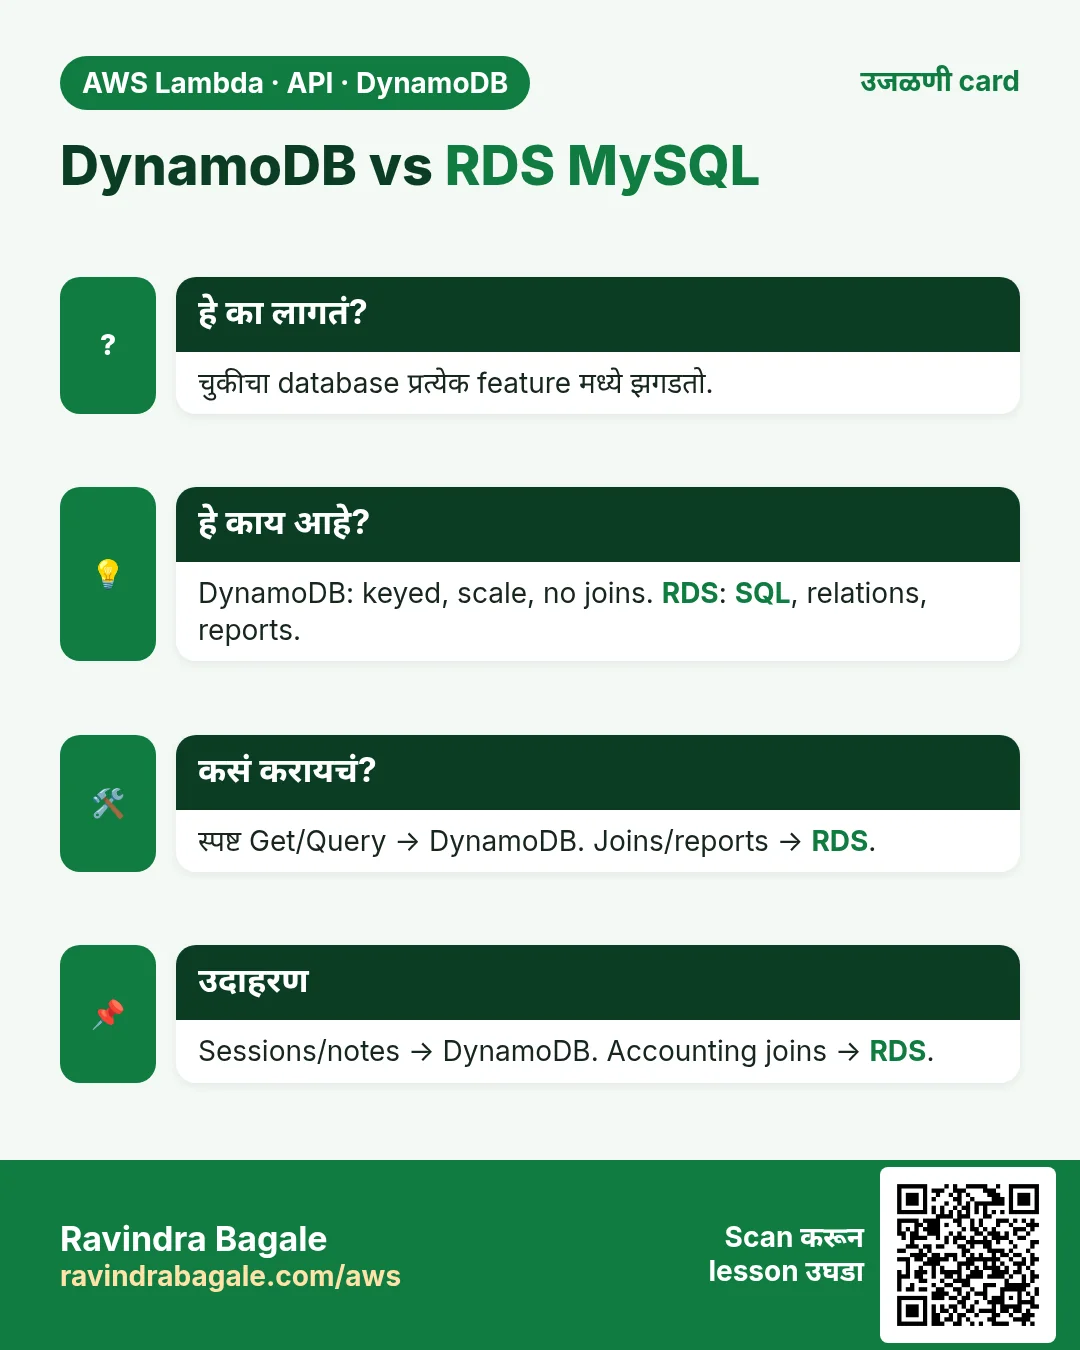
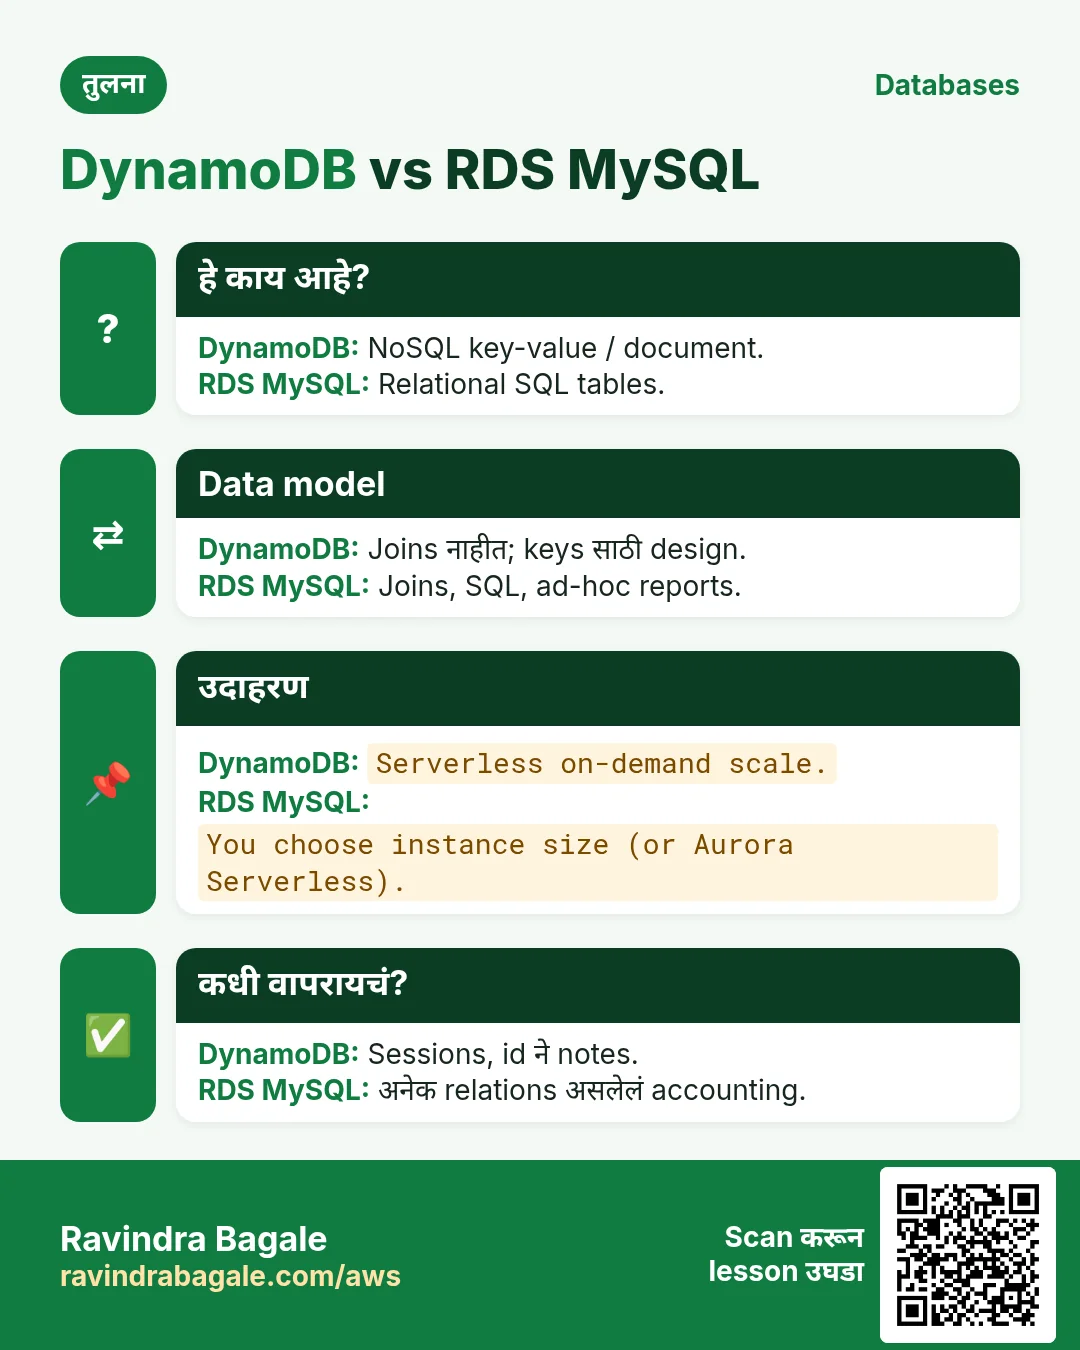
3. NoSQL vs RDS MySQL
| Topic | DynamoDB | RDS MySQL |
|---|---|---|
| Schema | Item नुसार लवचिक attributes | Fixed columns + migrations |
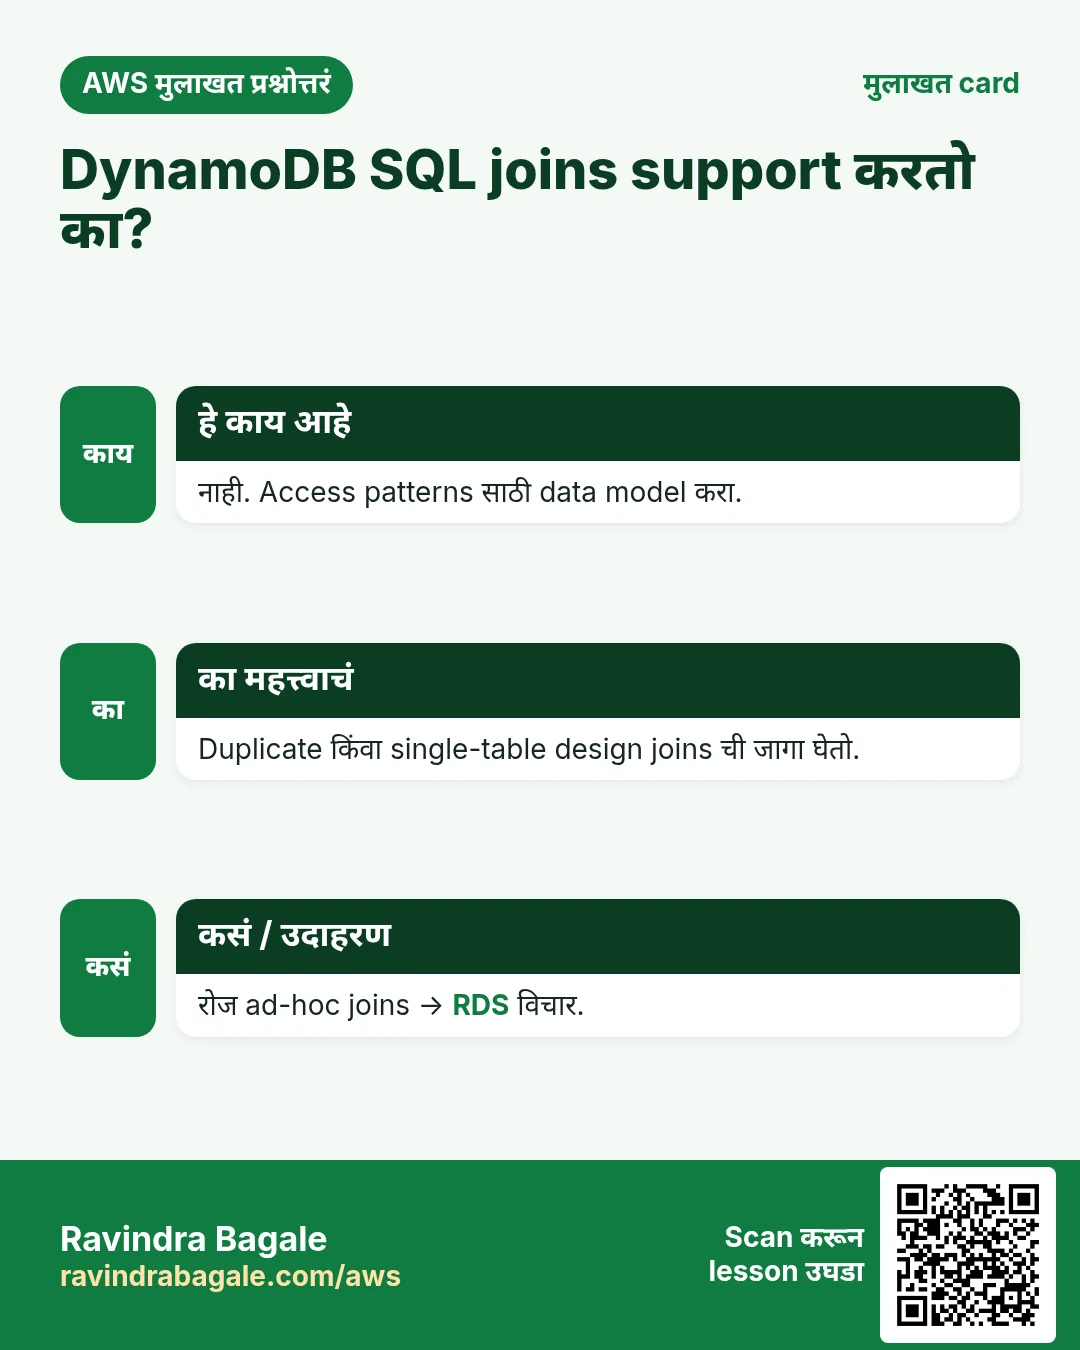
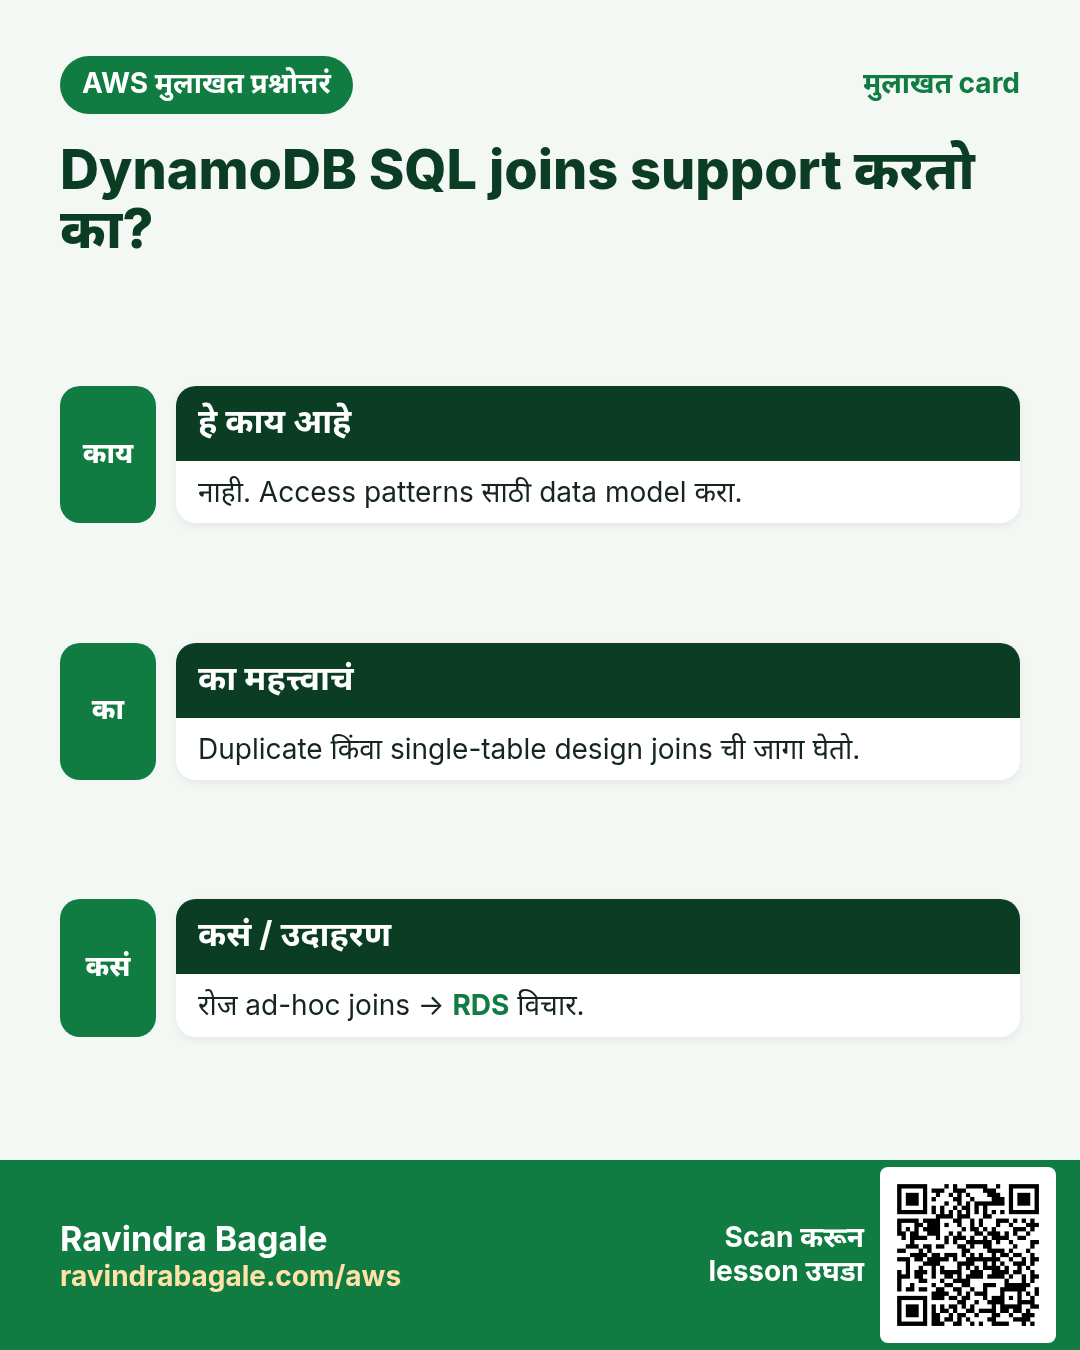
| Joins | Joins नाही — access patterns नुसार model | JOINs सामान्य |
| Scaling | Partitions; on-demand किंवा provisioned | Vertical instance + read replicas |
| Server management | काही नाही | Class, patch, storage तुम्ही |
| Query style | Key ने GetItem/Query; Scan महाग | SQL SELECT WHERE कुठेही |
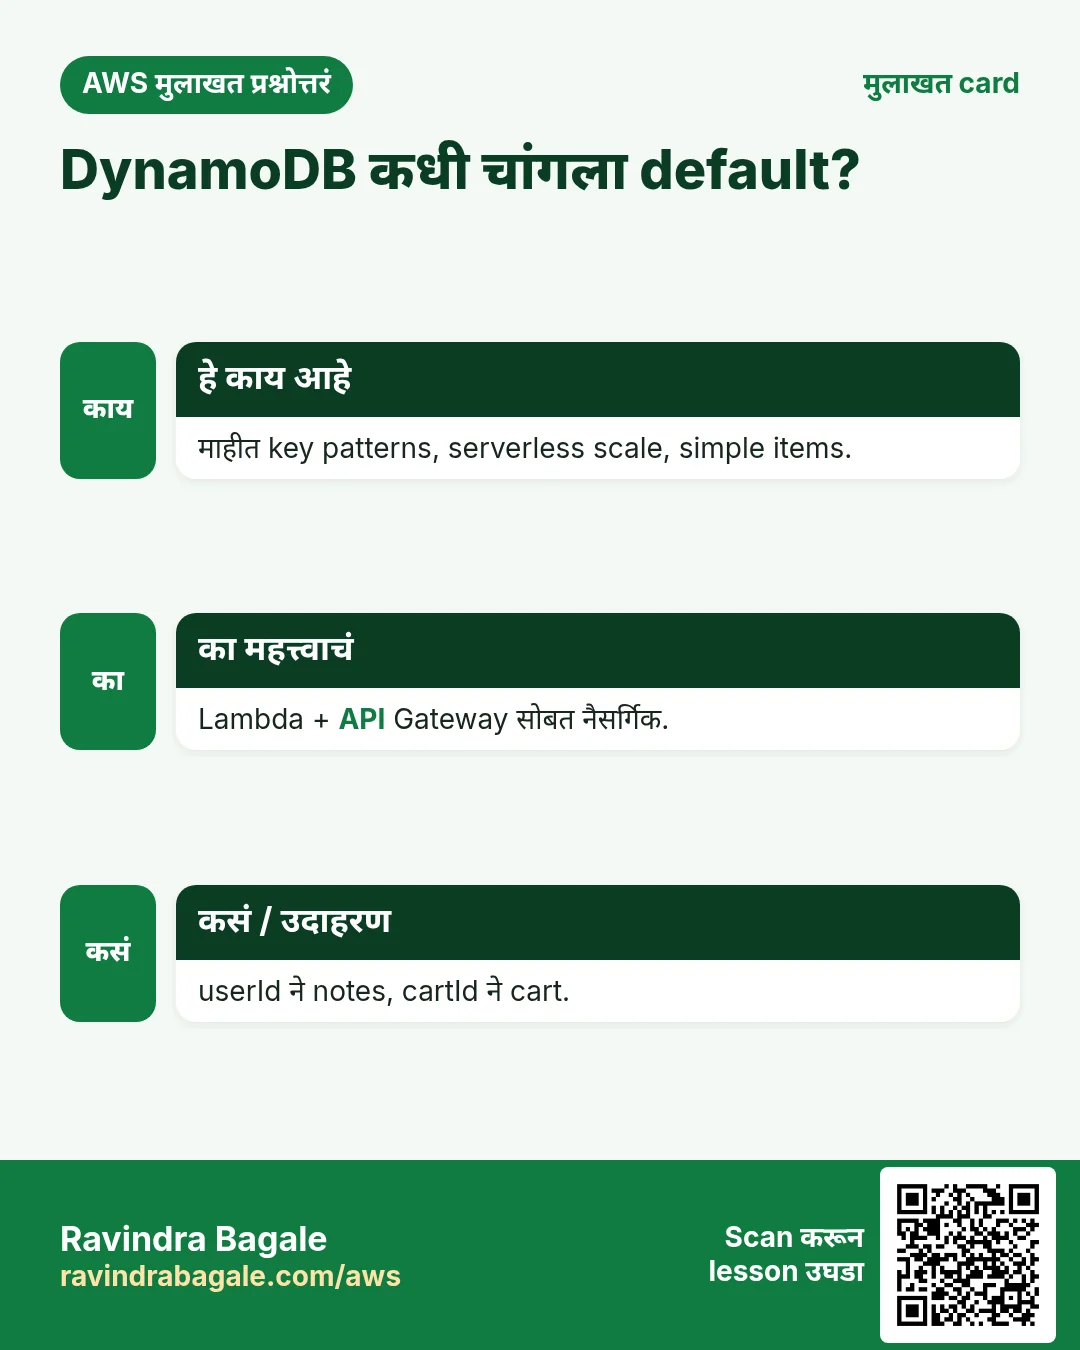
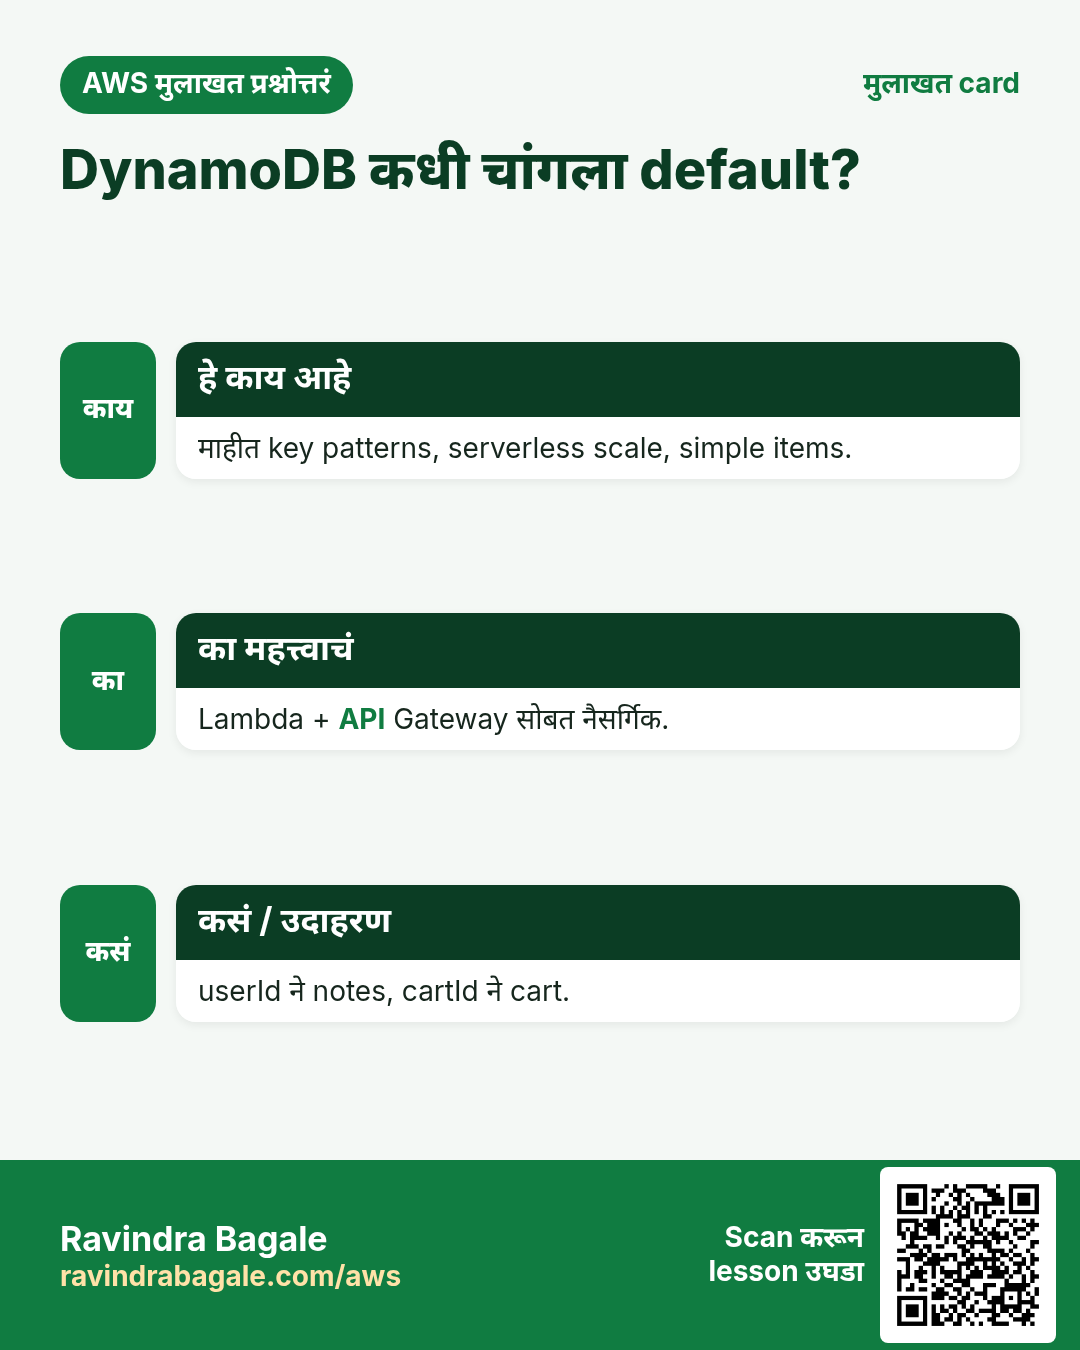
| Best fit | माहीत access patterns, high scale, serverless | Ad-hoc reports, जटिल relations |
Ravindra Bagale's Tip
Table design आधी तुमचे top 5 queries लिहू शकत नसाल तर RDS ने सुरू करा — किंवा आधी access patterns वर वेळ द्या.
4. चांगली key कशी निवडायची
हे का लागतं?
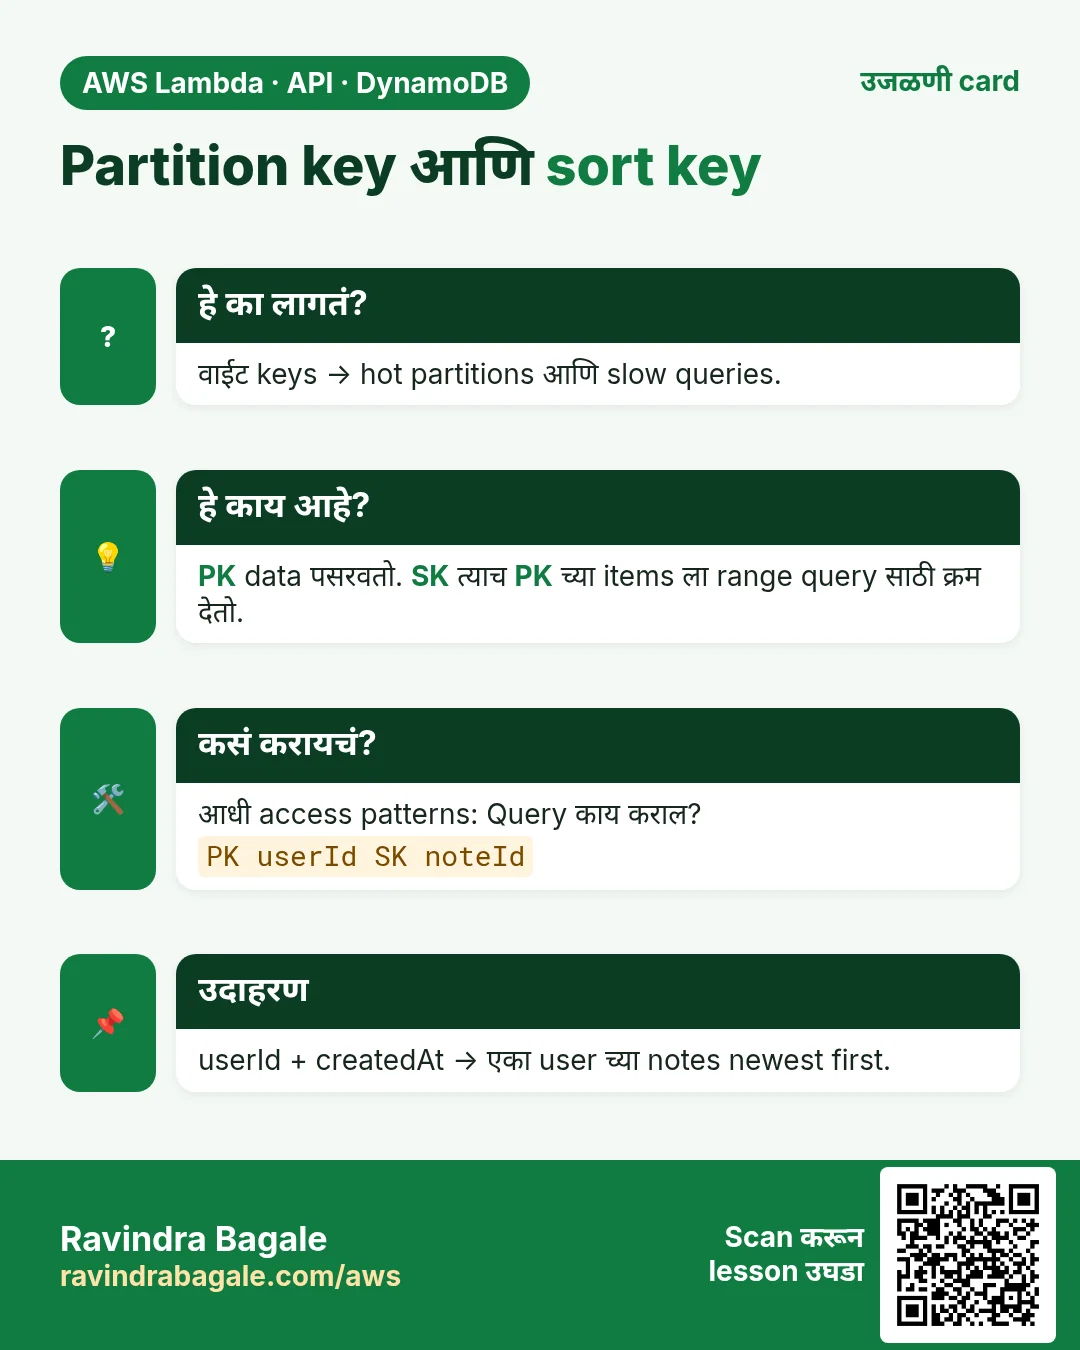
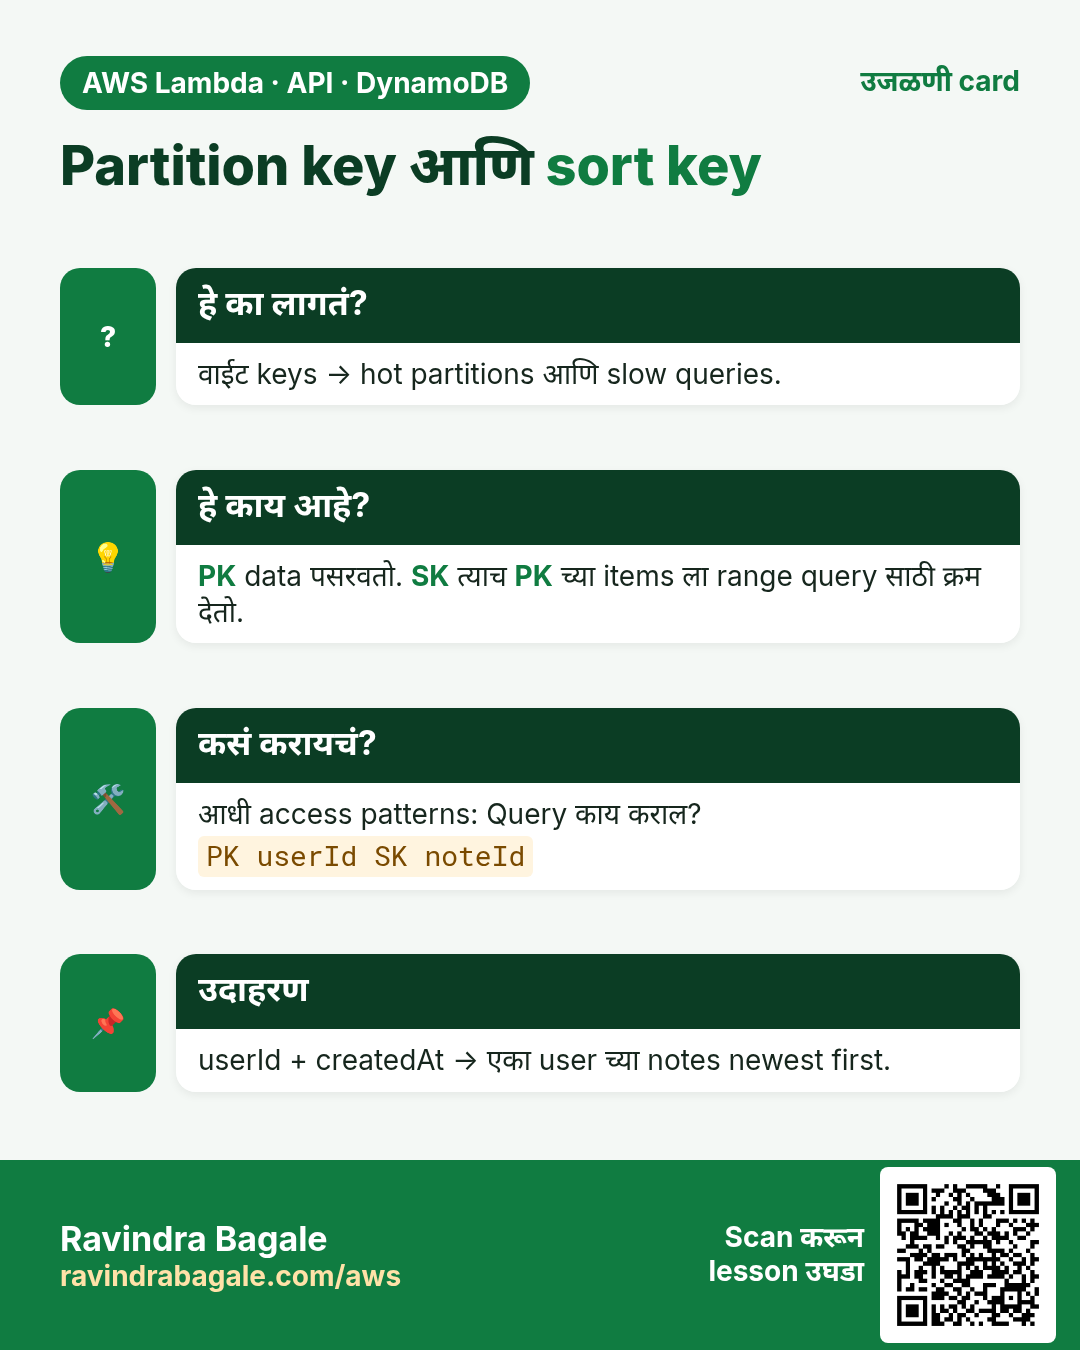
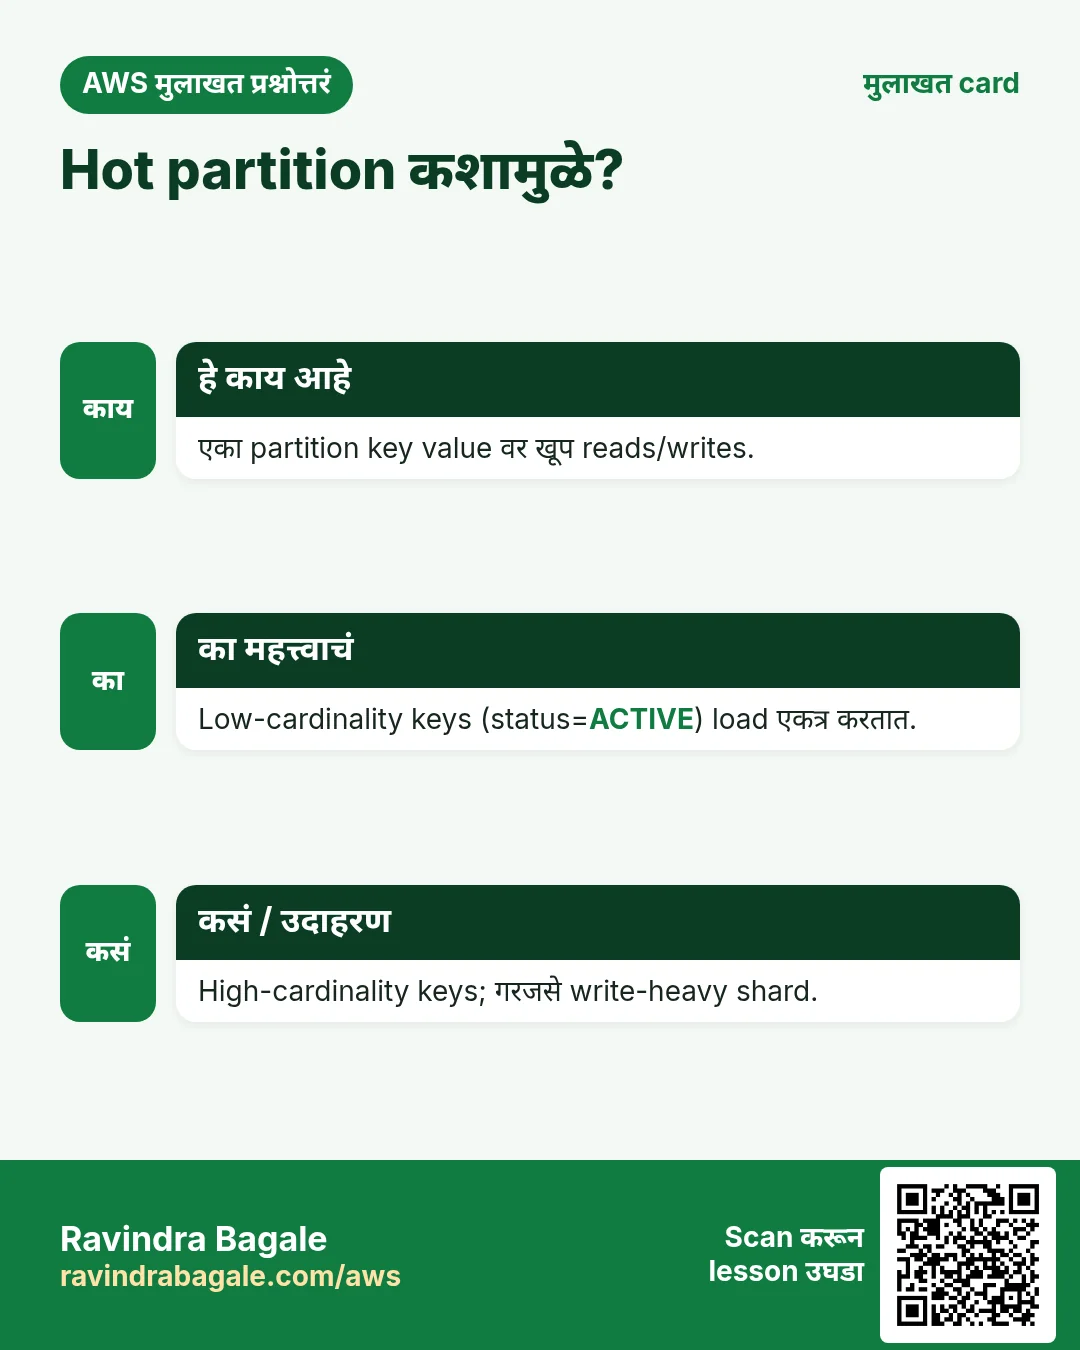
Partition key load पसरवते. वाईट key (फक्त "ALL" किंवा प्रत्येक write ला आजची date) hot partition आणि throttling देते.
हे काय आहे?
- High cardinality PK: अनेक वेगळ्या values (userId, orderId, deviceId).
- एका PK खाली range हवं असेल तर sort key (time ने messages, number ने versions).
- High-write table साठी एकच constant PK वापरू नका.
- उदा. attendance: PK
studentId, SKYYYY-MM-DD→ एका student चा महिना = Query.
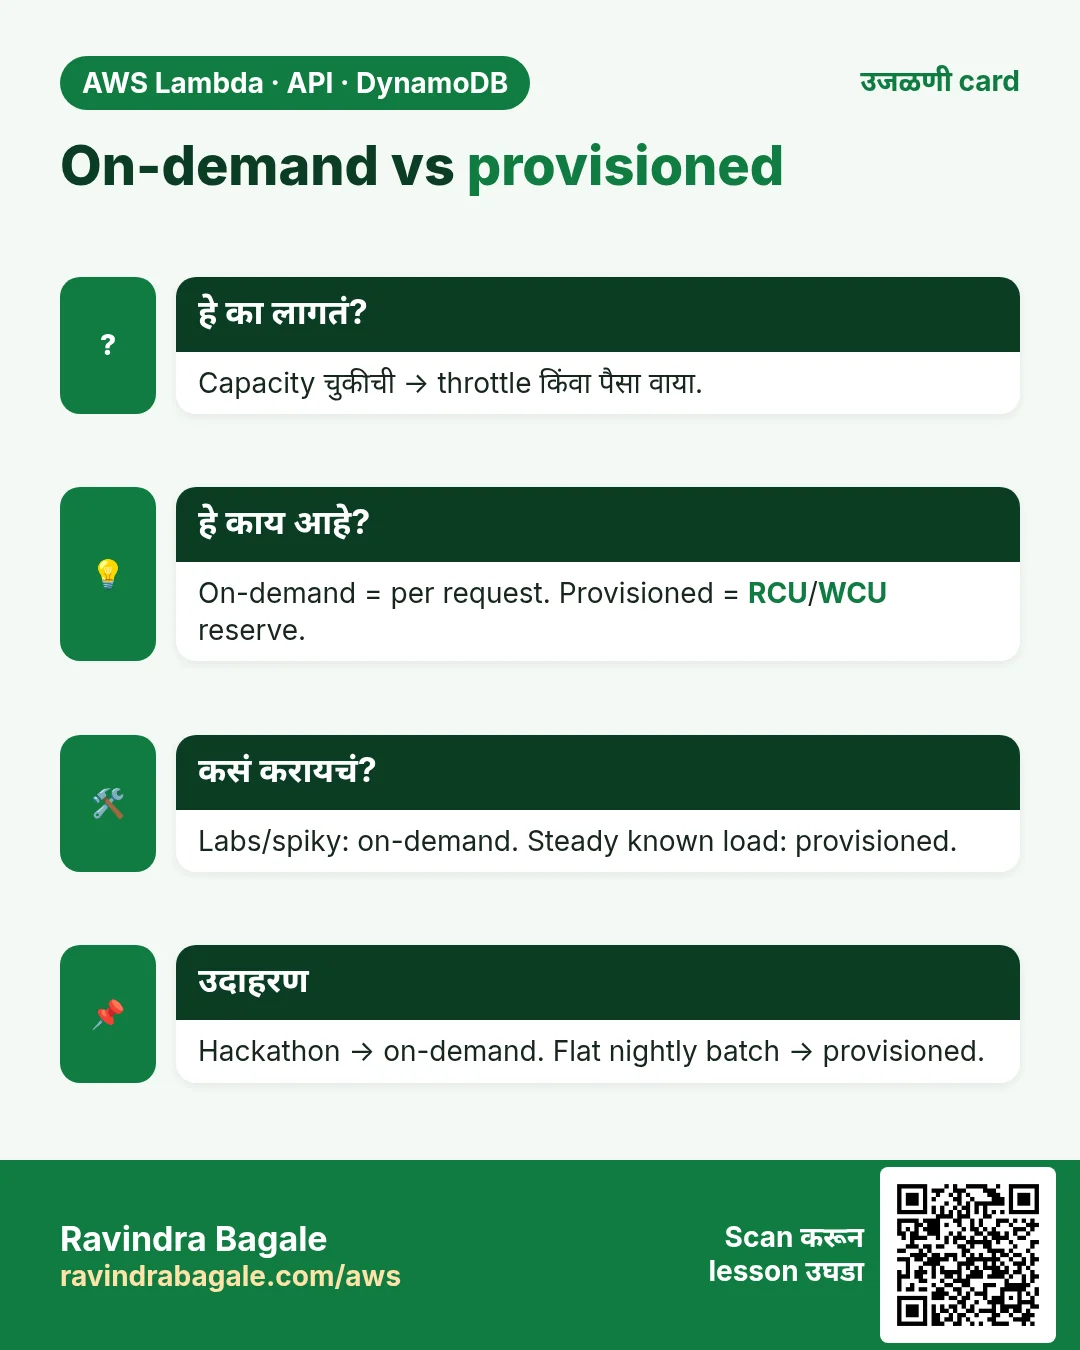
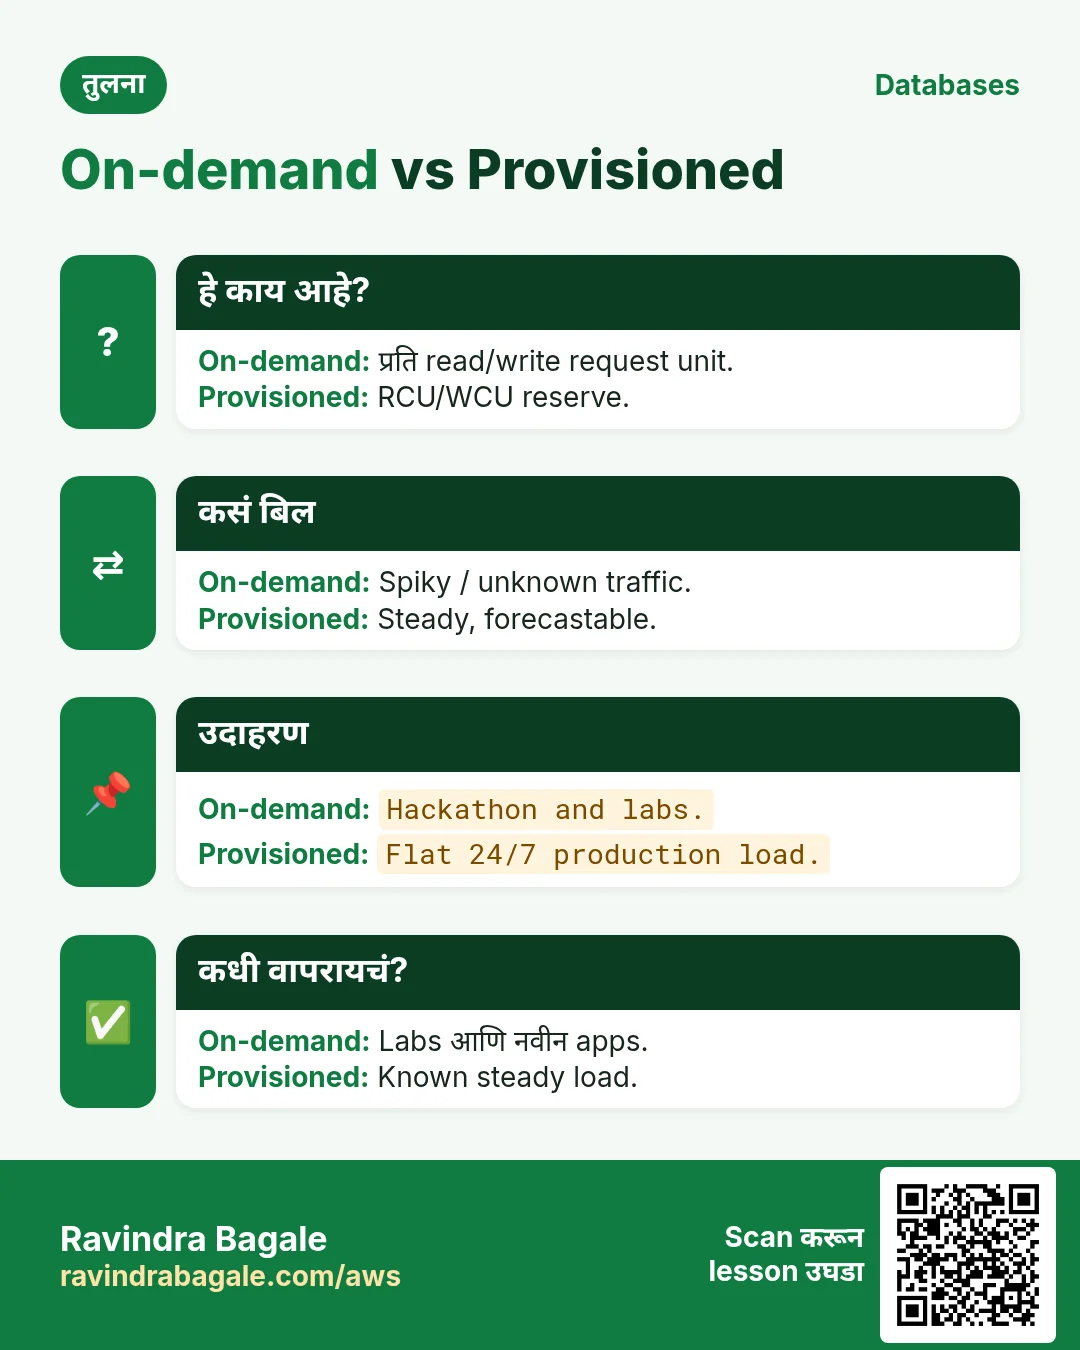
5. On-demand vs provisioned
हे का लागतं?
Capacity mode ठरवतं कसे पैसे आणि traffic forecast करायची गरज आहे का.
हे काय आहे?
| Mode | कशाचे पैसे | कधी निवडा |
|---|---|---|
| On-demand | प्रत्येक read/write request unit | Spiky, नवीन, अज्ञात traffic; कमी ops |
| Provisioned | तासाला provisioned RCU/WCU (idle असले तरी) | Steady, forecast करता येणारा traffic |
नवीन आणि student projects: on-demand ने सुरू. Graphs सपाट आणि utilization जास्त राहिल्यावर provisioned (बहुतेक auto scaling सह).
6. DynamoDB कधी vs RDS कधी
- DynamoDB: session stores, id ने profiles, device+time IoT, carts, स्पष्ट keys असलेल्या serverless apps.
- RDS: अनेक ad-hoc filters चे reports, अनेक tables वर strong relations, SQL tools, जटिल cross-entity transactions.
- कधी दोन्ही: hot API साठी DynamoDB, analytics साठी RDS/Redshift (Streams/ETL).
7. Lab: console मध्ये table बनवा
कसं करायचं (step by step)
- DynamoDB → Tables → Create table. Name:
AttendanceLab. - Partition key:
studentId(String). Sort key:date(String). का: एक student, अनेक dates. - Table settings: On-demand. Create. Status = Active होईपर्यंत थांबा.
- Explore items → Create item. studentId
S001, date2026-10-23, present = true. Create. - S001 साठी 2026-10-22 वर दुसरं item. PK S001 ने Query — दोन्ही. Scan पण चालतो पण नंतर महाग.
Cleanup
- Table
AttendanceLabdelete.
8. Interview questions
प्र. DynamoDB म्हणजे?
Managed NoSQL key-value/document DB, कोणत्याही scale ला single-digit ms.
प्र. PK vs SK?
PK required, items पसरवतो. SK optional, त्याच PK चे items क्रम आणि range query.
प्र. On-demand vs provisioned?
On-demand प्रति request; provisioned तासाला reserved capacity.
प्र. Scan टाळा का?
Scan पूर्ण table/index वाचतो; तपासलेल्या प्रत्येक item चे पैसे. Key ने Query.
प्र. Random admin reports असलेल्या blog साठी?
बहुतेक RDS — लवचिक SQL. Keys स्पष्ट आणि traffic प्रचंड असेल तर public read साठी DynamoDB.
घरी करून बघा
- Chat app: room मधले messages time ने. कागदावर PK/SK लिहा.
- फक्त PK orderId असलेली OrdersLab on-demand table बनवून तीन items टाका.
थोडक्यात सांगायचं तर
- DynamoDB = managed NoSQL; keys आणि access patterns भोवती design.
- PK data पसरवते; SK एका PK खाली क्रम.
- Spiky/अज्ञात = on-demand; steady forecast = provisioned.
- Rich SQL/relations = RDS; keyed high-scale serverless = DynamoDB.
सराव Tasks
Mumbai Dabba Express हा मुंबई मधला फूड डिलिव्हरी व्यवसाय आहे. Tukaram Gaikwad त्यांचं IT व cloud काम पाहतात. त्यांचे पैसे INR मध्ये मोजले जातात आणि AWS resources ap-south-1 Region मध्ये चालतात. खालच्या tasks मध्ये तुम्ही या lesson मध्ये शिकलेलं वापरून त्यांची खरी कामं करता. सगळी नावं, account IDs, IP addresses व numbers सरावासाठी काल्पनिक आहेत.
0 / 12
सोपं मोठ्या orders आधी
का: RDS setup नंतर database query करणं रोजचं काम.
काय करायचं: Order id व amount, मोठी amount आधी.
Tables: customers(id, name, city) व orders(id, customer_id, amount, odate).
- Task कोणत्या table बद्दल आहे ते पाहा (box वरची table list).
- SQL statement step by step लिहा: काय, कुठून, कोणते rows.
- Statement ; ने संपवा.
- Check answer दाबा. Query table च्या practice copy वर चालते.
सोपं City नुसार customers
का: RDS setup नंतर database query करणं रोजचं काम.
काय करायचं: Pune मधल्या customers ची नावं.
Tables: customers(id, name, city) व orders(id, customer_id, amount, odate).
- Task कोणत्या table बद्दल आहे ते पाहा (box वरची table list).
- SQL statement step by step लिहा: काय, कुठून, कोणते rows.
- Statement ; ने संपवा.
- Check answer दाबा. Query table च्या practice copy वर चालते.
सोपं Database endpoint शोधा
का: App endpoint नावाने connect होतं, IP ने नाही.
काय करायचं: DB instance mumbaidabba-db describe करा.
- Task वाचा आणि ते कोणत्या AWS service बद्दल आहे ते ठरवा.
- aws लिहा, मग service चं नाव, मग operation (action शब्द).
- प्रत्येक आवश्यक flag (--name) व त्यापुढे task मधली value लिहा.
- Flags कोणत्याही क्रमाने चालतात. Check answer दाबा.
मध्यम एकूण sales
का: RDS setup नंतर database query करणं रोजचं काम.
काय करायचं: सगळ्या order amounts ची बेरीज.
Tables: customers(id, name, city) व orders(id, customer_id, amount, odate).
- Task कोणत्या table बद्दल आहे ते पाहा (box वरची table list).
- SQL statement step by step लिहा: काय, कुठून, कोणते rows.
- Statement ; ने संपवा.
- Check answer दाबा. Query table च्या practice copy वर चालते.
मध्यम Customer नावांसह orders
का: RDS setup नंतर database query करणं रोजचं काम.
काय करायचं: प्रत्येक customer नाव व order amount.
Tables: customers(id, name, city) व orders(id, customer_id, amount, odate).
- Task कोणत्या table बद्दल आहे ते पाहा (box वरची table list).
- SQL statement step by step लिहा: काय, कुठून, कोणते rows.
- Statement ; ने संपवा.
- Check answer दाबा. Query table च्या practice copy वर चालते.
मध्यम लहान orders काढा
का: RDS setup नंतर database query करणं रोजचं काम.
काय करायचं: 200 पेक्षा कमी amount चे orders delete.
Tables: customers(id, name, city) व orders(id, customer_id, amount, odate).
- Task कोणत्या table बद्दल आहे ते पाहा (box वरची table list).
- SQL statement step by step लिहा: काय, कुठून, कोणते rows.
- Statement ; ने संपवा.
- Check answer दाबा. Query table च्या practice copy वर चालते.
मध्यम City दुरुस्त करा
का: RDS setup नंतर database query करणं रोजचं काम.
काय करायचं: Customer 5 Rome ला गेले. Record update करा.
Tables: customers(id, name, city) व orders(id, customer_id, amount, odate).
- Task कोणत्या table बद्दल आहे ते पाहा (box वरची table list).
- SQL statement step by step लिहा: काय, कुठून, कोणते rows.
- Statement ; ने संपवा.
- Check answer दाबा. Query table च्या practice copy वर चालते.
मध्यम Multi-AZ सुरू करा
का: Multi-AZ दुसऱ्या AZ मध्ये standby ठेवतो व आपोआप failover करतो.
काय करायचं: mumbaidabba-db Multi-AZ करा व बदल लगेच लागू करा.
- Task वाचा आणि ते कोणत्या AWS service बद्दल आहे ते ठरवा.
- aws लिहा, मग service चं नाव, मग operation (action शब्द).
- प्रत्येक आवश्यक flag (--name) व त्यापुढे task मधली value लिहा.
- Flags कोणत्याही क्रमाने चालतात. Check answer दाबा.
अवघड Customer नुसार sales
का: RDS setup नंतर database query करणं रोजचं काम.
काय करायचं: Customer नुसार total, फक्त 1000 पेक्षा जास्त.
Tables: customers(id, name, city) व orders(id, customer_id, amount, odate).
- Task कोणत्या table बद्दल आहे ते पाहा (box वरची table list).
- SQL statement step by step लिहा: काय, कुठून, कोणते rows.
- Statement ; ने संपवा.
- Check answer दाबा. Query table च्या practice copy वर चालते.
अवघड Orders नसलेले customers
का: RDS setup नंतर database query करणं रोजचं काम.
काय करायचं: कधीच order न केलेल्या customers ची नावं.
Tables: customers(id, name, city) व orders(id, customer_id, amount, odate).
- Task कोणत्या table बद्दल आहे ते पाहा (box वरची table list).
- SQL statement step by step लिहा: काय, कुठून, कोणते rows.
- Statement ; ने संपवा.
- Check answer दाबा. Query table च्या practice copy वर चालते.
अवघड MySQL database बनवा
का: RDS database तुमच्यासाठी चालवतं: backups, patches व failover managed.
काय करायचं: RDS instance mumbaidabba-db बनवा: engine mysql, class db.t3.micro, 20 GiB storage, master user admin, master password $DB_PASS मधून.
- Task वाचा आणि ते कोणत्या AWS service बद्दल आहे ते ठरवा.
- aws लिहा, मग service चं नाव, मग operation (action शब्द).
- प्रत्येक आवश्यक flag (--name) व त्यापुढे task मधली value लिहा.
- Flags कोणत्याही क्रमाने चालतात. Check answer दाबा.
अवघड Read replica बनवा
का: Read replicas reports व read traffic main database वरून कमी करतात.
काय करायचं: Source mumbaidabba-db पासून mumbaidabba-db-ro read replica बनवा.
- Task वाचा आणि ते कोणत्या AWS service बद्दल आहे ते ठरवा.
- aws लिहा, मग service चं नाव, मग operation (action शब्द).
- प्रत्येक आवश्यक flag (--name) व त्यापुढे task मधली value लिहा.
- Flags कोणत्याही क्रमाने चालतात. Check answer दाबा.
उजळणी, तुलना आणि मुलाखत cards
हा lesson काही मिनिटांत revise करा. Cards phone वर save करा किंवा PNG download करा. प्रत्येक card वरचा QR हा lesson उघडतो.
अजून cards: Ravi Sir's Cards.